Memory和RAG的区别在哪?用「上下文工程」做出个性化 AI(谷歌白皮书精读) (opens in a new tab)
谷歌在第三天发布了《上下文工程:会话与记忆》(Context Engineering: Sessions & Memory) 白皮书。文中开篇指出,LLM模型本身是无状态的 (stateless)。如果要构建有状态的(stateful)和个性化的 AI,关键在于上下文工程。
Total 85 articles
谷歌在第三天发布了《上下文工程:会话与记忆》(Context Engineering: Sessions & Memory) 白皮书。文中开篇指出,LLM模型本身是无状态的 (stateless)。如果要构建有状态的(stateful)和个性化的 AI,关键在于上下文工程。
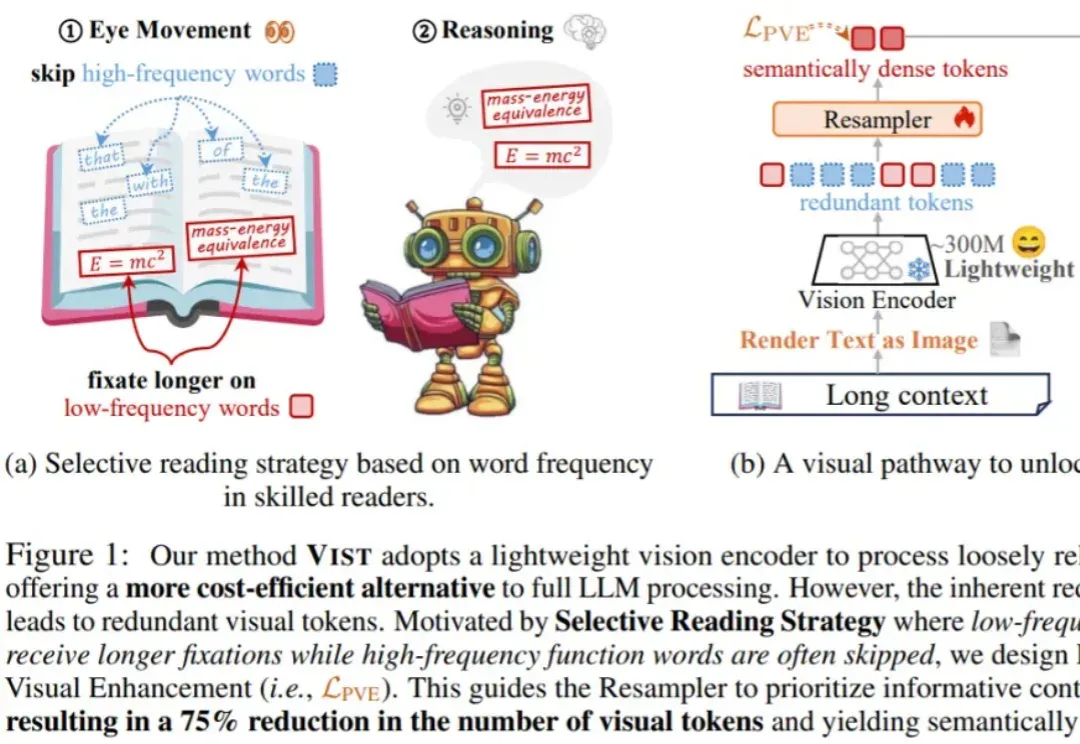
在处理短文本时,大语言模型(LLM)已经表现出惊人的理解和生成能力。但现实世界中的许多任务 —— 如长文档理解、复杂问答、检索增强生成(RAG)等 —— 都需要模型处理成千上万甚至几十万长度的上下文。
如果你也在做 RAG 或智能体应用,大概经历过这些瞬间:文档切得太碎,答案失去上下文;切得太大,又召回不准;加了更多提示词,效果可能更不稳定。
是孩子该看的东西。 「这是我的新项目,10 块 GPU,价值两万美元。」 全球最大的游戏主播,居然开始转型搞 AI 了,没过半天就获得了 100 万播放量。 上周末,PewDiePie 久违地发布了新视频,出乎人们预料的是,内容是在教你训练 AI 大模型。 在这个题为《STOP. Using AI Right now》(停。现在使用 AI)的新视频中,他解释了自己如何从零开始,通过添加搜索、记忆、RAG 和音频输出等功能,创建出个人专属的 ChatGPT 风格用户界面。 他还自己组装了一套硬件系统,共计 10 块英伟达 GPU,使用参数量从 700 亿到 2450 亿不等的大型语言模型,所有这
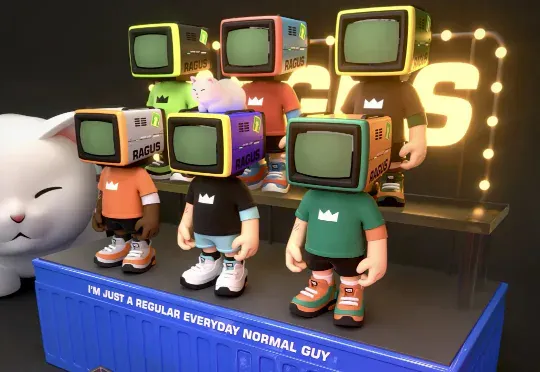
一家仅成立9个月的新公司——奇妙拉比MarveLab,在2025年8月推出的首款AI潮玩RAGUS&WHITE,凭借超过5000单的预售成绩,超200万的首发营收,迅速成为行业内的讨论热点。