基础模型已颠覆科研,进入第五范式!港科大综述113篇论文 | NeurIPS'25 (opens in a new tab)
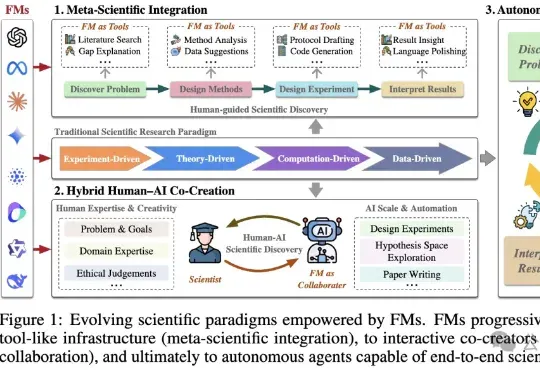
基础模型(FM)是一种在海量数据上训练的人工智能系统,具备强大的通用性和跨模态能力。港科大最新发表的论文显示:FM可能引领科学进入第五范式,但大模型的偏见、幻觉等问题仍需正视。
Total 86 articles
基础模型(FM)是一种在海量数据上训练的人工智能系统,具备强大的通用性和跨模态能力。港科大最新发表的论文显示:FM可能引领科学进入第五范式,但大模型的偏见、幻觉等问题仍需正视。
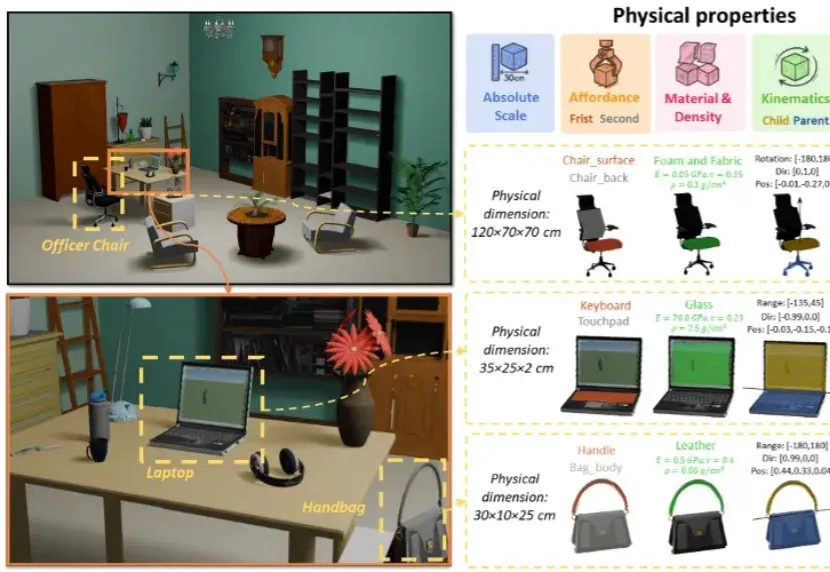
3D 生成正从纯虚拟走向物理真实,现有的 3D 生成方法主要侧重于几何结构与纹理信息,而忽略了基于物理属性的建模。
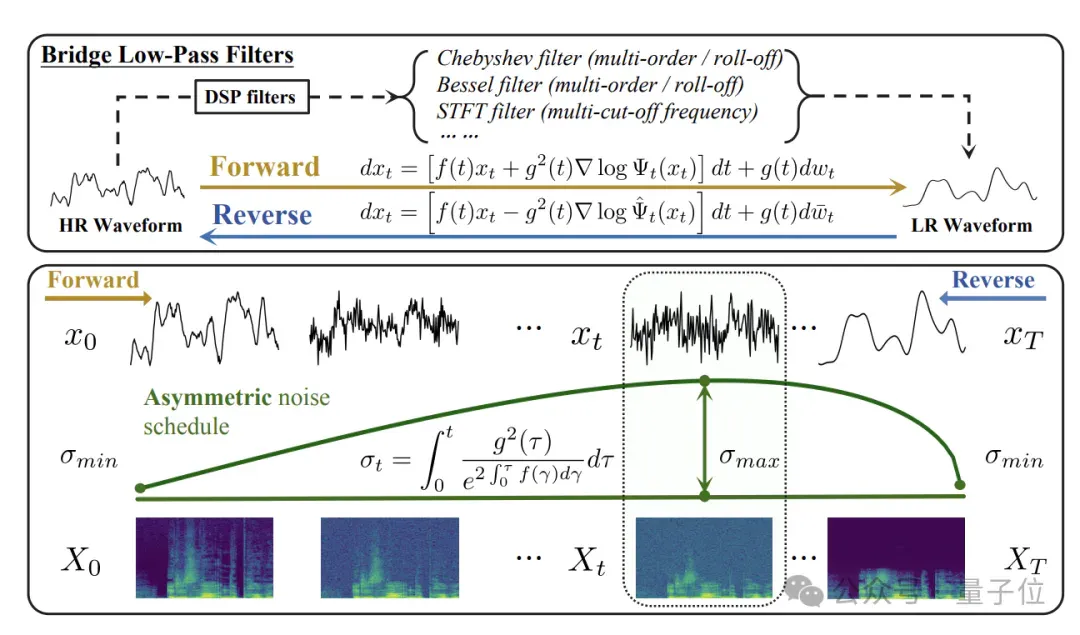
在这一背景下,清华大学与生数科技(Shengshu AI)团队围绕桥类生成模型与音频超分任务展开系统研究,先后在语音领域顶级会议ICASSP 2025和机器学习顶级会议NeurIPS 2025发表了两项连续成果:
在具身智能领域,视觉 - 语言 - 动作(VLA)大模型正展现出巨大潜力,但仍面临一个关键挑战:当前主流的有监督微调(SFT)训练方式,往往让模型在遇到新环境或任务时容易出错,难以真正做到类人般的泛化
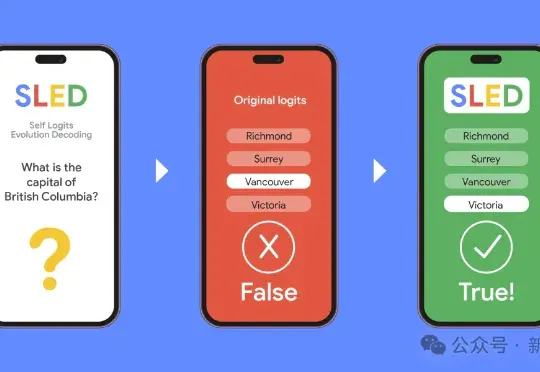
大模型最让人头疼的毛病,就是一本正经地「瞎编」。过去,只能靠检索补丁或额外训练来修。可在NeurIPS 2024 上,谷歌抛出的新方法SLED却告诉我们:模型其实知道,只是最后一步忘了。如果把每一层的「声音」都纳入考量,它就能从幻觉中被拉回到事实。
TC-Light 是由中科院自动化所张兆翔教授团队研发的生成式渲染器,能够对具身训练任务中复杂和剧烈运动的长视频序列进行逼真的光照与纹理重渲染,同时具备良好的时序一致性和低计算成本开销,使得它能够帮助减少 Sim2Real Gap 以及实现 Real2Real 的数据增强,帮助获得具身智能训练所需的海量高质量数据。