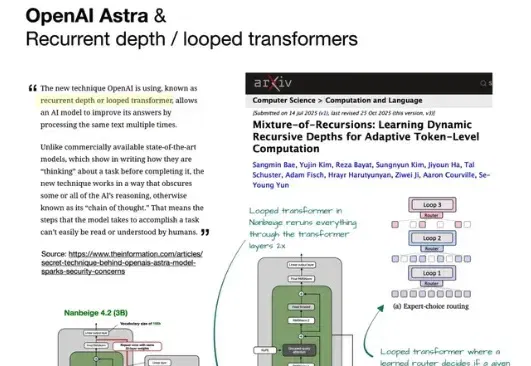
GPT-6 Astra真把「推理」拉开一代了:CoT越短反而越强,Recurrent Depth+No-CoT (opens in a new tab)
OpenAI这次真狠,GPT-6用起来有一种2023年GPT-4的感觉。
Total 1184 articles
OpenAI这次真狠,GPT-6用起来有一种2023年GPT-4的感觉。
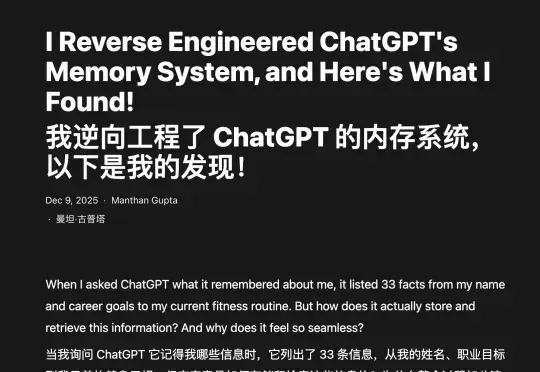
ChatGPT 号称是最有情商、越聊越懂你的 AI,但是,你有没有想过,它是怎么记住你的。昨天刷 X 的时候,我看到一个帖子。一个叫 Manthan Gupta 的开发者,做了一件挺疯狂的事。他花了好几天时间,通过对话实验逆向破解了 ChatGPT 的记忆系统。
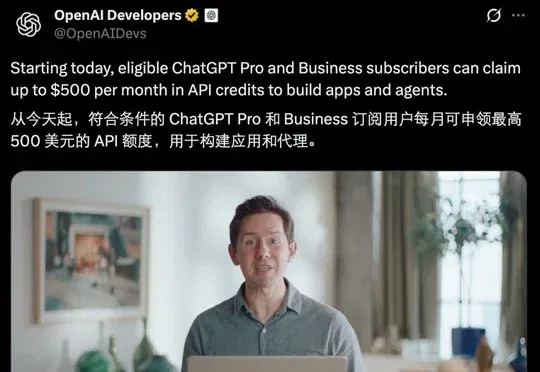
符合条件的 ChatGPT Pro 和 Business 订阅可激活 API 额度福利,每计费周期最高 500 美元,首次金额按剩余时长折算。额度到期不结转,也不会提高 ChatGPT 或登录式 Codex 的使用上限;实际资格与发放以账单页面和当期政策为准。
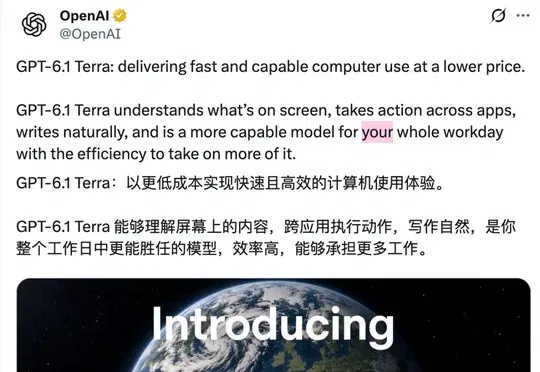
OpenAI发布GPT-6.1 Terra,每百万token输入1美元、输出5美元,较上代大幅降价,并强化视觉理解、写作和电脑操作;Agents’ Last Exam中追平GPT-6 Astra且速度快3倍以上,第三方评测幻觉率由88%降至38%,现已全面开放。
如今,AI正式杀入物理世界! 在具身能力方面,语言模型到底谁能称王? 更残酷的问题是,机器人公司耗费数年苦练的本领,会被通用LLM直接碾压吗? 就在今天,GPT-6 Astra、GPT-6.1 Sol、Claude Opus 5.5 以及 Gemini 4 Argon 等全球最顶尖的多模态大模型齐聚一堂。 在常态化具身智能仿真评测平台 RoboColiseum(机器人角斗场) 上,它们展开了一场真刀真枪的「肉搏战」。 这份榜单不仅彻底炒热了具身智能圈,更无情地揭露了当前顶尖大模型在控制机器人时的「隐藏命门」! 揭榜时刻:四模型大乱斗,结果令人意外 本次测试,所有的顶尖模型都接入了统一的控制框架
Claude,竟然排在最后? PhAI Labs 最新公布了一项 AI 研究能力对照,结合后续发表的科学文献,考察不同模型提出的研究假设能否为未来的研究思路与探索方向提供启发。报告所列的 Claude Opus 5 组对应比例为 2.3%,排在图中五个模型组的末位。GPT 组为 2.5%,GLM 为 2.8%,DeepSeek 为 5.4%。 排在最前面的,是 DiscoveryRSI:6.3%,约为 GPT 组的 2.5 倍、Claude 组的 2.7 倍。 图 1|五个模型组对未来研究的启发:DiscoveryRSI 总体比例为 6.3%。 这项比较观察的是:AI 提出的研究假设,能否在后
ChatGPT也学会「摇人」组队干活了!
近日,Manifold AI流形空间登顶机器人学习基准RoboDojo榜单(Agent Track),超越 GPT-6-Astra、英伟达 GR00T-N1.。其 WorldScape R²SI系统超过GPT-6-Astra、英伟达 GR00T-N1.7等模型,位列总榜第一。
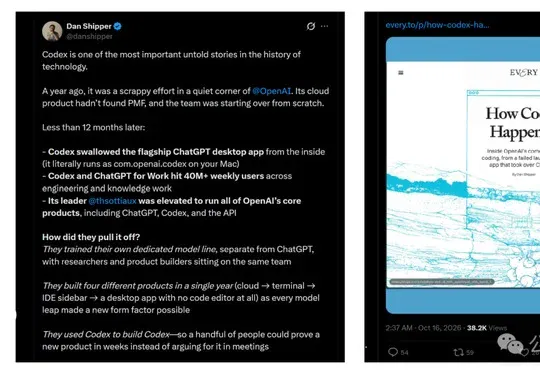
《How Codex Happened》首次披露Codex从首发遇冷、转向本地Agent并借GPT-5系列突围,最终成为ChatGPT桌面端底座,后续将重回云端并探索无固定界面的主动式Agent。
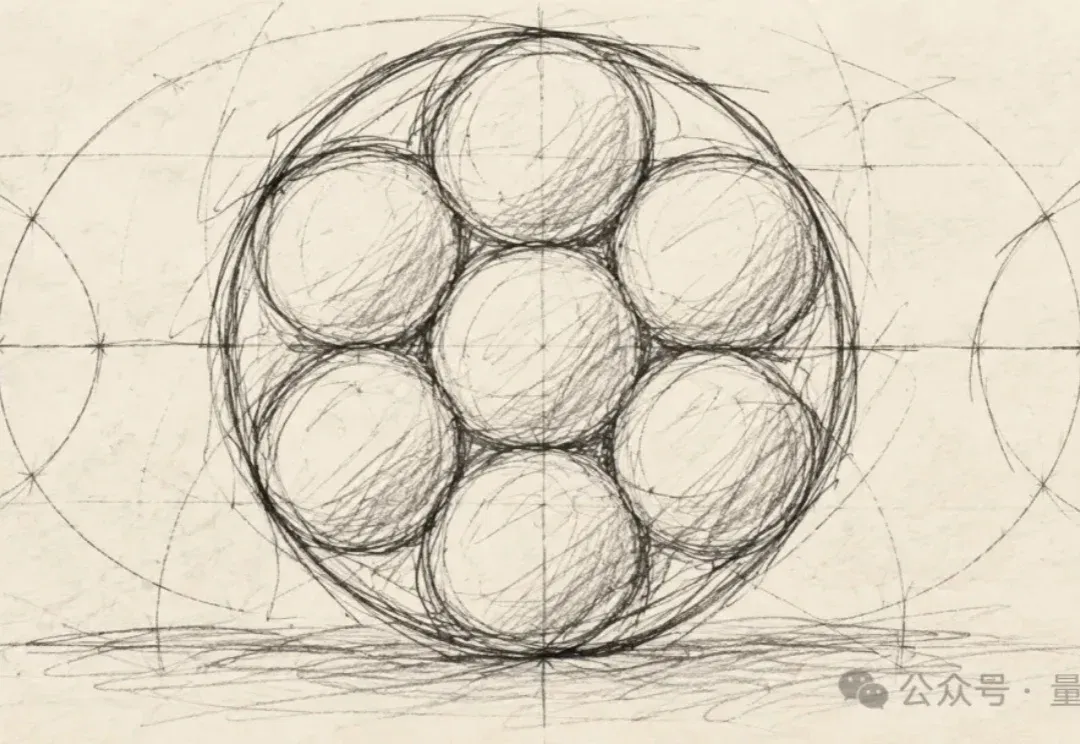
AI现在真是开启数学证明扫荡模式了。 刚刚,又有数学爱好者用GPT-6 Astra把一个57年数学难题推进了一大步。 问题听上去倒是不复杂: 给你N个半径为1的圆盘,怎么把它们塞进一个大圆里,才能让大圆的半径尽可能小? 事实上,数学家们也确实在1969年就给出了漂亮的排列方案,只不过……57年来,谁也没能严格证明那就是最优解。 于是这一次,数学爱好者nor掏出了GPT-6 Astra……然后一口气把15、16、17、18和20这5种情况,也就是N≤20的剩余情况都给严格证明了…… 此前,只有N≤14和N=19的情况已经得到验证。 啊对了,N到20,并不是AI的极限,只是nor没想着往下证了……