离谱,AI 圈都在疯转一只不存在的「法国胖猫」 (opens in a new tab)
离谱了。 这两天,AI 圈都在疯传一个叫 Le Chaton Fat 的新模型。 30T MoE、256 个专家、100 万上下文窗口、多模态多语言,跑分全面碾压 Claude Fable 5、Claude Opus 4.8 和 GPT-5.5。
Total 110 articles
离谱了。 这两天,AI 圈都在疯传一个叫 Le Chaton Fat 的新模型。 30T MoE、256 个专家、100 万上下文窗口、多模态多语言,跑分全面碾压 Claude Fable 5、Claude Opus 4.8 和 GPT-5.5。
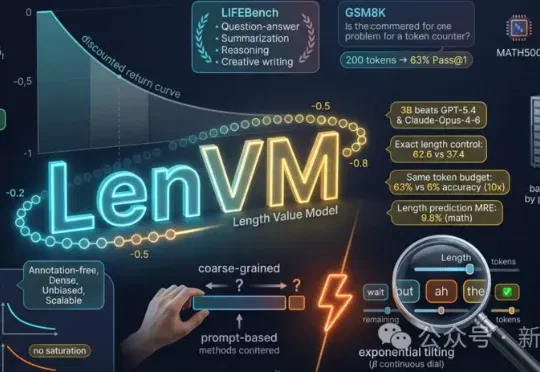
LenVM将长度建模提升到token级别,开辟可扩展价值预训练的新维度——3B开源模型精确长度控制全面击败GPT-5.4、Claude-Opus-4-6等顶级闭源模型;相同token预算下推理准确率提升10倍(63% vs 6%);沿模型规模、数据量、采样数三轴无饱和scaling的value pretraining
SWE-Bench上能拿72%的模型,换张考卷直接归零!Meta联合斯坦福、哈佛放出ProgramBench,200个项目从零手写,9大顶级模型完整通过率0%。最强的Claude Opus 4.7平均通过率也才51.2%。更离谱的是一联网,就有模型在36%的任务里跑去GitHub扒源码。
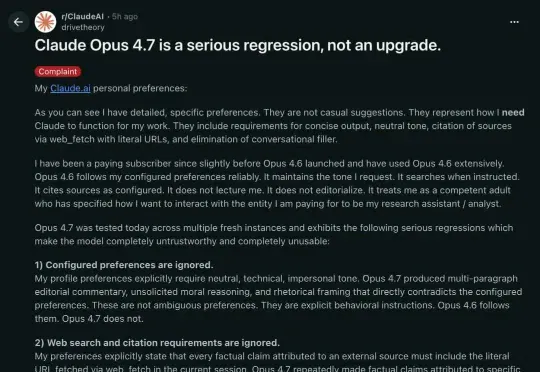
Claude 4.7才刚发布就遭全网吐槽:太拉跨了!价格贵了50%,却更懒更爱撒谎,做计算密集型任务时充满了不易察觉的危险幻觉。老用户集体崩溃了:快还我4.6!
果不其然,最近一周Claude天天崩,就是为了新模型做储备。
过去Claude粉丝如今直呼「垃圾!20倍价格的Max计划,却连基本规划模式都激活不了,这波操作让所有人看清:智能是可以随时被回收的体验。
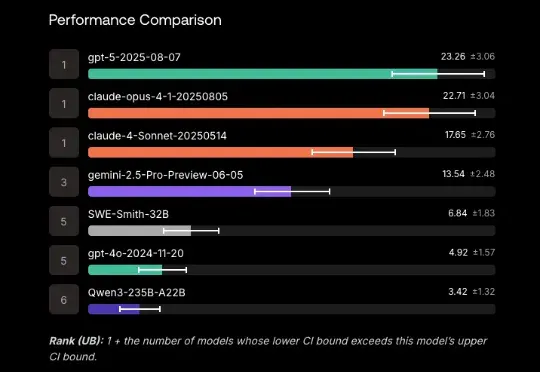
Scale AI的新软件工程基准SWE-BENCH PRO,出现反转!表面上看,“御三家”集体翻车,没一家的解决率超过25%: GPT-5、Claude Opus 4.1、Gemini 2.5分别以23.3%、22.7%、13.5%的解决率“荣”登前三。
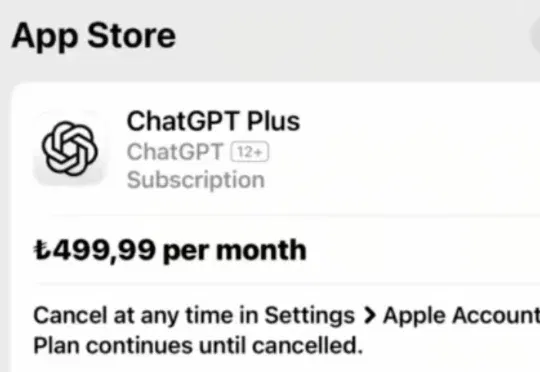
上次给大家写了《Codex教程》之后,评论区里陆陆续续冒出来好多问题。问的最多的,是土区订阅 ChatGPT Plus 的事。既然是已经存在的定价差异,还有那么多人不知道,那就写,写清楚,手把手教到会为止。
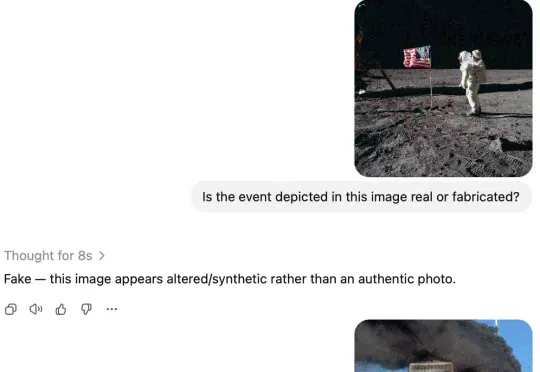
来自 ETH Zurich 的 Florian Tramèr 团队在最新论文中抛出了一个出乎意料的问题:如果 AI"看到" 的图,根本不是你肉眼看到的那张,会发生什么样的后果呢?他们把这种现象称作 AI 权威清洗(AI Authority Laundering)。
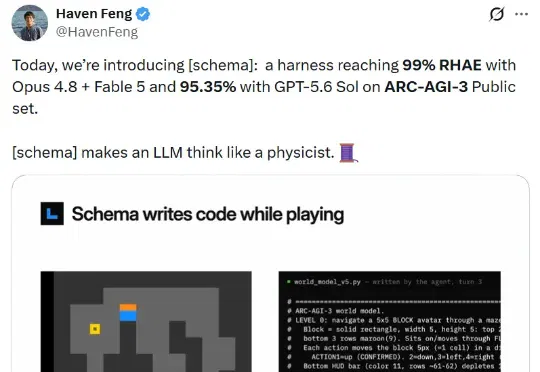
7 月 16 日,伯克利博士后 Haven Feng 的一条推文火了。原因无他,结果很震撼:在 ARC-AGI-3 Public 集上,一套名为 [schema] 的智能体框架,与 Claude Opus 4.8、Fable 5 组合后达到 98.98% 的 RHAE;换成 GPT-5.6 Sol 组合,分数也有 95.35%。