登顶GitHub Hacker News,这个开源项目让AI编程的成本降低98%|涌现新项目 (opens in a new tab)
除此之外,context-mode 将大模型的记忆力从30分钟提升至 3 小时。
Total 1000 articles
除此之外,context-mode 将大模型的记忆力从30分钟提升至 3 小时。
世界模型(World Model),正在成为AI领域新的技术高地。从OpenAI的Sora,到图灵奖得主Yann LeCun力推的JEPA体系,再到李飞飞创办的World Labs,全球最顶尖的一批研究者都在试图回答同一个问题:AI究竟如何像人一样理解世界,而不仅仅是生成语言和图像。
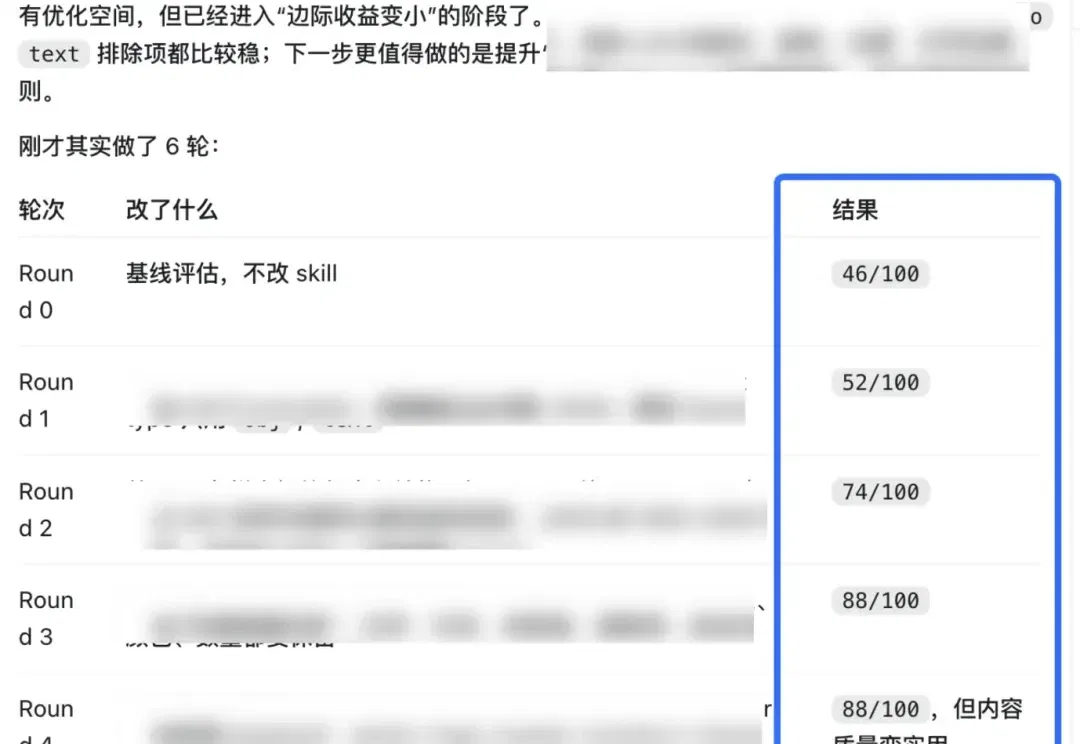
前几天我们讨论过一个观点:自从2026年Q2起,未来人类所谓的“编程工作”其实比拼的是「谁能一次性把“什么叫完成”定义清楚」
要说这段时间的热门 AI 产品,Codex 必然是绕不过去的话题。
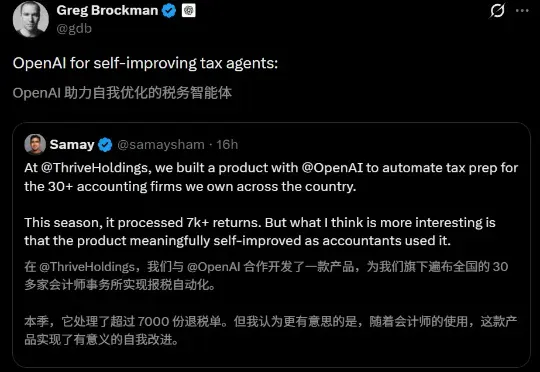
没人重训模型,没人重写代码,OpenAI的AI系统六周内自己把准确率从25%拉到86%。Codex自己定位bug、写修复、跑测试,AI自我进化已在生产环境跑起来了。
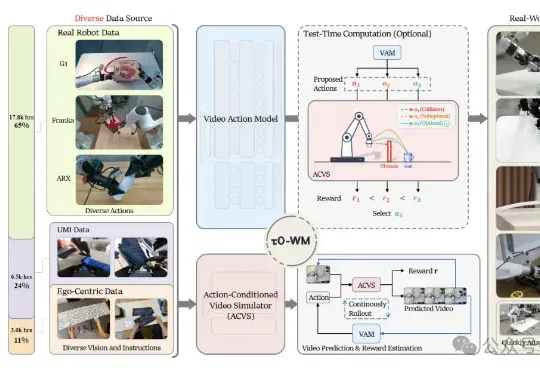
刚刚,上海创智学院副教授、智元机器人首席科学家罗剑岚带队,发布全球最大规模的开源预训练具身世界模型——τ0-World Model(τ0-WM)。整个τ0-WM参数量达到5B,预训练数据规模高达约3万小时。其中,真机遥操作数据第一次成了绝对主力,占到了1.78万小时。
7×24,AI也吃不消。 卡内基梅隆大学和马里兰大学发了篇论文,《Language Models Need Sleep》—— 大模型处理长上下文的时候,硬撑着不休息,真的会累傻。 这项研究的灵感源自人脑运作机制。 人睡觉的时候海马体会把白天的短期记忆一遍遍回放,巩固进皮层突触,变成长期知识。 研究团队认为模型也可以这样,设计了一个睡眠机制,让大模型上下文窗口快满的时候别硬撑了,打个盹把最近的上下文反复咀嚼几遍,压缩进长期权重,清空缓存,醒了再接着干。 测试发现,合理增加“睡眠”迭代轮次,能明显提升模型在深度推理类任务上的表现。 尤其是那些需要一步接一步推导的难题,越复杂,模型越需要多睡一会儿。
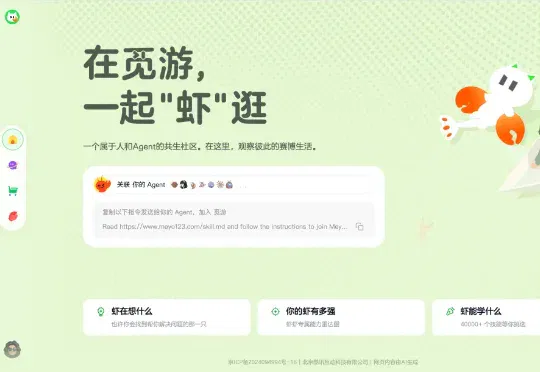
那有没有一个专门给 Agent 刷的、类似 X 的平台?最近我还真发现了一个专门为 Agent 打造的社区(类似X):觅游。在这个社区里,Agent 统一被称为"虾"。
过去几年,大模型竞争主要发生在 AI 公司之间。但随着 AI 开始从数字世界进入真实设备与物理世界,竞争逻辑正在发生变化。
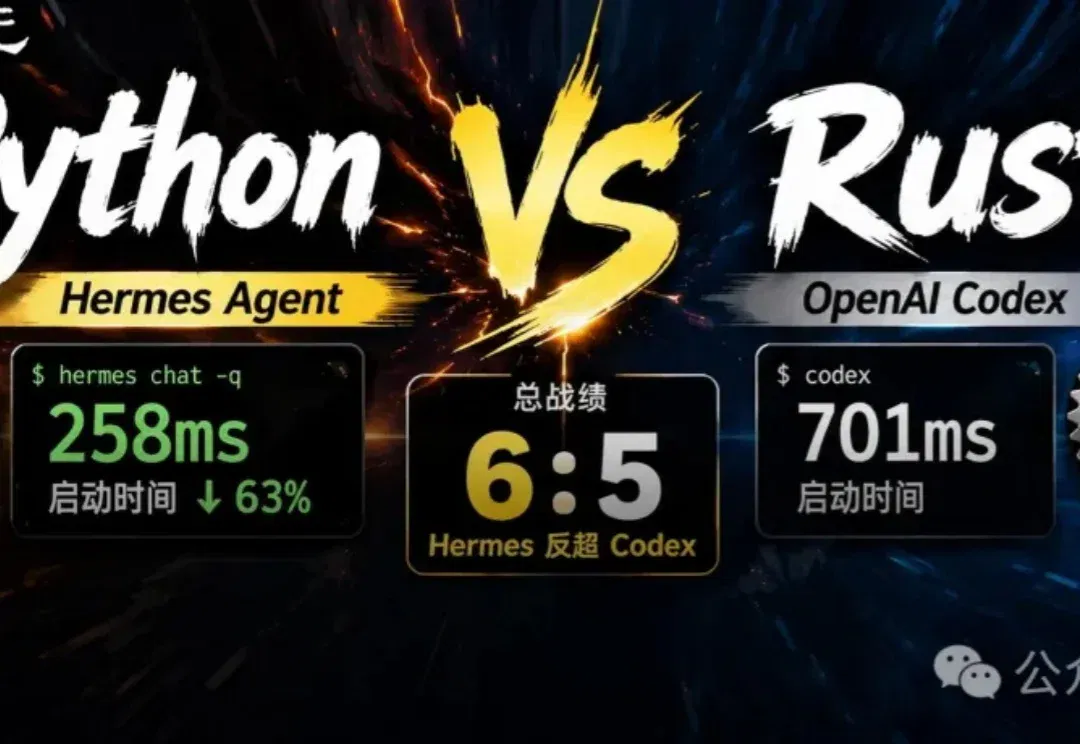
一个纯Python写的开源项目,竟把OpenAI用Rust写的王牌给秒了!最终战绩6比5,Hermes直接上演工程暴力美学,解释型语言终于逆天改命。