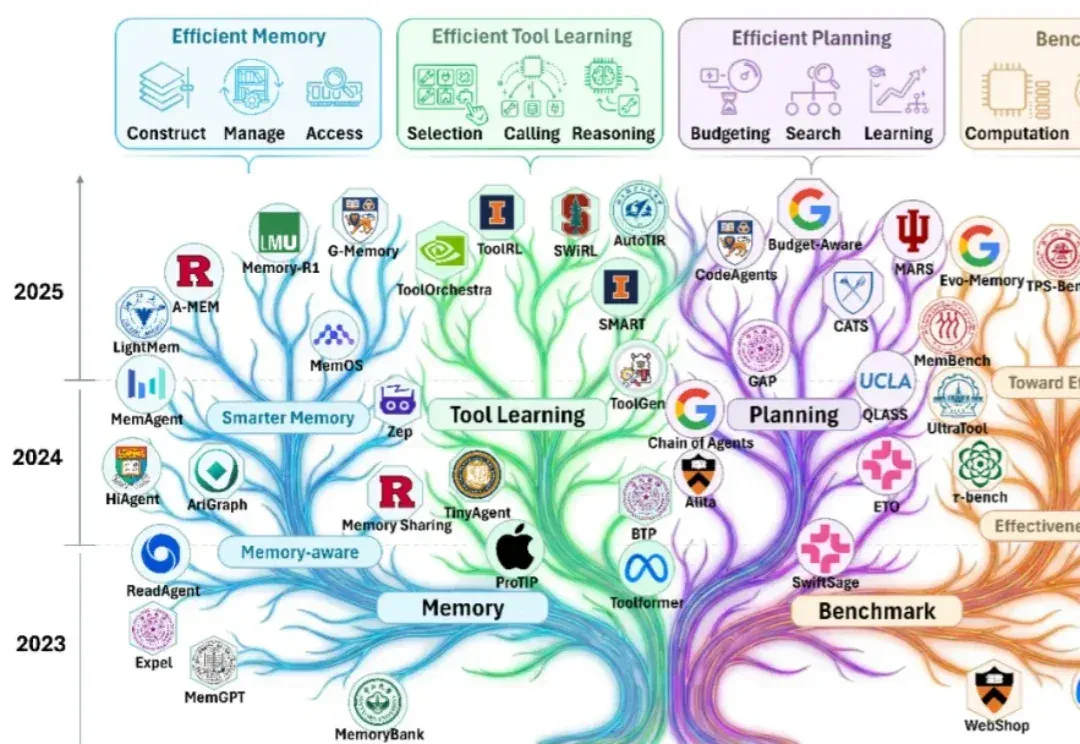
高效智能体的「幕后推手」是谁?一篇综述带你从记忆×工具学习×规划看透 (opens in a new tab)
随着大模型能力的跃迁,业界关注点正在从 “模型能不能做” 快速转向 “智能体能不能落地”。过去一年可以看到大量工作在提升智能体的有效性(effectiveness):如何让它更聪明、更稳、更会用工具、更能完成复杂任务。
Total 1519 articles
随着大模型能力的跃迁,业界关注点正在从 “模型能不能做” 快速转向 “智能体能不能落地”。过去一年可以看到大量工作在提升智能体的有效性(effectiveness):如何让它更聪明、更稳、更会用工具、更能完成复杂任务。
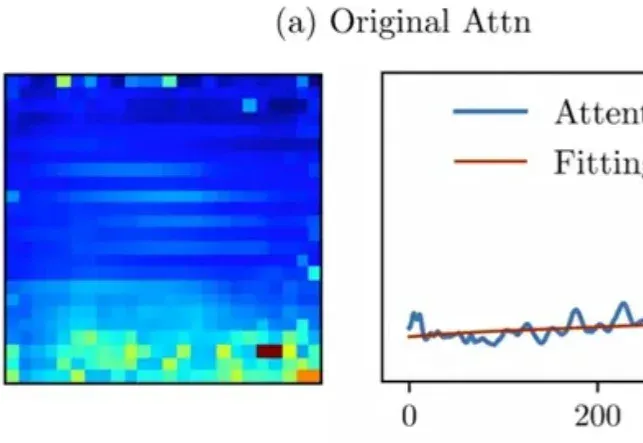
Attention真的可靠吗? 近年来,Vision-Language Models(VLMs)在多模态理解任务中取得了显著进展,尤其是在视觉问答、图像理解和视频理解等场景中,模型通常通过language-to-vision attention来衡量视觉token与文本之间的相关性,并据此进行visual token pruning,以降低推理成本、提升运行效率。 然而,一个长期被忽视的问题是:attention本身是否真的能够作为“语义重要性”的可靠指标? 在最新研究中,上海大学曾丹团队系统分析了主流VLM中attention的行为模式,发现一个关键却容易被忽略的现象——attention并
在文心Moment大会上,文心大模型5.0正式版上线。据称,该模型参数量达2.4万亿,采用原生全模态统一建模技术,具备全模态理解与生成能力,支持文本、图像、音频、视频等多种信息的输入与输出。
大模型卷到第三年,谁在偷偷赚钱?刚刚,一家中国团队,不声不响地拿到了全球第一。它不拼参数、不造模型,却用2.5年跑赢Midjourney,为什么?答案就在它的产品里。
原人工智能大模型公司衔远科技(Frontier.ai)的AI产品负责人 Lyon(李昂),已正式启动新项目 “MIMOS”。与当前市场集中于底层模型研发或垂直应用开发的路径不同,Lyon此次创业将目光投向AI浪潮中更为关键的“产品化”环节,致力于探索连接前沿技术与实际商业价值的系统性方法论。
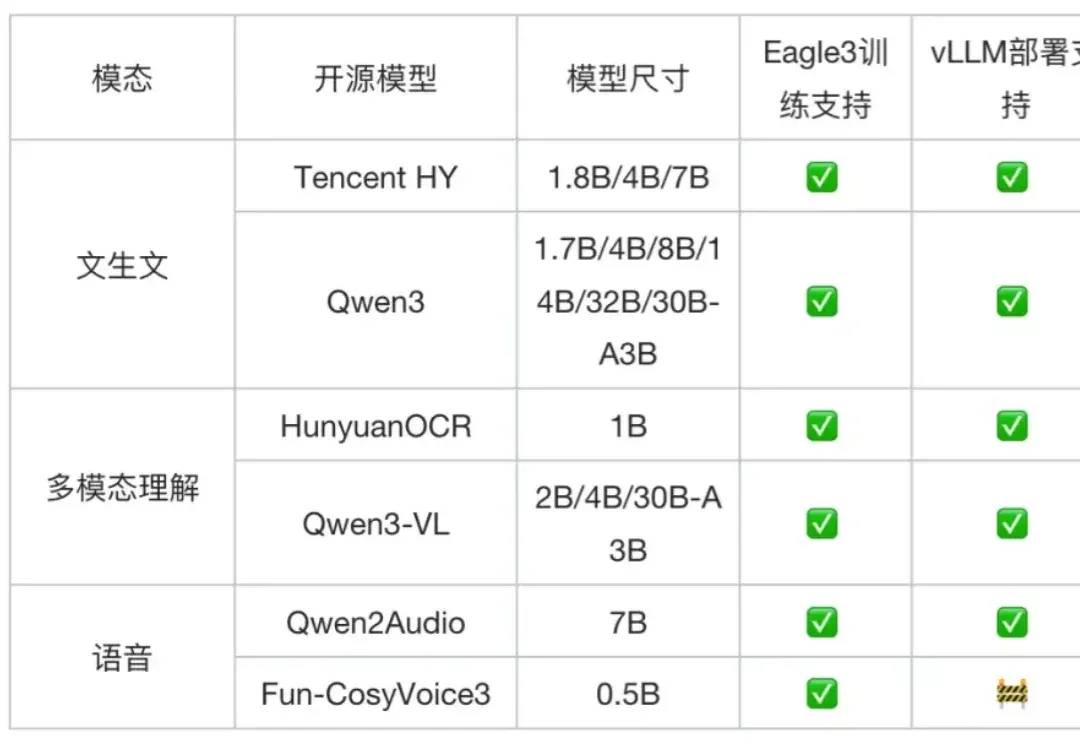
随着大模型步入规模化应用深水区,日益高昂的推理成本与延迟已成为掣肘产业落地的核心瓶颈。在 “降本增效” 的行业共识下,从量化、剪枝到模型蒸馏,各类压缩技术竞相涌现,但往往难以兼顾性能损耗与通用性。
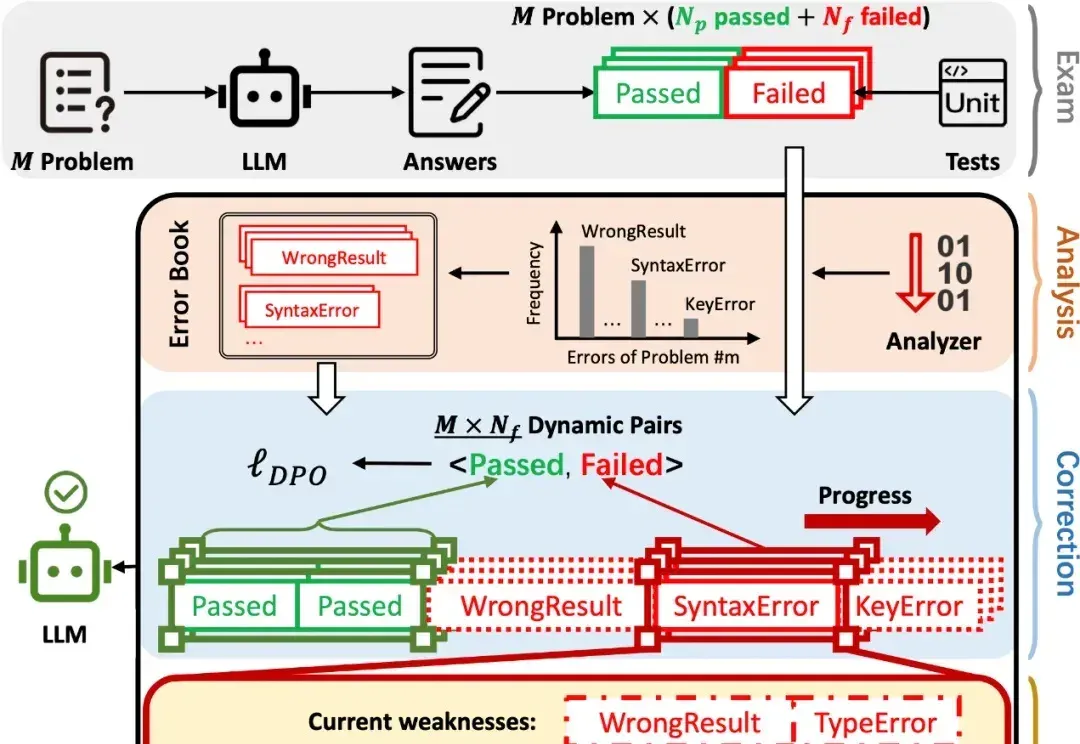
在 AI 辅助 Coding 技术快速发展的背景下,大语言模型(LLMs)虽显著提升了软件开发效率,但开源的 LLMs 生成的代码依旧存在运行时错误,增加了开发者调试成本。
现在,我们越来越多地将大语言模型应用于搜索、编程、内容生成和决策辅助等现实场景中。尽管每天有数百万人使用大模型,但它的问题也随之而来,例如有时会产生幻觉,甚至在特定情境下表现出误导或欺骗用户的倾向。
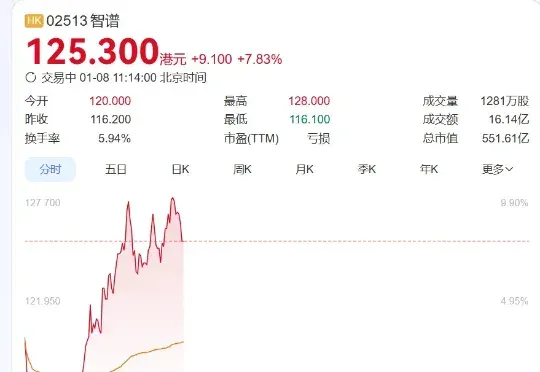
1月8日,大模型六小龙第一股,智谱上市了,市值直超551亿港元,而且一路涨幅超已逾7%。而就在上市前一天,小编注意到,智谱创立发起人兼首席科学家唐杰在微博上发布了一条充满预告意味的帖子,称:“AA(artificialanalysis)换了几个benchmark,基本是把原来刷爆的都换了,现在评估越来越难,新增加的Physical Reasoning貌似还很难。。。。”
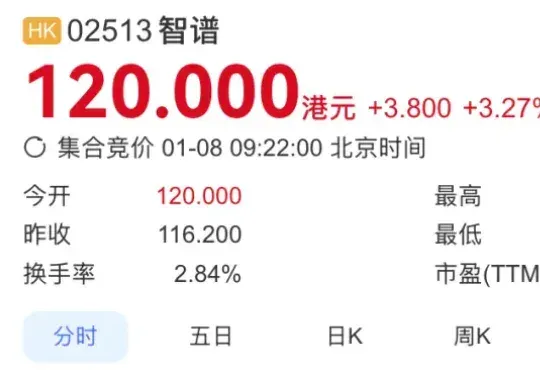
刚刚,全球大模型第一股,终于在港交所敲钟!被称为中国版OpenAI的智谱正式挂牌上市(股票代码2513)。不仅拿下全球首家AGI基座模型上市公司头衔,首日开盘涨超3%,报120港元/股,市值突破528亿港元。