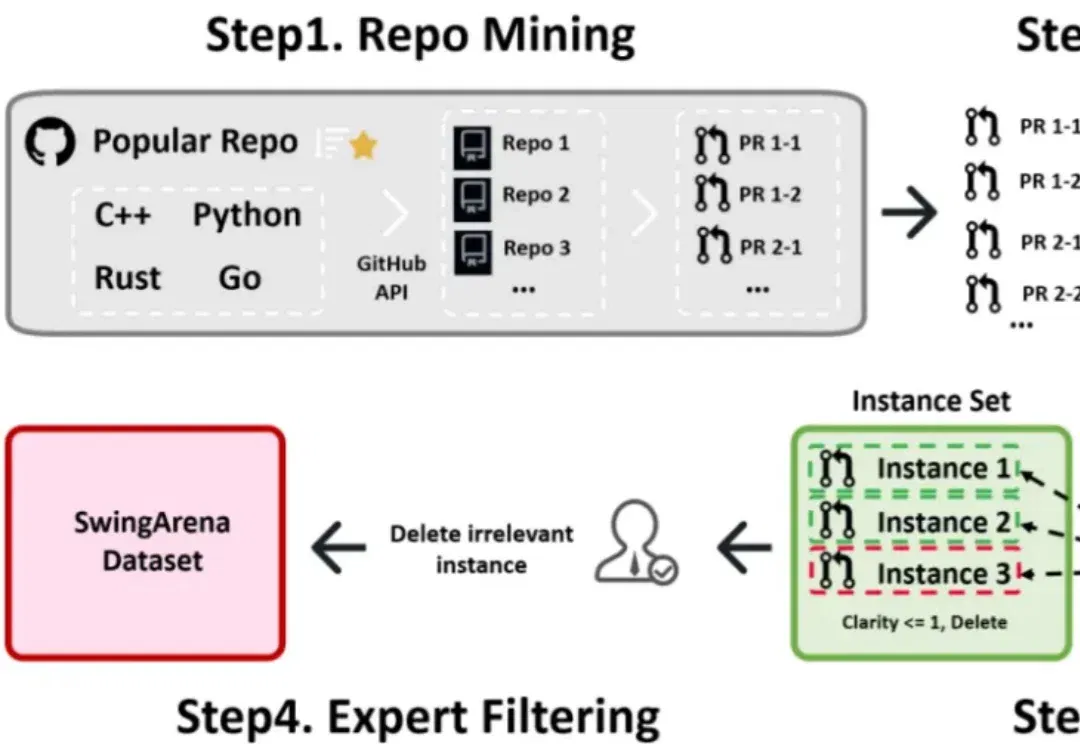
ICLR 2026 oral | AI代码真能进生产环境?SwingArena:从「写对代码Commit」到「通过CI审查」 (opens in a new tab)
过去一年,大模型写代码的能力几乎以肉眼可见的速度提升。从简单脚本到完整功能模块,GPT、Claude、DeepSeek 等模型已经能够在几秒钟内生成看起来相当 “专业” 的代码。
Total 1519 articles
过去一年,大模型写代码的能力几乎以肉眼可见的速度提升。从简单脚本到完整功能模块,GPT、Claude、DeepSeek 等模型已经能够在几秒钟内生成看起来相当 “专业” 的代码。
开源模型同样能承担复杂工程任务。 如果你问一个开发者,AI 编程最让人崩溃的时刻是什么? 他给你的答案很可能会是它在报错面前那句机械的「对不起,我理解错了」,然后复读一段同样错误的代码。 过去一年,Coding 大模型的进步,更多体现在「生成能力」上:一句话生成网页、组件、小游戏——15 秒内搓出一个像素风网页、一个炫酷的 SVG 图标,或者一个能跑的贪吃蛇。这些 Demo 足够惊艳,但也足够「轻」,它们有点像是在 Vibe Coding(氛围感编程)时代产出的高级玩具。但当涉及到高并发架构、底层驱动适配或者复杂的系统重构,它们就成了「温室里的花朵」。 所以最近,硅谷的风向已经变了。 不管是
最强的大模型,已经把scaling卷到了一个新维度:百万级上下文。
LaST₀团队 投稿 量子位 | 公众号 QbitAI 近日,至简动力、北京大学、香港中文大学、北京人形机器人创新中心提出了一种名为LaST₀的全新隐空间推理VLA模型,在基于Transformer混
大模型的革命行将结束,即将开启的会是物理 AI 时代?
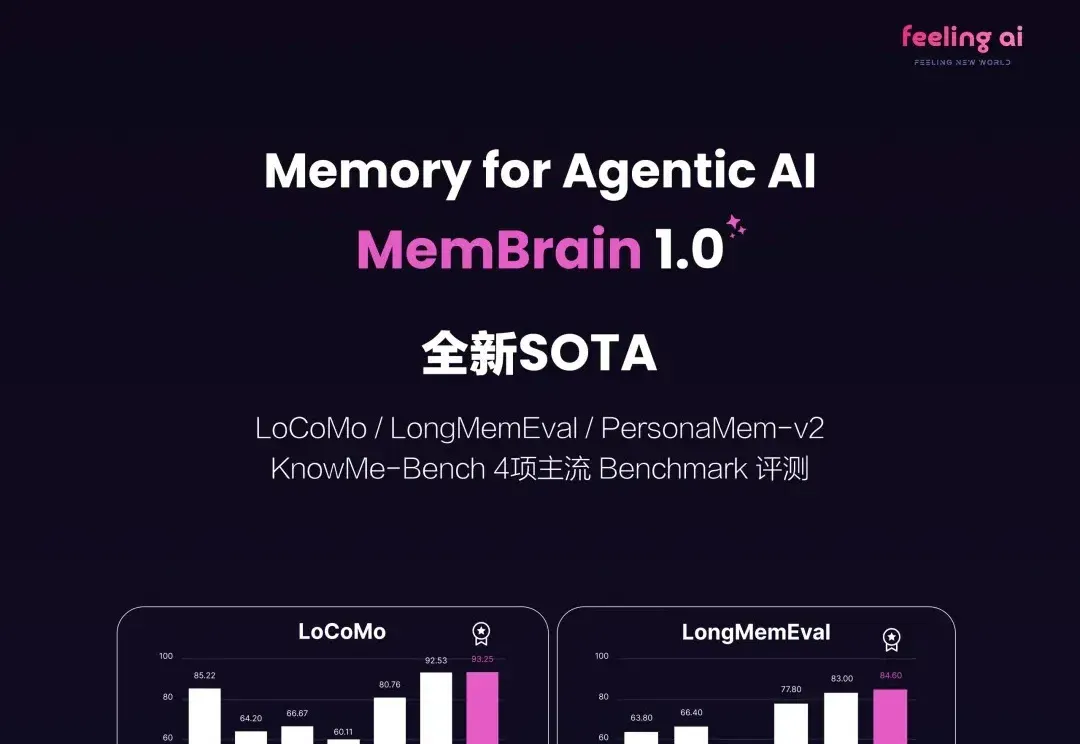
2026 刚来到 2 月,无论是底层模型大厂还是初创公司统统加速开卷,其中 Agentic Memory 方向的快速进化更是把大模型的能力上限推向了 NEXT LEVEL!
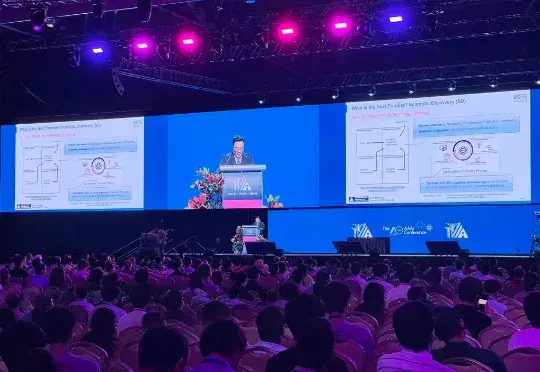
周伯文还详细介绍了上海 AI 实验室近年来开展的前沿探索与实践,包括驱动 “通专融合” 发展的技术架构 ——“智者”SAGE(Synergistic Architecture for Generalizable Experts),其包含基础、融合与进化三个层次,并可双向循环实现全栈进化;支撑 AGI4S 探索的两大基础设施“书生”科学多模态大模型 Intern-S1、“
离开Meta这座围城后,Yann LeCun似乎悟了“不要把鸡蛋装在同一个篮子里”。一边,他亲手打造了自己的初创公司AMI,试图在世界模型这条赛道上大展拳脚;同时,他的目光又投向了硅谷的另一角。
过去几年,机制可解释性(Mechanistic Interpretability)让研究者得以在 Transformer 这一 “黑盒” 里追踪信息如何流动、表征如何形成:从单个神经元到注意力头,再到跨层电路。但在很多场景里,研究者真正关心的不只是 “模型为什么这么答”,还包括 “能不能更稳、更准、更省,更安全”。
大模型能写代码、聊八卦,但敢不敢让它直接接管网络运维?一项最新评测显示,面对真实网络故障,头部模型平均准确率竟不足50%!为此,GSMA联手全球巨头开启「地狱级」难度挑战赛,通往MWC 2026的门票已备好,3.5万欧元大奖等你来拿!