仅0.2B就比GPT-4.1强?加州大学新指标:组合推理基准首次超越人类 (opens in a new tab)
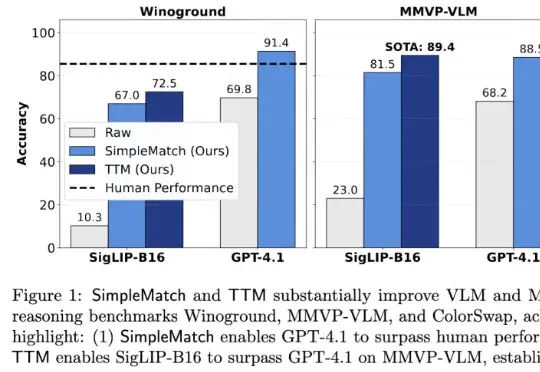
加州大学河滨分校团队发现,AI组合推理表现不佳部分源于评测指标过于苛刻。他们提出新指标GroupMatch和Test-Time Matching算法,挖掘模型潜力,使GPT-4.1在Winoground测试中首次超越人类,0.2B参数的SigLIP-B16在MMVP-VLM基准测试上超越GPT-4.1并刷新最优结果。这表明模型的组合推理能力早已存在,只需合适方法在测试阶段解锁。
Total 881 articles
加州大学河滨分校团队发现,AI组合推理表现不佳部分源于评测指标过于苛刻。他们提出新指标GroupMatch和Test-Time Matching算法,挖掘模型潜力,使GPT-4.1在Winoground测试中首次超越人类,0.2B参数的SigLIP-B16在MMVP-VLM基准测试上超越GPT-4.1并刷新最优结果。这表明模型的组合推理能力早已存在,只需合适方法在测试阶段解锁。
近日,诺贝尔奖得主、美国华盛顿大学教授大卫·贝克(David Baker)和团队再次将 AI 成果送上 Nature,他们开发出一种基于 AI 的蛋白质结构生成模型 RFdiffusion,能在指定病毒表面特定表位的情况下,辅助人类从头设计出能够与之结合的抗体结构。
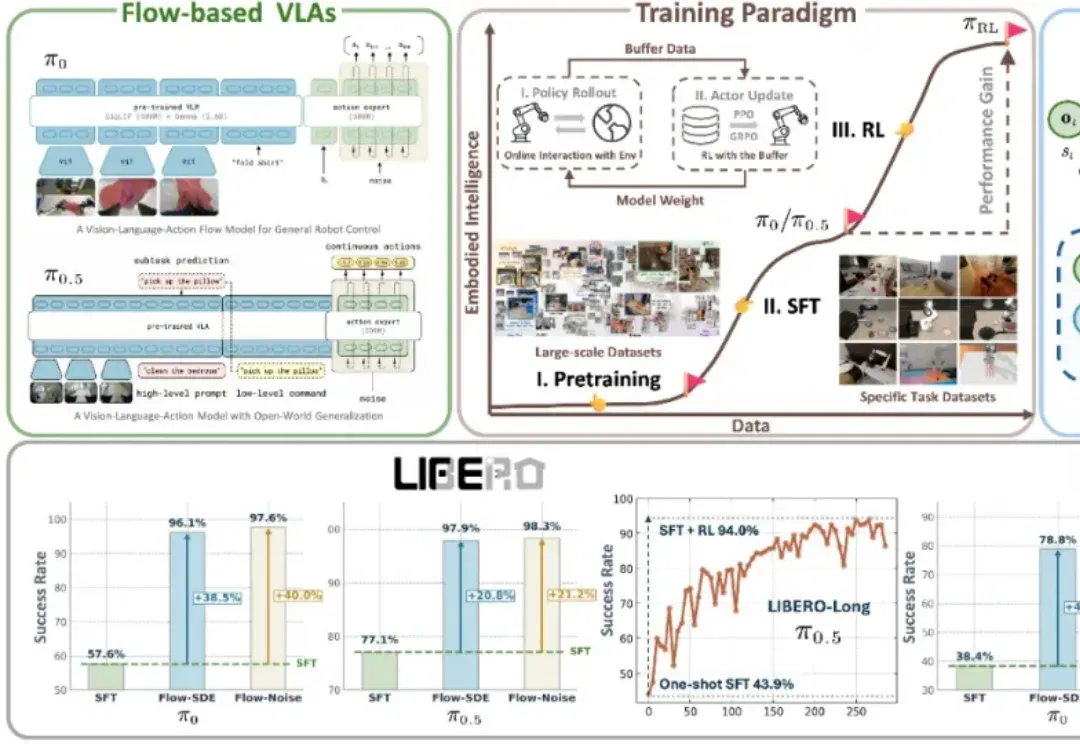
近年来,基于流匹配的 VLA 模型,特别是 Physical Intelligence 发布的 π0 和 π0.5,已经成为机器人领域备受关注的前沿技术路线。流匹配以极简方式建模多峰分布,能够生成高维且平滑的连续动作序列,在应对复杂操控任务时展现出显著优势。
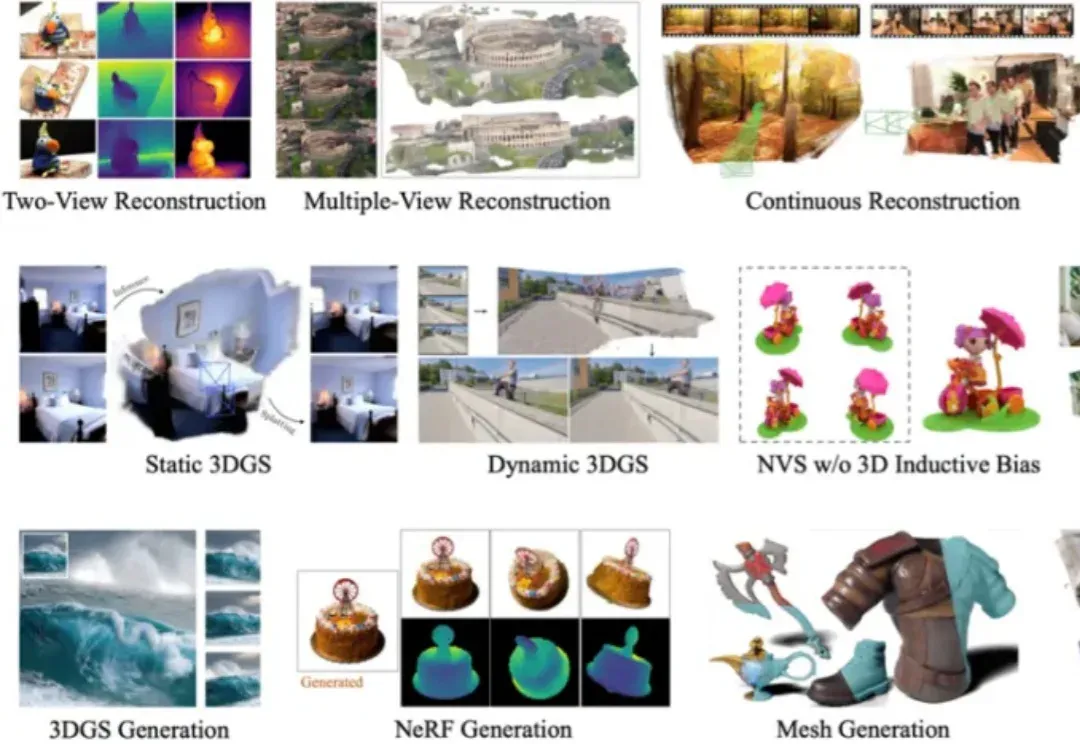
在 3D 视觉领域,如何从二维图像快速、精准地恢复三维世界,一直是计算机视觉与计算机图形学最核心的问题之一。从早期的 Structure-from-Motion (SfM) 到 Neural Radiance Fields (NeRF),再到 3D Gaussian Splatting (3DGS),技术的演进让我们离实时、通用的 3D 理解越来越近。
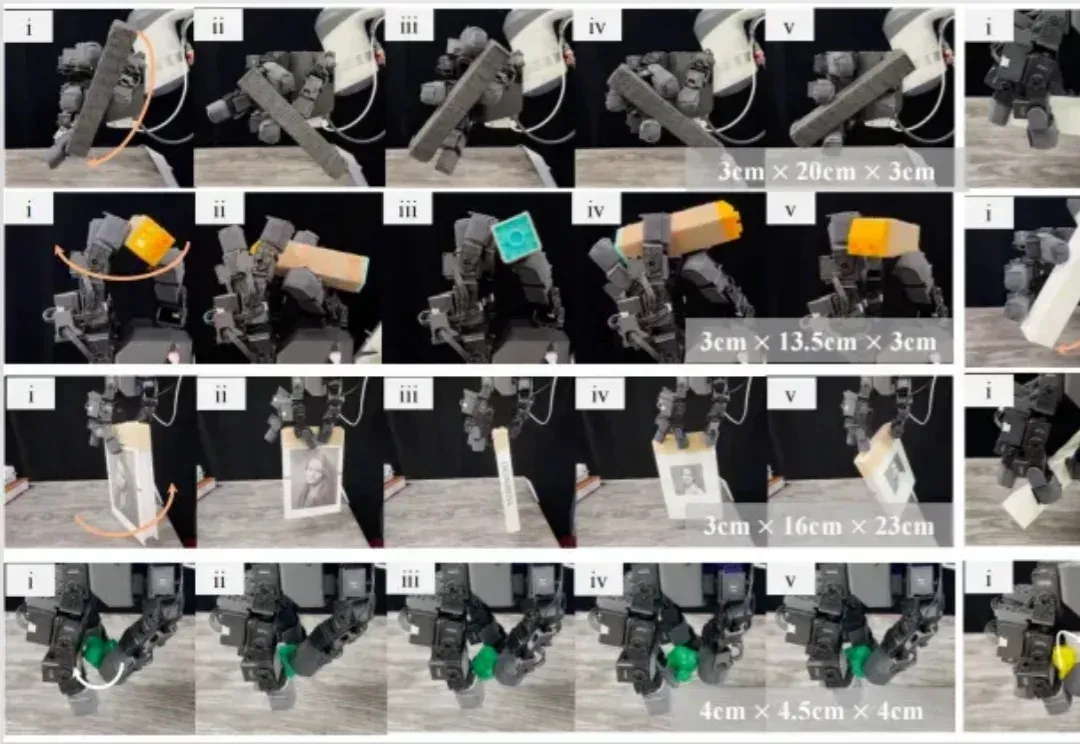
机器人使用灵巧手帮人类在工厂里拧螺丝,在家里切菜做饭的一天何时可以到来?为了实现这一愿景,旨在解决灵巧操作技能 sim-to-real 难题的 DexNDM 应运而生。
如今,一位软件工程师 Teja Kusireddy 用数据扯开了这场“繁荣”背后的部分真相。他对 200 家 AI 公司进行了逆向工程、反编译代码,并追踪 API 调用,发现许多号称“颠覆性创新”的公司,其核心功能仍依赖第三方服务,只是在外层多套了一层“创新”的壳。市场宣传与实际情况之间的差距令人震惊。
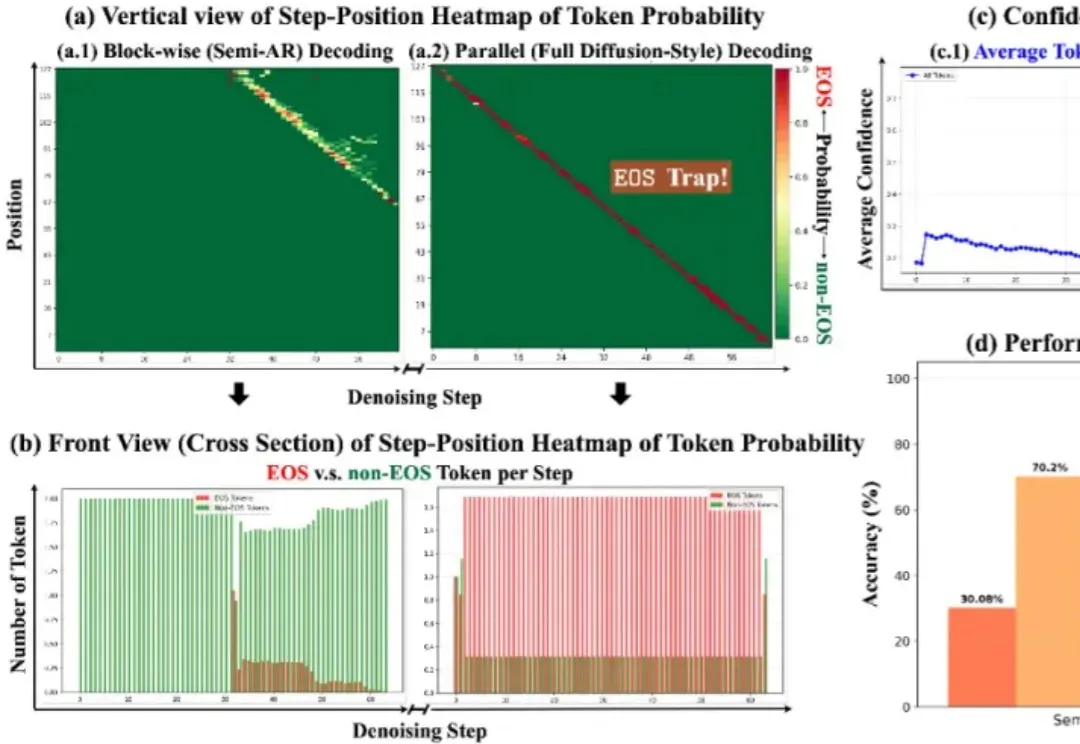
扩散大语言模型得到了突飞猛进的发展,早在 25 年 2 月 Inception Labs 推出 Mercury—— 第一个商业级扩散大型语言模型,同期人民大学发布第一个开源 8B 扩散大语言模型 LLaDA,5 月份 Gemini Diffusion 也接踵而至。
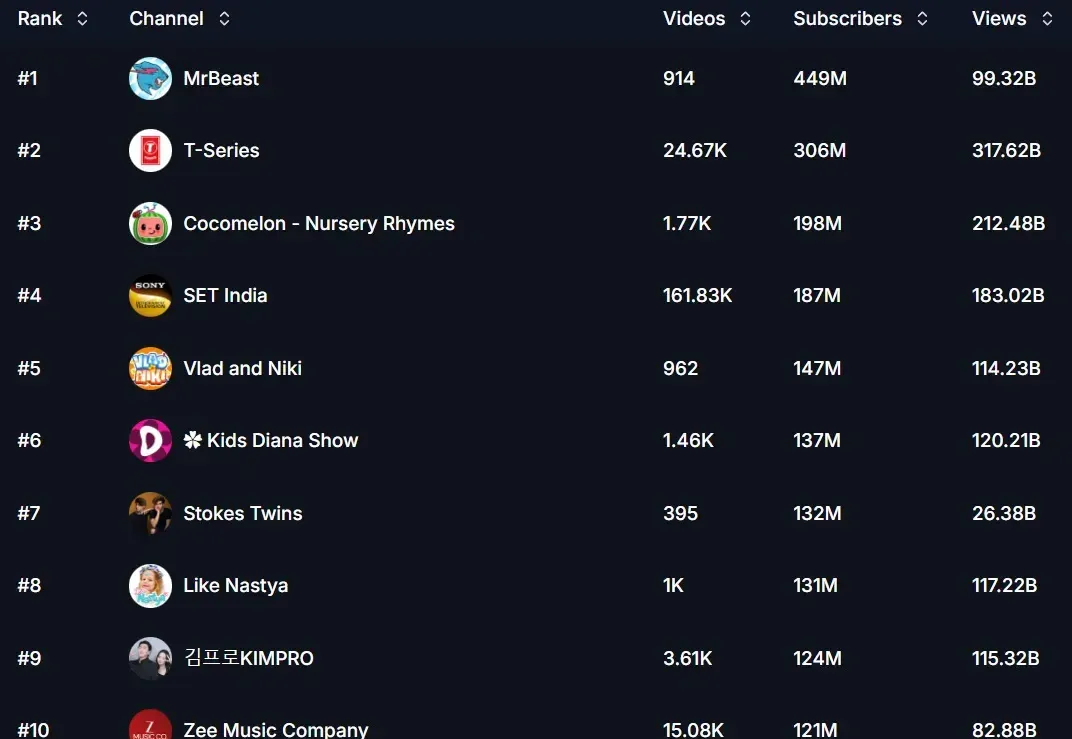
是孩子该看的东西。 「这是我的新项目,10 块 GPU,价值两万美元。」 全球最大的游戏主播,居然开始转型搞 AI 了,没过半天就获得了 100 万播放量。 上周末,PewDiePie 久违地发布了新视频,出乎人们预料的是,内容是在教你训练 AI 大模型。 在这个题为《STOP. Using AI Right now》(停。现在使用 AI)的新视频中,他解释了自己如何从零开始,通过添加搜索、记忆、RAG 和音频输出等功能,创建出个人专属的 ChatGPT 风格用户界面。 他还自己组装了一套硬件系统,共计 10 块英伟达 GPU,使用参数量从 700 亿到 2450 亿不等的大型语言模型,所有这
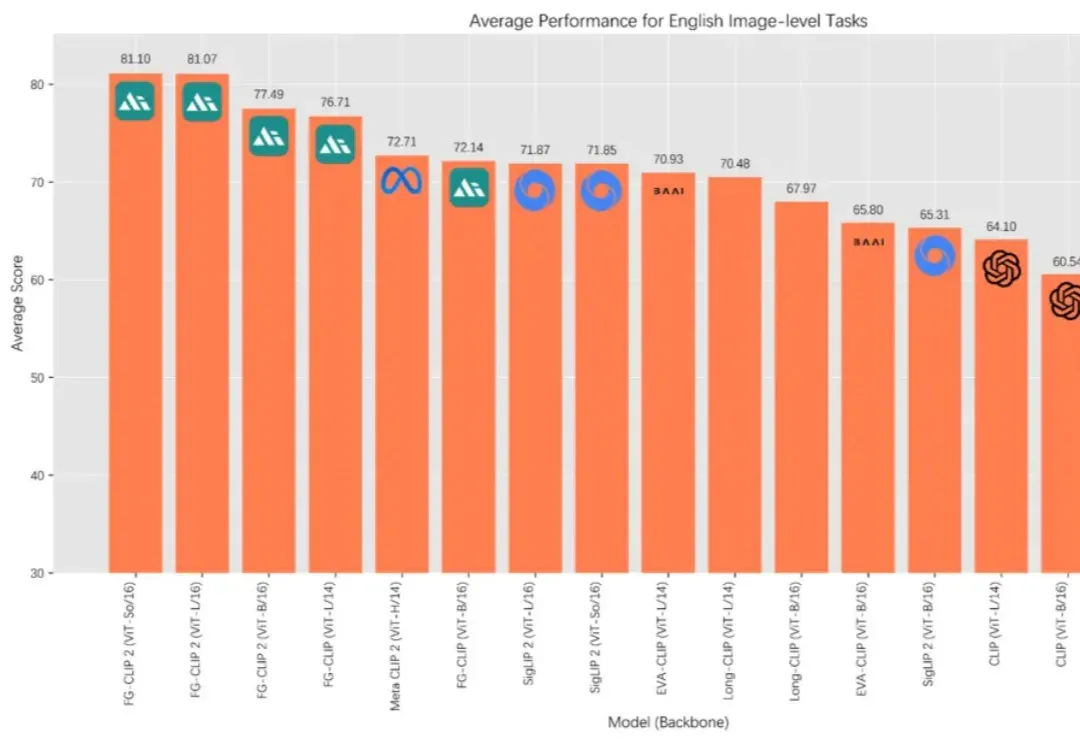
在 AI 多模态的发展历程中,OpenAI 的 CLIP 让机器第一次具备了“看懂”图像与文字的能力,为跨模态学习奠定了基础。如今,来自 360 人工智能研究院冷大炜团队的 FG-CLIP 2 正式发布并开源,在中英文双语任务上全面超越 MetaCLIP 2 与 SigLIP 2,并通过新的细粒度对齐范式,补足了第一代模型在细节理解上的不足。
奥特曼正在用万亿美金的算力豪赌,试图买下全球GPU来喂饱「增长黑洞」。为什么AI竞争的终局不是模型,而是算力?