国内首次!8.9毫秒推理速度破纪录,1元打穿百万token (opens in a new tab)
当所有人还在为参数内卷时,智能体真正的决胜点已经转向了速度与成本。浪潮信息用两款AI服务器直接给出了答案:一个将token生成速度干到10毫秒以内,一个把每百万token成本打到1元时代。
Total 619 articles
当所有人还在为参数内卷时,智能体真正的决胜点已经转向了速度与成本。浪潮信息用两款AI服务器直接给出了答案:一个将token生成速度干到10毫秒以内,一个把每百万token成本打到1元时代。
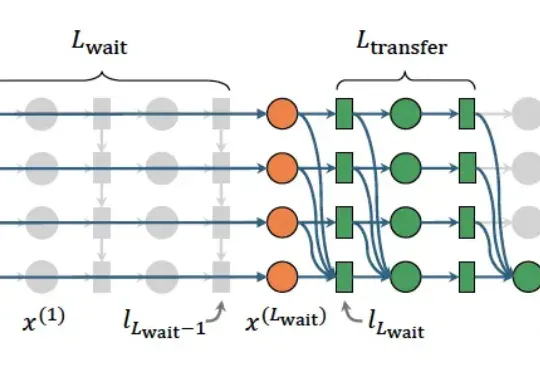
最近,来自加州大学圣克鲁兹分校、乔治·梅森大学和Datadog的研究人员发现:在心算任务中,几乎所有实际的数学计算都集中在序列的最后一个token上完成,而不是分散在所有token中。
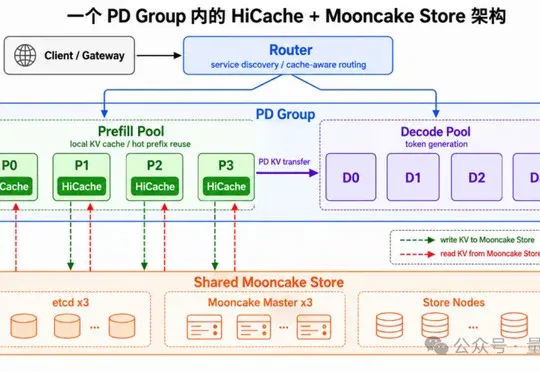
趋境科技通过部署SGLang HiCache+Mooncake Store,将KV Cache从单机资源升级为集群级共享池化资源,支撑其日均产出超万亿Token的生产实践,KV Cache命中率稳定突破90%,并在生产环境中持续优化大规模推理集群的性能与稳定性。
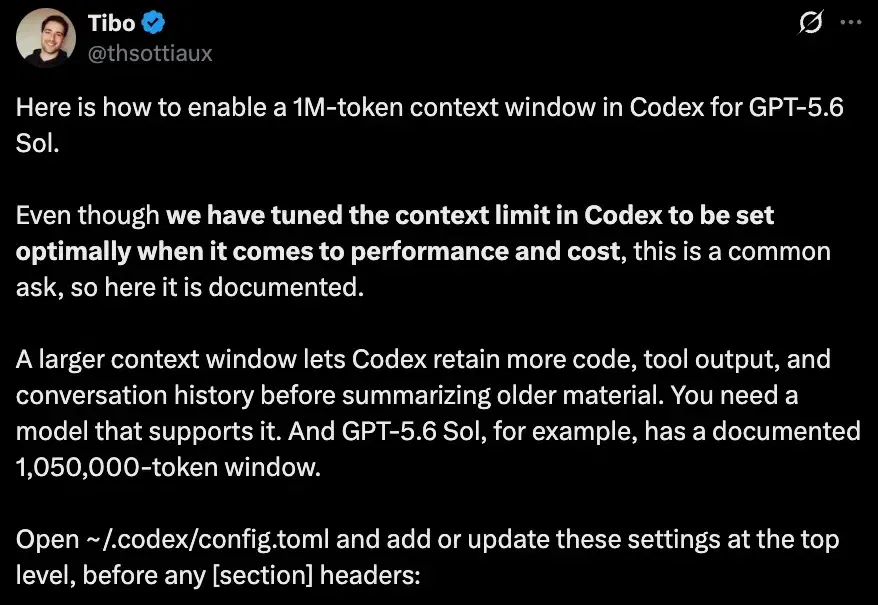
赛博义父Tibo,真·有求必应! 现在,3行配置就能让GPT-5.6 Sol封印解除,在Codex里用上1M上下文了。 model = “gpt-5.6-sol” model_context_window = 1000000 model_auto_compact_token_limit = 900000 非常简单,在Codex的config.toml文件开头输入以上咒语,重启客户端、开启新会话就OK。一直到约90万token时,GPT-5.6 Sol才会开始自动压缩历史内容。 本来是API专属的功能,现在就这么水灵灵地开放给ChatGPT和Codex账号了。 Tibo推文一发,又双叒大爆特爆,
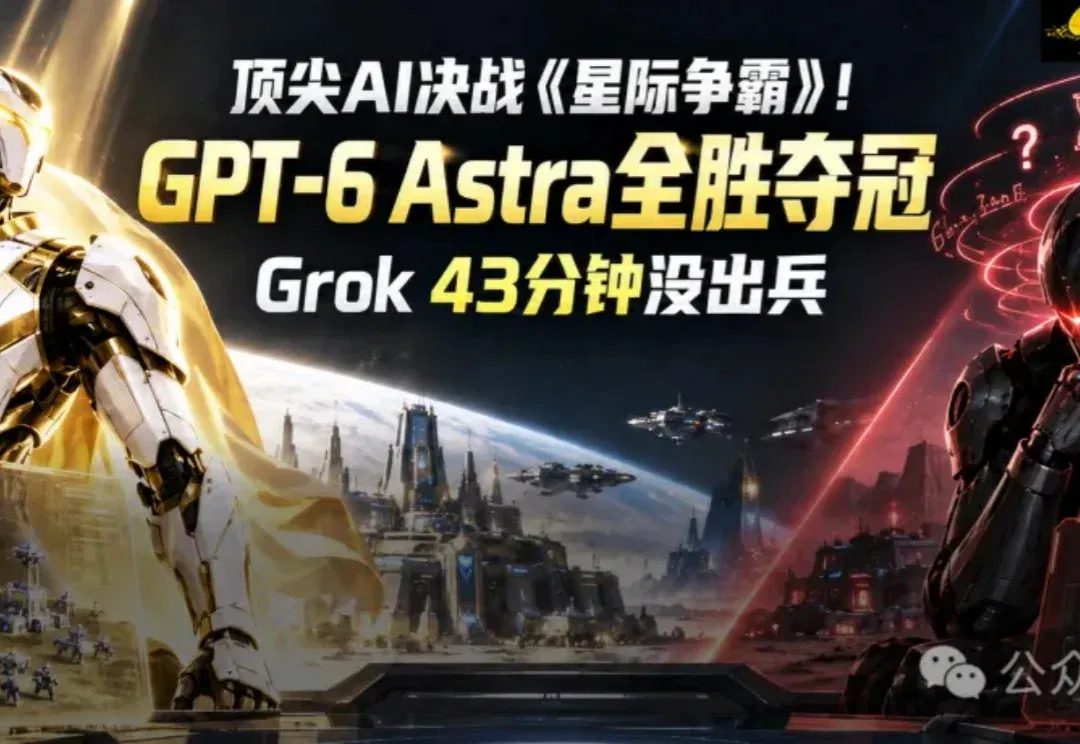
想太多,就连最聪明的AI也会被拖死。 43分钟、11138个推理token、6批指令——0个作战单位。 这是Grok 4.6在《星际争霸:母巢之战》里交出的一张绝望成绩单。 游戏中,把推理拉到最高档位xhigh的Grok,从开局苦思冥想到游戏结束,硬是连一个能上场打仗的兵也没造出来。 而在同一张榜单的另一头,GPT-6 Astra同样火力全开,18战18胜,胜率100%。 这两天,这份名为Brood War Bench的星际大模型榜单,在硅谷程序员扎堆的Hacker News上火了。 Brood War Bench榜单前10名。Astra开最高推理档xhigh,18战全胜,Grok三个档位全在
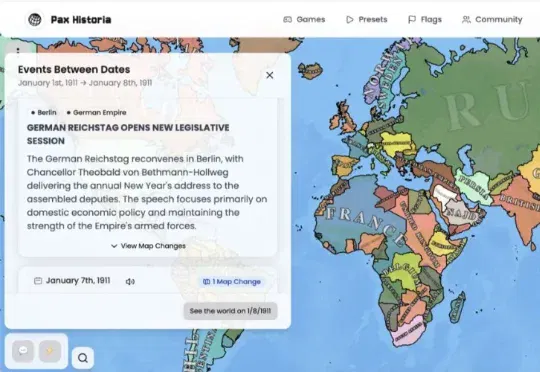
Pax Historia团队3人,日活3.5万,单周处理超过1000亿tokens。这是一款架空历史策略游戏。玩家可以控制1943年的苏联,也可以让罗马帝国继续存在,或者创建一个外星人入侵现代地球的世界。行动通过自然语言输入。玩家可以发动战争、签贸易协议、改革货币、威胁邻国,也可以直接跳过几年。
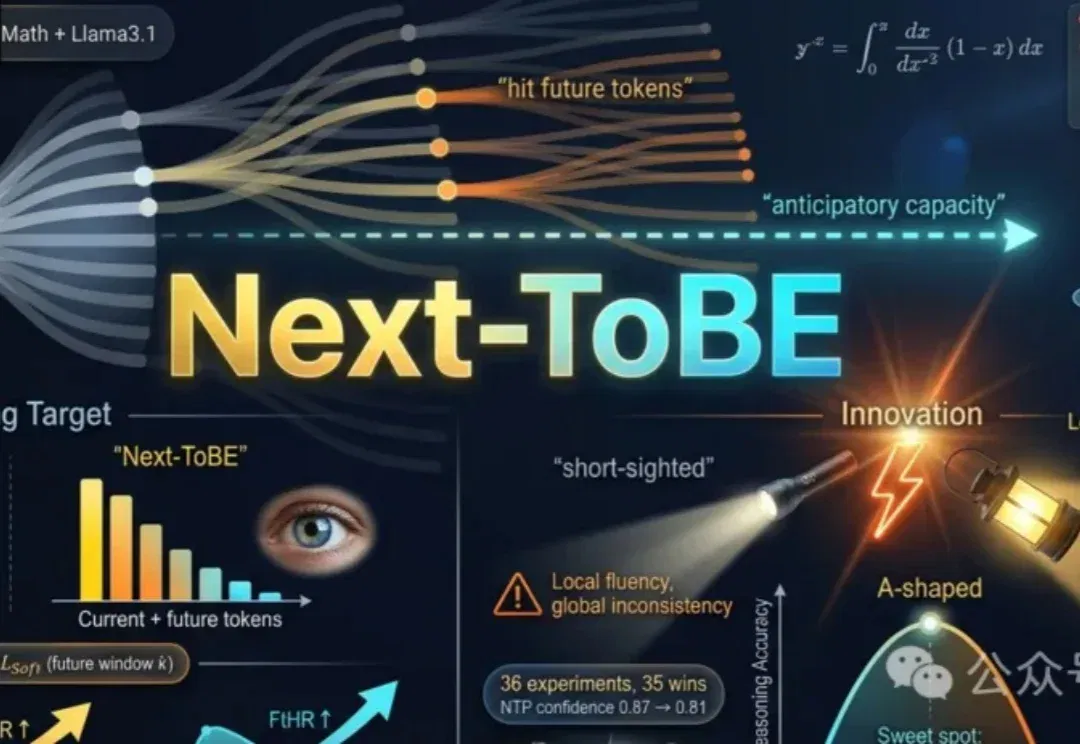
大模型常因只关注当前预测而显得短视。Next-ToBE通过调整训练目标,让模型在每一步预测时兼顾未来token分布,从而提升整体推理能力。
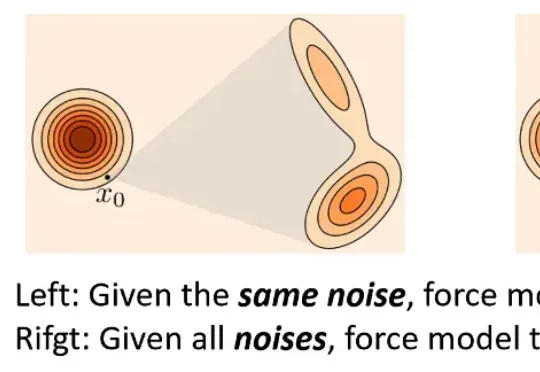
在多模态生成领域,由视频生成音频(Video-to-Audio,V2A)的任务要求模型理解视频语义,还要在时间维度上精准对齐声音与动态。早期的 V2A 方法采用自回归(Auto-Regressive)的方式将视频特征作为前缀来逐个生成音频 token,或者以掩码预测(Mask-Prediction)的方式并行地预测音频 token,逐步生成完整音频。
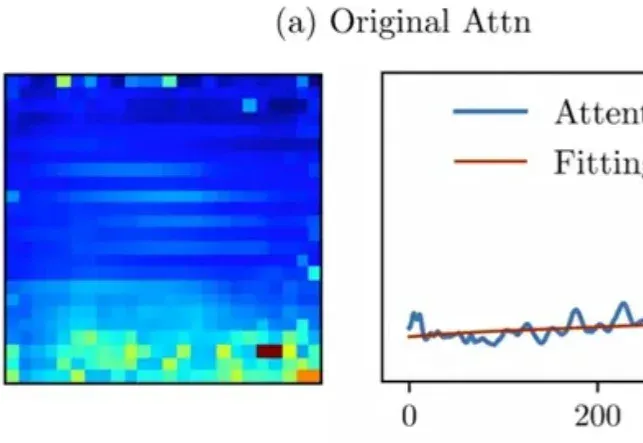
Attention真的可靠吗? 近年来,Vision-Language Models(VLMs)在多模态理解任务中取得了显著进展,尤其是在视觉问答、图像理解和视频理解等场景中,模型通常通过language-to-vision attention来衡量视觉token与文本之间的相关性,并据此进行visual token pruning,以降低推理成本、提升运行效率。 然而,一个长期被忽视的问题是:attention本身是否真的能够作为“语义重要性”的可靠指标? 在最新研究中,上海大学曾丹团队系统分析了主流VLM中attention的行为模式,发现一个关键却容易被忽略的现象——attention并

英伟达死守的推理性价比神话,碎了。 就在刚刚,SemiAnalysis发布了谷歌第七代TPU Ironwood的首份第三方推理性能测算。 在完全对等的模型负载下,TPU的每美元性能最高领先英伟达B200达50%,对B300的领先幅度更是逼近翻倍的96%! 外部TCO口径下每百万token成本 vs 交互速度 换算成业界最敏感的每百万Token成本,差距触目惊心。 TPU仅需0.181美元,B200为0.222美元,B300则高达0.276美元。 更戏剧性的,是时间。 今年4月,黄仁勋在Dwarkesh播客上宣称TPU与Trainium都不敢来跑分。他甚至公开鼓励挑战者使用InferenceMA