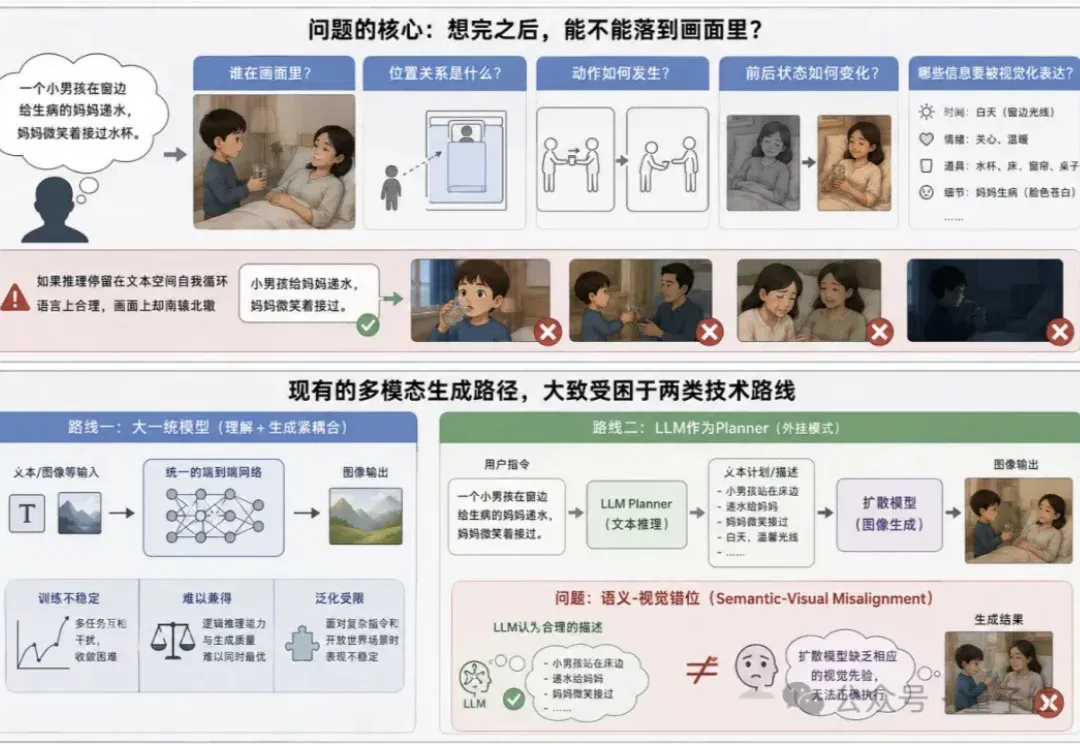
画数独、烧蜡烛都不翻车了?浙大&阿里让AI先三思再下笔|ACL 2026 (opens in a new tab)
当下视觉生成正陷入一个能力错位困境—— 扩散模型的像素画质已接近完美,但一遇到需要逻辑推理的生成任务就频频翻车。
Total 85 articles
当下视觉生成正陷入一个能力错位困境—— 扩散模型的像素画质已接近完美,但一遇到需要逻辑推理的生成任务就频频翻车。
扩散模型杀进了文本生成的地盘,而巨头们为了抢它,已经打起来了。
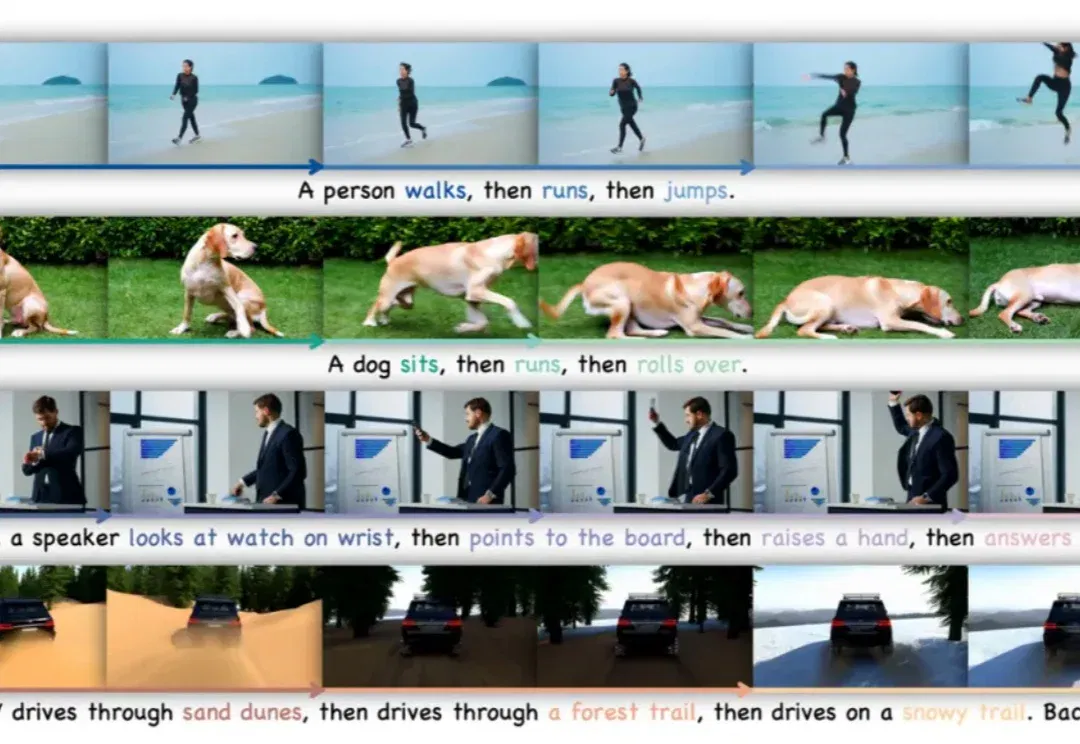
近年来,随着 Sora、Seedance 等文本到视频(T2V)扩散模型的飞速发展,AI 视频生成在视觉保真度与动态表现上已取得突破性进展。特别是近期备受瞩目的 Seedance 2.0,展现出了极其强大的多镜头叙事与复杂分镜控制能力。
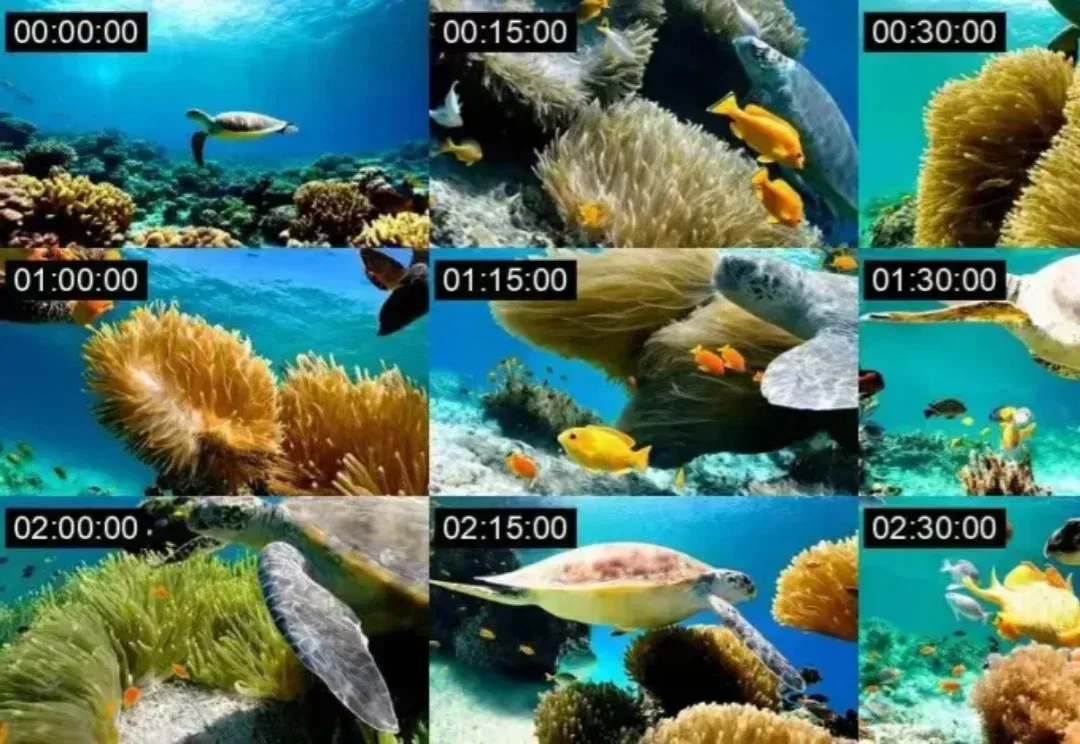
自回归视频生成越往后越崩的问题有救了! 随着视频生成向长时序演进,自回归(AR)扩散模型因其支持流式输出的特性,受到了学术界和工业界的广泛关注。然而,现有的AR生成范式在迈向“无限长”时,始终面临一个核心痛点:训推不一致导致的误差累积。这使得生成的视频越往后,时序漂移和画面崩坏问题(drift)就越严重。 为了缓解这一退化问题,现有的方法尝试了多种路径,例如模拟预测误差、引入First frame sink或者Self-rollout机制。但这些修补方案都存在各自的局限性,比如使用frame sink往往会导致视频的场景变化受到严重限制。 长时序下的漂移问题,其根源到底在哪里? 「自回归生成的
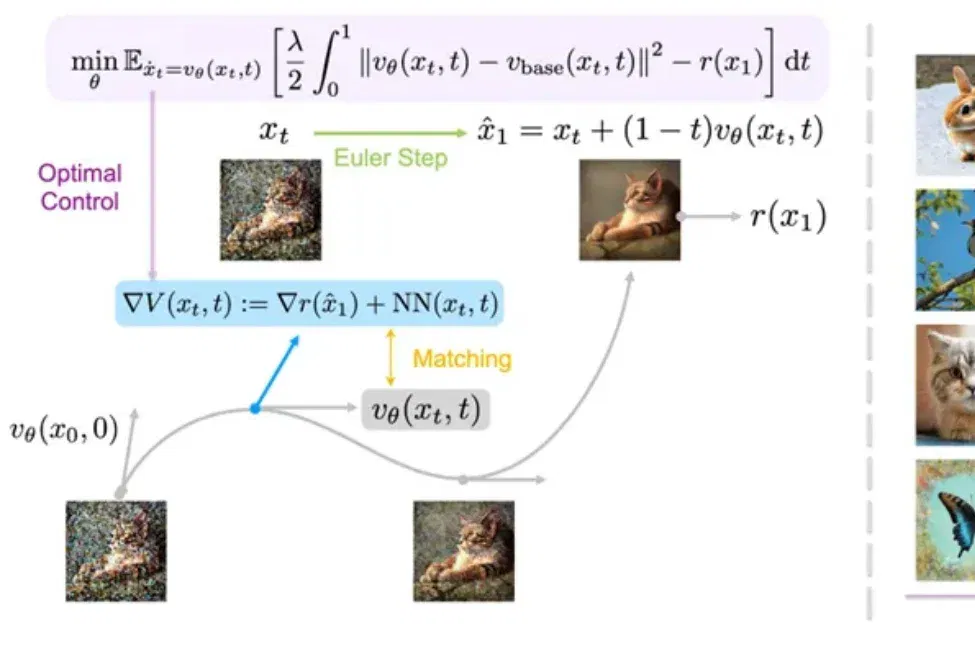
用强化学习微调扩散模型,还有更好的办法吗?
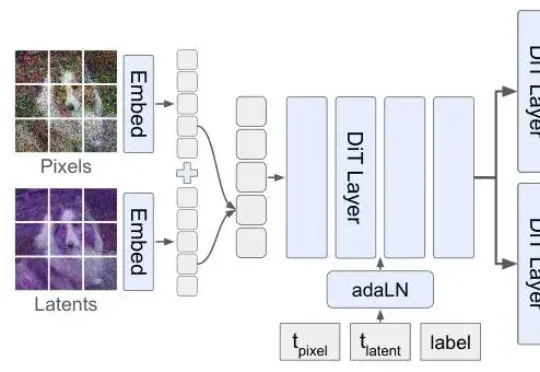
但扩散模型生图,顺序真的对吗?李飞飞团队最新论文提出的Latent Forcing方法直接打破了这一共识,他们发现生成的质量瓶颈不在架构,而在顺序。
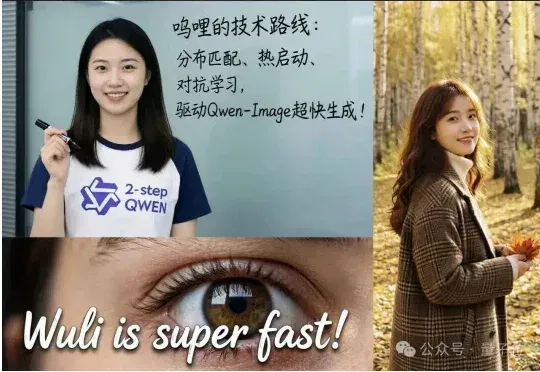
AI生成一张图片,你愿意等多久?在主流扩散模型还在迭代中反复“磨叽”、让用户盯着进度条发呆时,阿里智能引擎团队直接把进度条“拉爆”了——5秒钟,到手4张2K级高清大图。
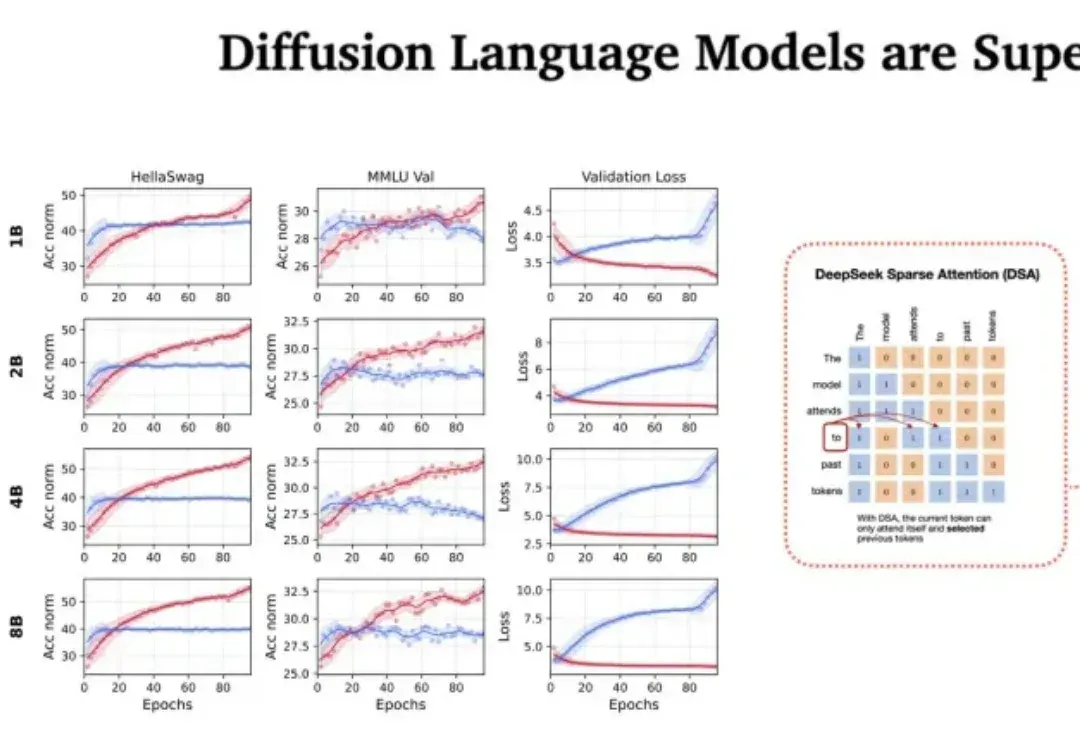
站在 2026 年的开端回望,LLM 的架构之争似乎进入了一个新的微妙阶段。过去几年,Transformer 架构以绝对的统治力横扫了人工智能领域,但随着算力成本的博弈和对推理效率的极致追求,挑战者们从未停止过脚步。
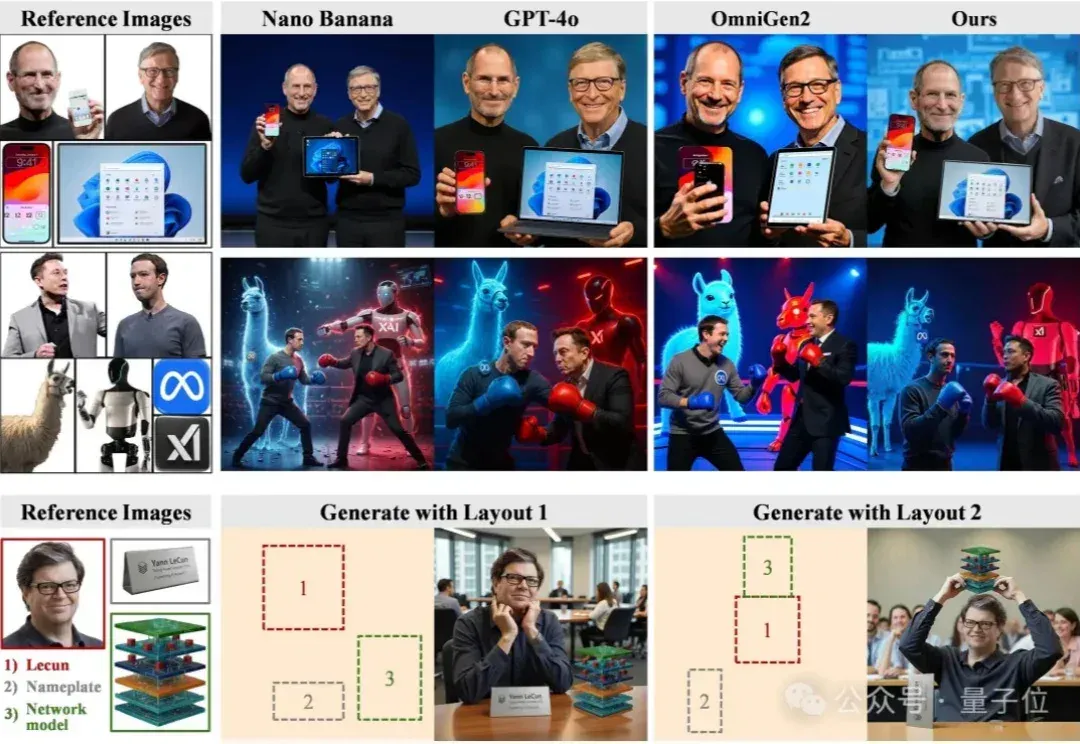
尽管扩散模型在单图像生成上已经日渐成熟,但当任务升级为高度定制化的多实例图像生成(Multi-Instance Image Generation, MIG)时,挑战随之显现:
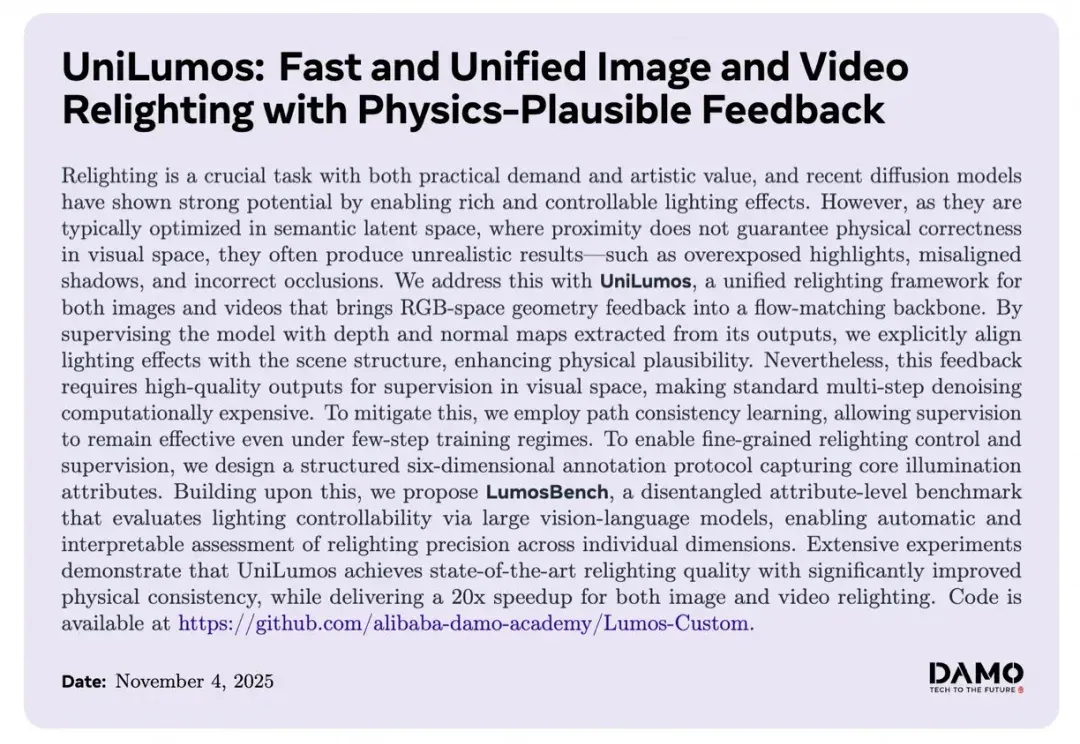
图像与视频重光照(Relighting)技术在计算机视觉与图形学中备受关注,尤其在电影、游戏及增强现实等领域应用广泛。当前,基于扩散模型的方法能够生成多样且可控的光照效果,但其优化过程通常依赖于语义空间,而语义上的相似性无法保证视觉空间中的物理合理性,导致生成结果常出现高光过曝、阴影错位、遮挡关系错误等不合理现象。