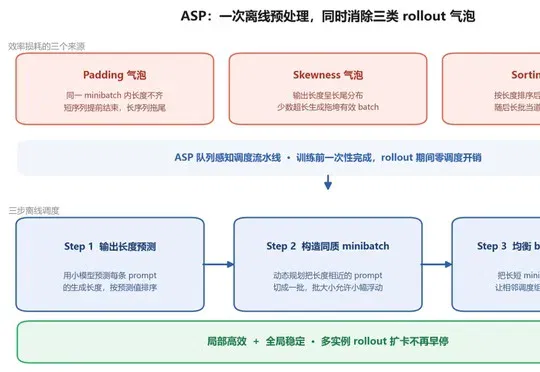
昇腾上的 ASP 调度方案提高大模型强化学习生成吞吐 (opens in a new tab)
深圳市大数据研究院和华为团队把训练与生成解耦,并按预计输出长度调度。在 64 张昇腾 910B3 的测试中,ASP 的生成吞吐最高较混合式基线提升 222%。
Total 198 articles
深圳市大数据研究院和华为团队把训练与生成解耦,并按预计输出长度调度。在 64 张昇腾 910B3 的测试中,ASP 的生成吞吐最高较混合式基线提升 222%。
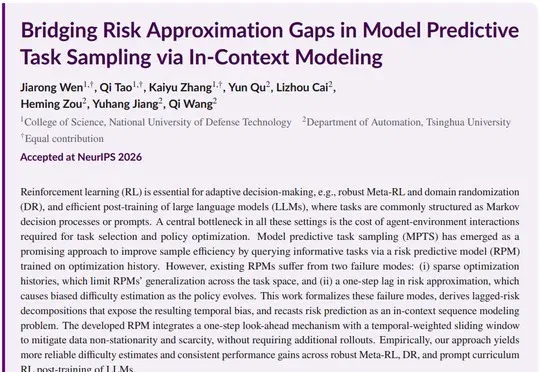
团队利用最近批次的任务与风险数据,预测策略更新后的任务风险。在论文所测的连续控制与 Countdown 后训练中,排序和部分结果改善,风险预测无需额外采样。
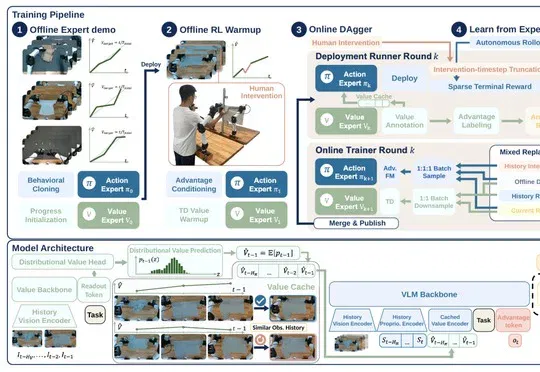
VaM 将近期价值预测缓存输入动作策略,帮助机器人区分视觉相似却进度不同的状态,再通过离线预热与在线真机强化学习更新策略。团队在纸盒装配、衣物折叠等任务上报告恢复与成功率收益,其中四小时稳定运行来自纸盒装配设置,不代表所有长期操作任务。
西湖心辰创始人蓝振忠解释为何押注扩散语言模型:利用并行生成和多条思维链,在响应速度与交互质量之间寻找新取舍。访谈也谈到数据利用、分块扩散、强化学习和全模态 Agent 路线,相关效果来自团队实验与业务场景,规模化能力仍需逐项验证。
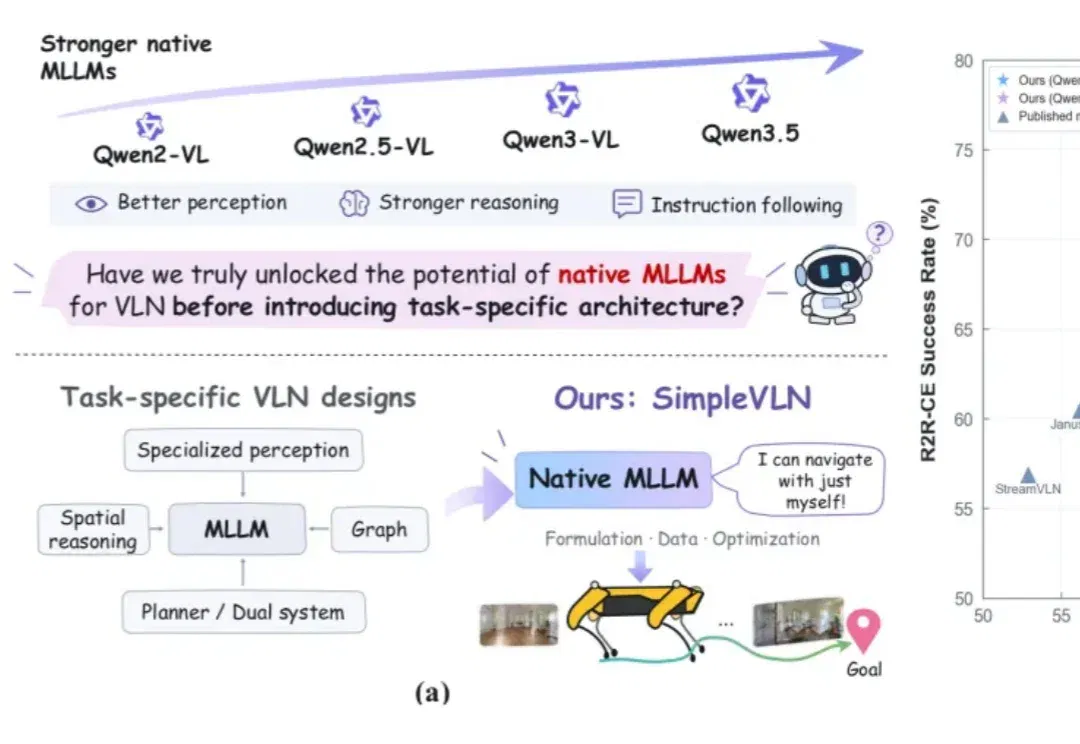
SimpleVLN 通过历史画面筛选、动作块输出,以及专家示范、DAgger 和强化学习组成的训练流程,挖掘原生多模态模型的导航能力。团队在连续导航基准上报告提升,并展示四足机器人演示;仿真成功率与真实环境的稳定泛化仍应分别验证。
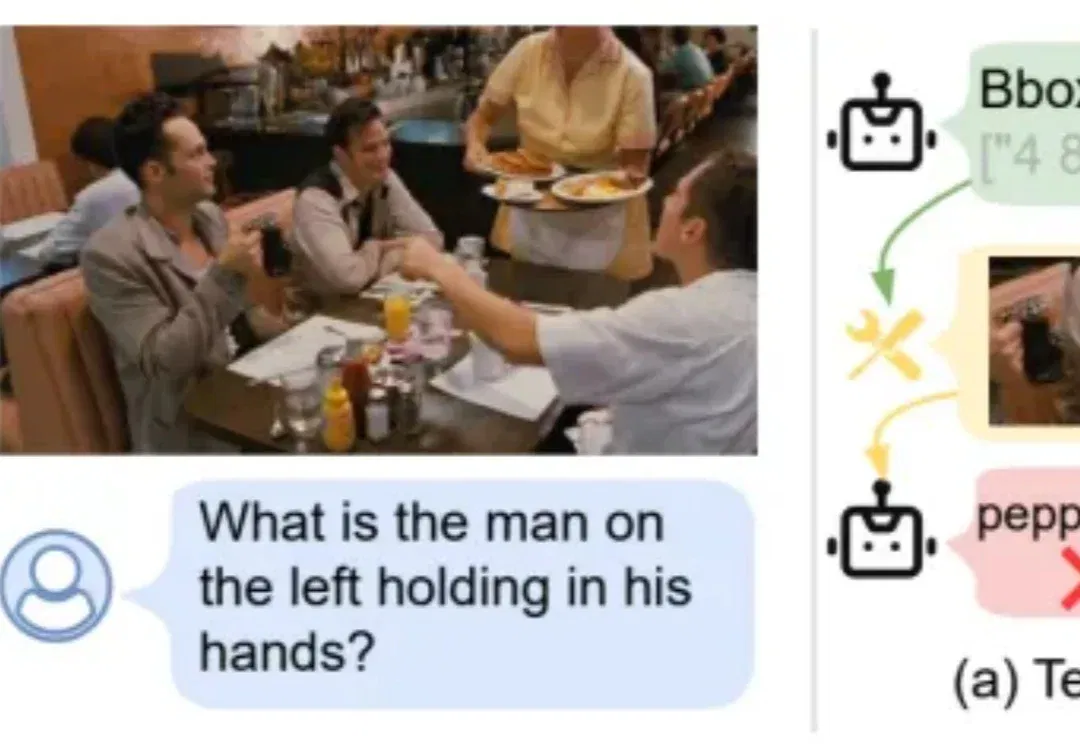
视觉模型即使理解了问题,也可能因图像裁切位置不准而错过细节。NV-CoT 用连续坐标替代离散位置选择,结合监督微调与强化学习改善区域定位;多项高分辨率测试展示了收益,但更精确的坐标仍无法替代正确的语义理解。
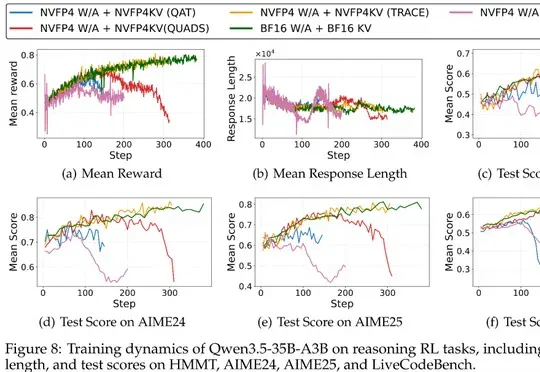
阿里千问联合俄亥俄州立大学提出TRACE,以Rollout侧FP4量化结果引导训练侧舍入,在四个Qwen MoE模型上保持接近BF16的性能,并使128K输出解码吞吐最高提升5.4倍。
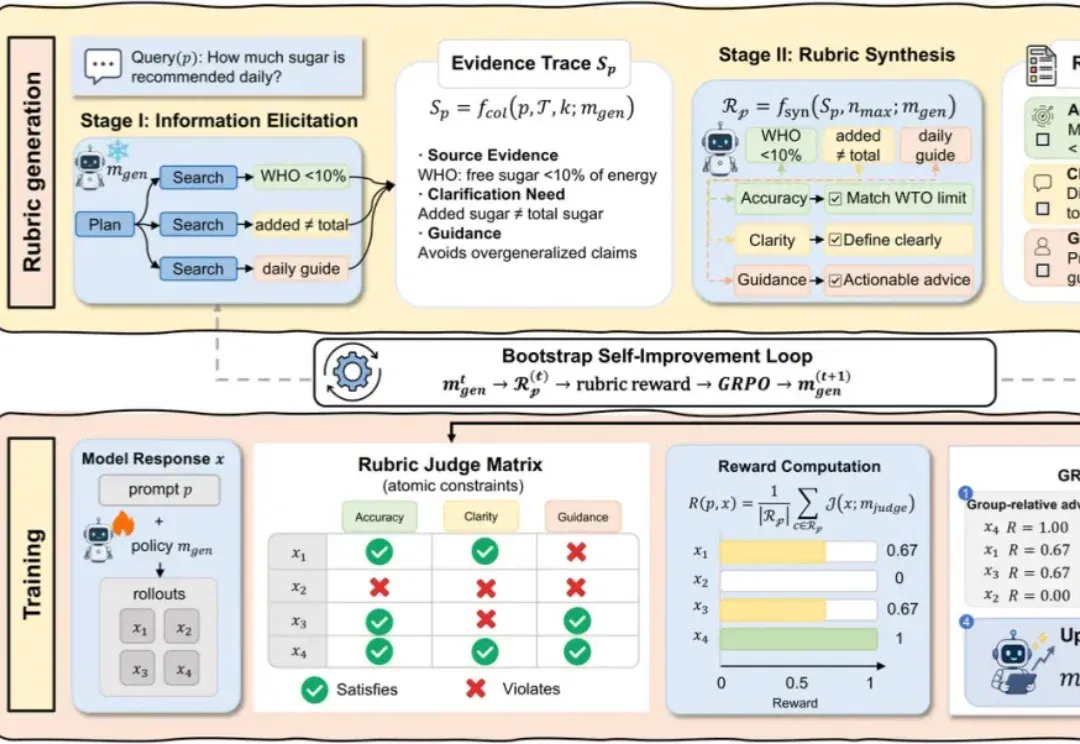
让大模型回答一道数学题,通常还能拿标准答案判断对错。可如果问题换成「梳理一个领域的研究进展」「比较几种技术路线」或者「给出有依据的专业建议」,怎样才算答得好?答案没有唯一版本,遗漏关键事实、混淆概念、论证不充分,都可能藏在一段看起来很流畅的文字里。
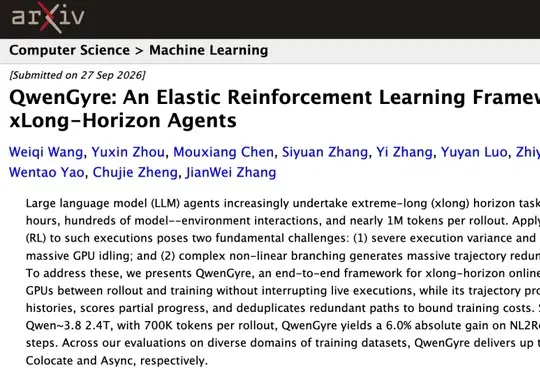
千问披露Agent训练框架QwenGyre,通过弹性调度和轨迹处理,将Qwen 3.8 2.4T的48步强化学习训练耗时从134.55小时降至75.42小时、效率提升78%,并计划优化后开源。
2026 年 9 月 11 日,一封联名声明震动了学术界。