Search

Results for “SI”

Total 881 articles

“最强具身VLA大模型”,究竟强在哪儿?

“最强具身VLA大模型”,究竟强在哪儿? (opens in a new tab)

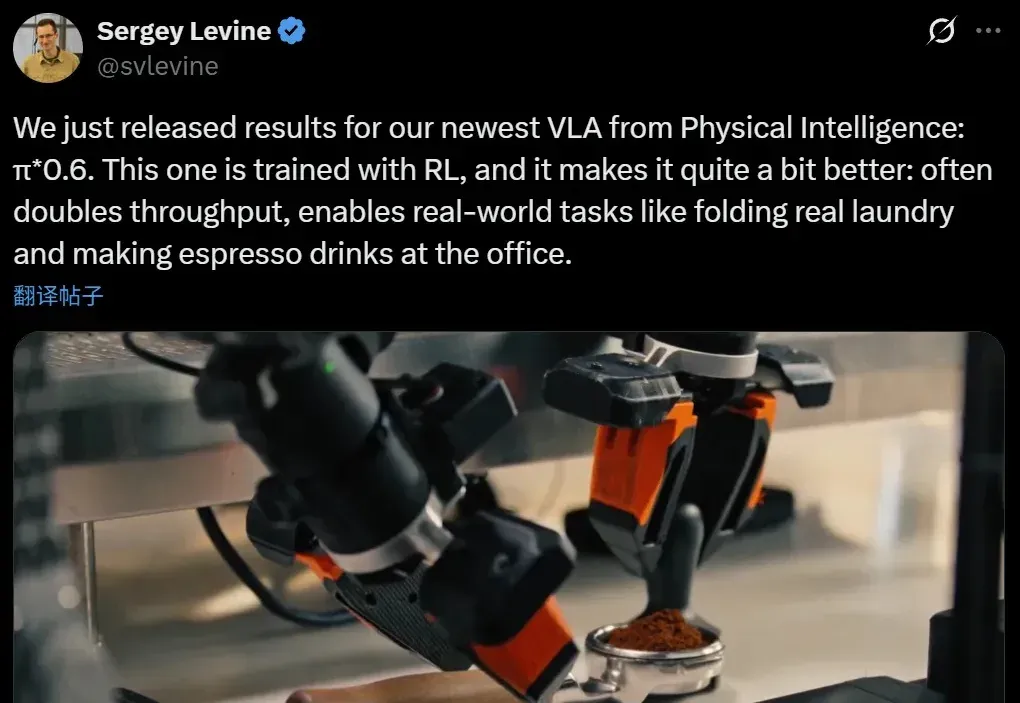
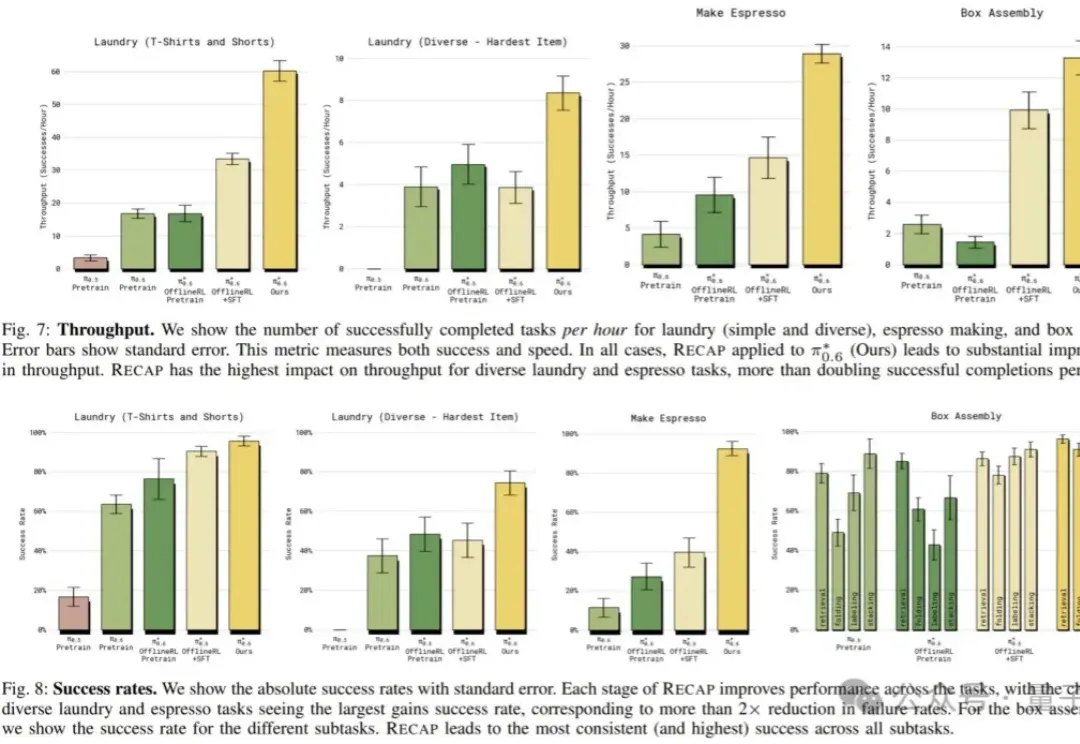
看似轻描淡写,实则力透纸背。 Physical Intelligence刷屏全网的机器人基础模型π*0.6,一亮相就秀出了实力: 让机器人连续一整天制作意式浓缩咖啡,数小时不间断折叠各类衣物,还能精准组装工厂所需的包装纸箱。 在π*0.6的加持下,这些任务的成功率都达到了90%以上。 然而,仔细阅读论文就会发现,比起连做13个小时咖啡,π*0.6真正的突破在于引入了一种更直觉的学习方法——Recap: 指导:用人类示范教它基础动作辅导:纠错指导让它修正错误练习:从自主经验中不断优化、变得更强 这彻底扭转了过去机器人只会逼近 “真值” 的模仿学习模式,让机器人能从自己的错误中成长。 就连网友也直
AI guides
0
何恺明团队新作:扩散模型可能被用错了

何恺明团队新作:扩散模型可能被用错了 (opens in a new tab)

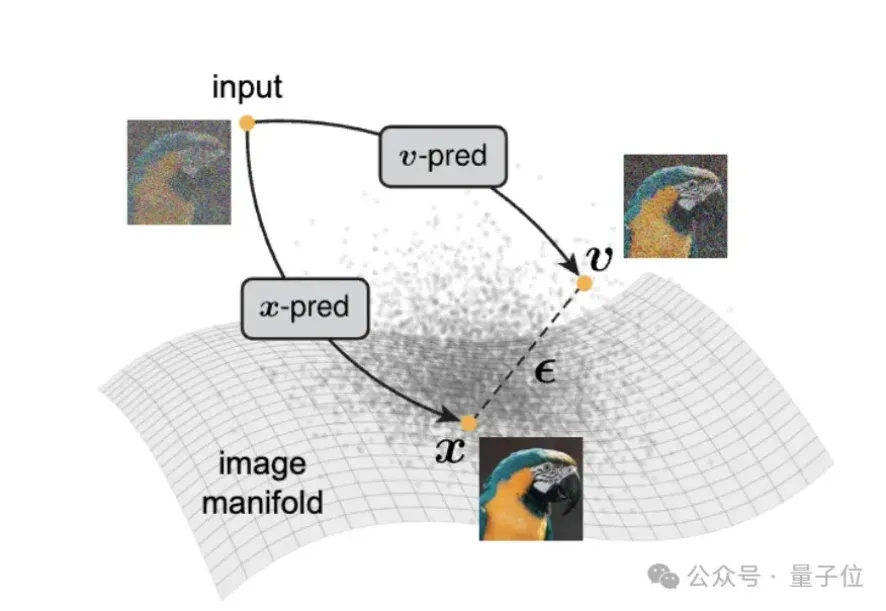
何恺明又一次返璞归真。 最新论文直接推翻扩散模型的主流玩法——不让模型预测噪声,而是直接画干净图。 如果你熟悉何恺明的作品,会发现这正是他创新的典型路径,不提出更复杂的架构,而是把问题拆回最初的样子,让模型做它最擅长的那件事。 实际上,扩散模型火了这么多年,架构越做越复杂,比如预测噪声、预测速度、对齐latent、堆tokenizer、加VAE、加perceptual loss…… 但大家似乎忘了,扩散模型原本就是去噪模型。 现在这篇新论文把这件事重新摆上桌,既然叫denoising模型,那为什么不直接denoise? 于是,在ResNet、MAE等之后,何恺明团队又给出了一个“大道至简”的结

AI guides
0
NeurIPS 2025 Spotlight | 香港大学提出无需数据标记的ViT密集表征增强方法

NeurIPS 2025 Spotlight | 香港大学提出无需数据标记的ViT密集表征增强方法 (opens in a new tab)

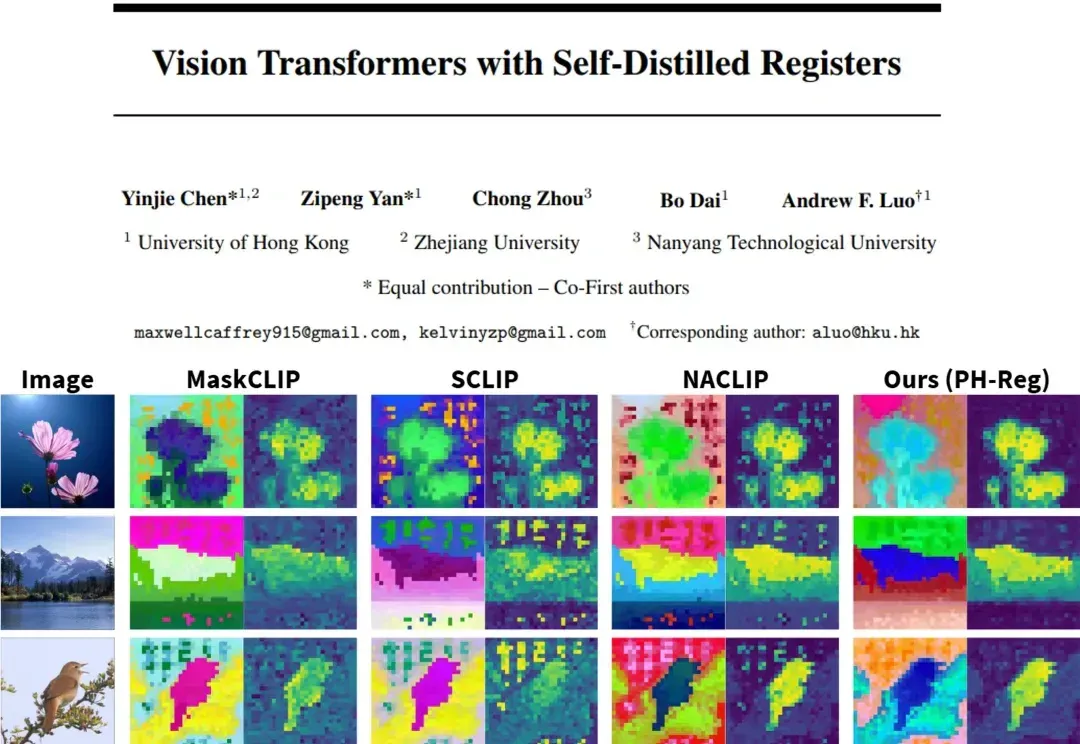
在视觉处理任务中,Vision Transformers(ViTs)已发展成为主流架构。然而,近期研究表明,ViT 模型的密集特征中会出现部分与局部语义不一致的伪影(artifact),进而削弱模型在精细定位类任务中的性能表现。因此,如何在不耗费大量计算资源的前提下,保留 ViT 模型预训练核心信息并消除密集特征中的伪影?

AI guides
0
超6亿融资!AI医疗技术公司完成B轮

超6亿融资!AI医疗技术公司完成B轮 (opens in a new tab)

2025年11月13日,创新医疗技术公司 Beacon Biosignals 宣布完成 8600 万美元(约合人民币6.1亿) B 轮融资,由 GV(Google Ventures)、Takeda、Catalio 等跨科技与生命科学领域的重磅机构联合投资,使公司累计融资突破 1.21 亿美元。

AI news
0
真机RL!最强VLA模型π*0.6来了,机器人在办公室开起咖啡厅

真机RL!最强VLA模型π*0.6来了,机器人在办公室开起咖啡厅 (opens in a new tab)

本周,美国具身智能创业公司 Physical Intelligence(简称 PI 或 π)发布了旗下的最新机器人基础模型 π*0.6。PI 是一家总部位于旧金山的机器人与 AI 创业公司,其使命是将通用人工智能从数字世界带入物理世界:他们的首个机器人通用基础模型名为 π₀,让同一套软件控制多种物理平台执行各类任务。

AI guides
0
VinciCoder:多模态统一代码生成框架和视觉反馈强化学习,数据代码模型权重已开源

VinciCoder:多模态统一代码生成框架和视觉反馈强化学习,数据代码模型权重已开源 (opens in a new tab)

长期以来,多模态代码生成(Multimodal Code Generation)的训练严重依赖于特定任务的监督微调(SFT)。尽管这种范式在 Chart-to-code 等单一任务上取得了显著成功 ,但其 “狭隘的训练范围” 从根本上限制了模型的泛化能力,阻碍了通用视觉代码智能(Generalized VIsioN Code Intelligence)的发展 。

AI guides
0