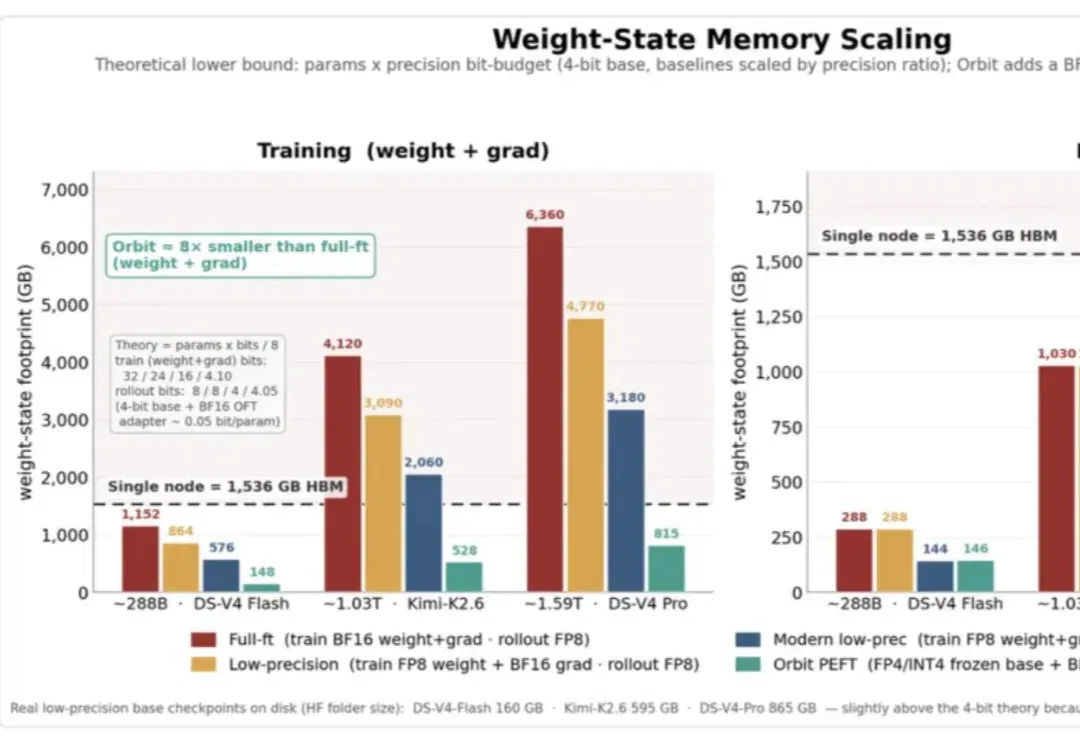
全球首次单机降服万亿巨模DeepSeek-V4!RL后训练框架Orbit开源! (opens in a new tab)
从数学、代码、复杂推理,到多轮工具调用,大模型的很多能力的提升都离不开 RL 后训练。但当模型规模进入 MoE 万亿参数级别之后,RL 不再只是一个算法问题,同时更加是一个系统问题。
Total 1519 articles
从数学、代码、复杂推理,到多轮工具调用,大模型的很多能力的提升都离不开 RL 后训练。但当模型规模进入 MoE 万亿参数级别之后,RL 不再只是一个算法问题,同时更加是一个系统问题。
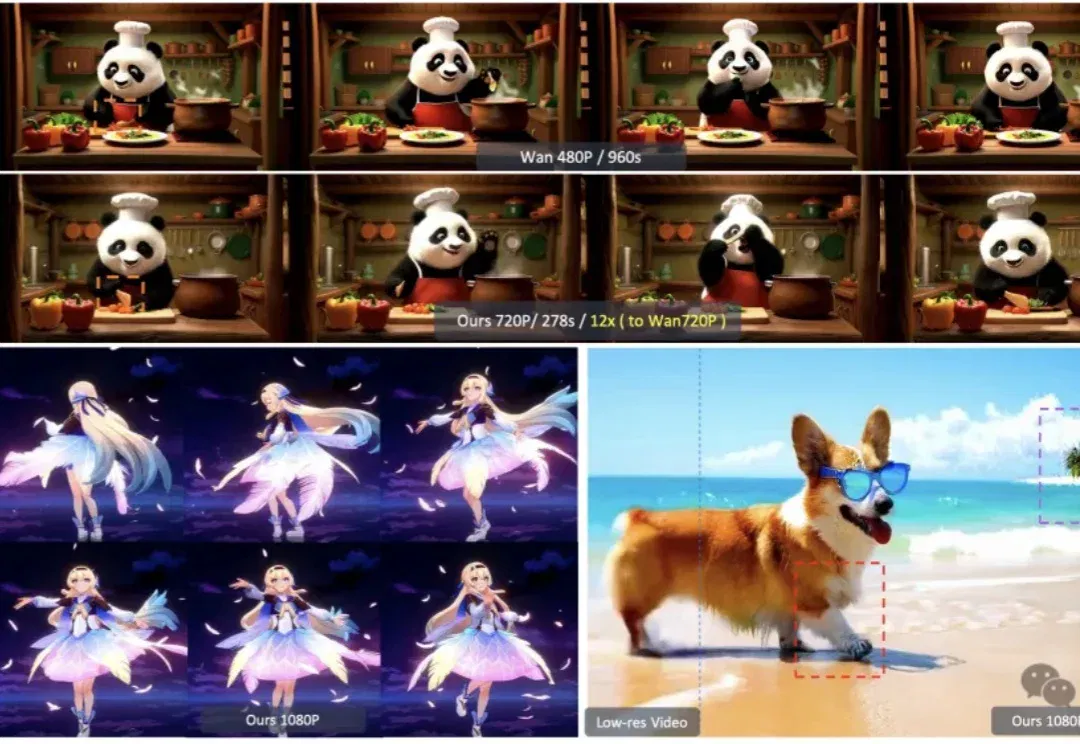
当下视频生成模型正在快速逼近真实世界的画面质感,但一个现实瓶颈也越来越突出—— 那就是分辨率越高,生成所需要的时间就越长。
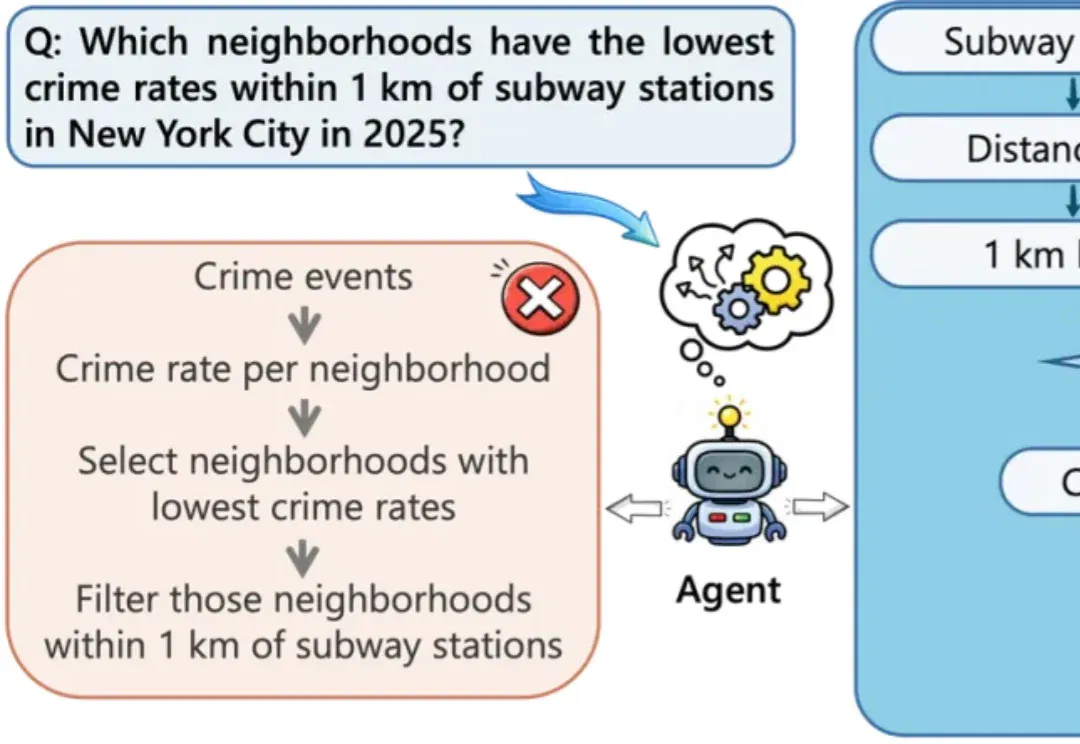
大语言模型在地图、城市、交通等空间领域的应用越来越广泛。对于这些场景来说,问题往往不只是 “查一个地点” 或 “调用一次路线 API” 就能解决的,而是需要把用户的自然语言问题组织成一段可执行、可验证的地理分析流程。
「建议出 480P」 从来没聊过可灵。 可灵给我的感觉,就像是老家那个县城刀枪炮同学。你对他只有个模糊的印象,知道他在特定场合很有能量,但平时办事也想不起来找他。 Be like:对的,我不像即梦一样做社交,我不像xx一样刷榜单,我只是专注服务专业创作者做专业视频的三专视频大模型一枚呀。你们普通用户对我没印象也正常的。 先前他们宣传的就是物理模拟、电影质感、长视频,反正就是暗示你,用别人家模型玩玩还行,真想做个正经片子还得找可灵。最近他们又上线了原生4K功能,可以说是继续朝着垄断商业化AI视频制作的方向显化中。 最近可灵又小火了一把,说是老外天天沉迷用它做什么韩女球场观赛视频,逼真程度又赶超英
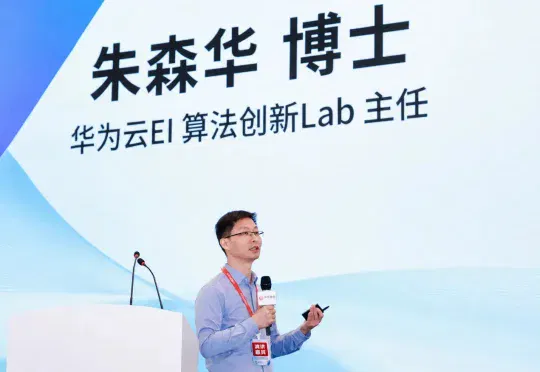
刚刚完成新一轮亿元融资的具脑磐石,从成立之初押注的正是这个方向。具脑磐石由朱森华创立。他曾任华为云AI算法创新Lab主任,主导过AI脑科学云平台、盘古具身大模型、全球具身智能产业创新中心等系统级项目。在业内,他被称为“华为具身大脑一号位”。
就在今天,美团龙猫大模型团队突然开源了商用级数字人视频生成模型 LongCat-Video-Avatar 1.5。在权威评测中,它的用户偏好胜率全面超越 Kling Avatar 2.0、OmniHuman-1.5 和 HeyGen 这三个头部玩家,并且直接以 MIT 协议开放,连商用限制都懒得设。
你猜一个能翻译33种语言、性能逼近顶尖闭源模型的AI,装进手机里需要多大?
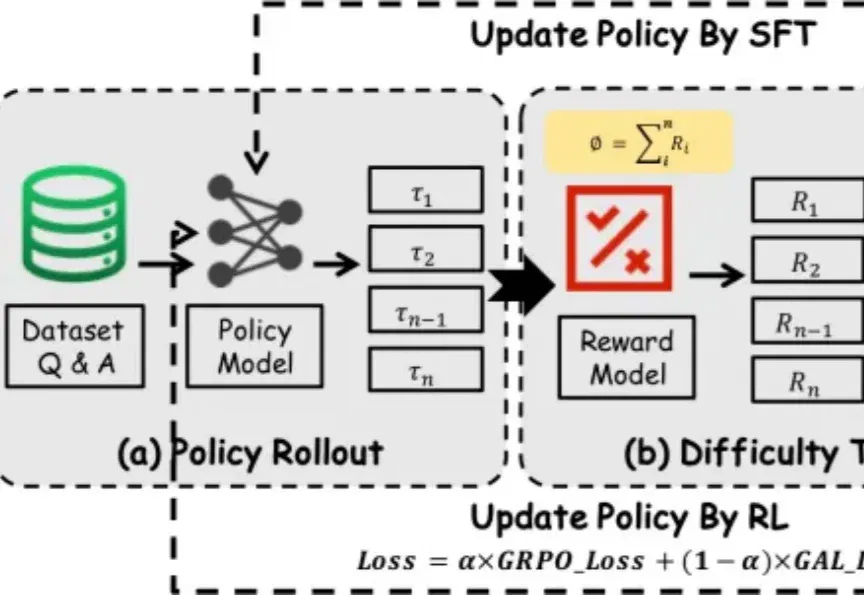
过去一段时间里,在围绕大模型推理能力增强的研究中,SFT 和 RL 是两类核心后训练范式 —— 前者稳定收敛快,能高效吸收高质量推理数据;后者更具探索性,有望推动模型实现复杂推理和分布外泛化。
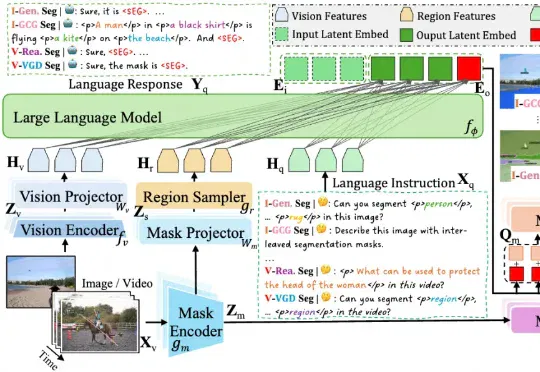
为了解决这一问题,来自中山大学和美团的研究团队提出了 X2SAM,一个统一的图像与视频分割多模态大模型框架。它希望让模型不仅能「看懂」图像和视频,还能进一步「指出」目标在每个像素上的准确位置。
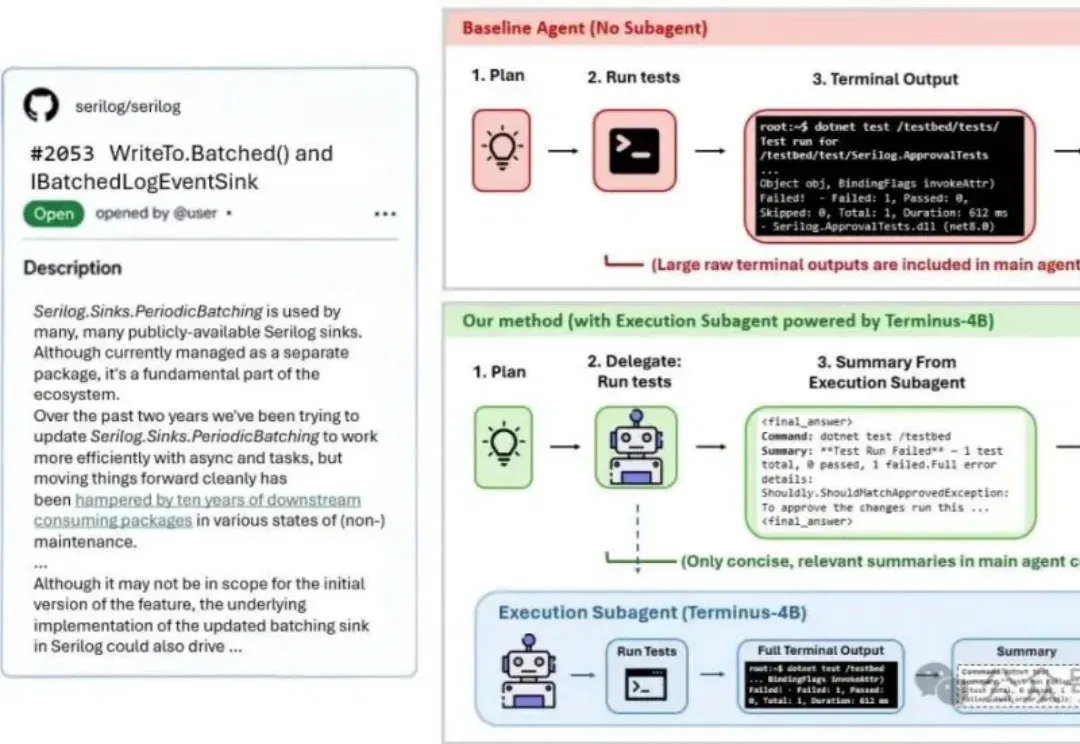
您有没有想过:在代码Agent里,执行终端命令、跑测试、读报错、总结日志这种任务,用Claude Opus、Claude Sonnet、GPT-5.3-Codex这类昂贵Token的大模型来执行,是不是有点浪费?一定要这么做吗?