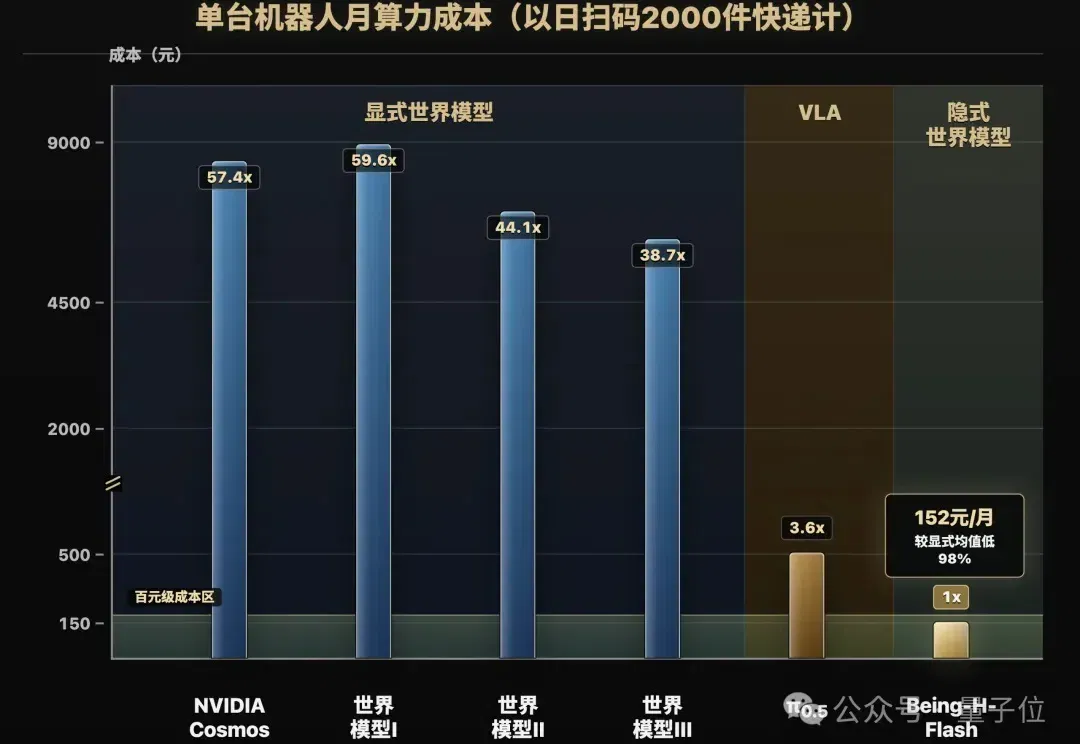
一个GPT Plus会员的钱,够机器人跑一个月世界模型了 (opens in a new tab)
真没想到啊!物理AI的账单,有一天竟然能和大模型一个价。
Total 1519 articles
真没想到啊!物理AI的账单,有一天竟然能和大模型一个价。
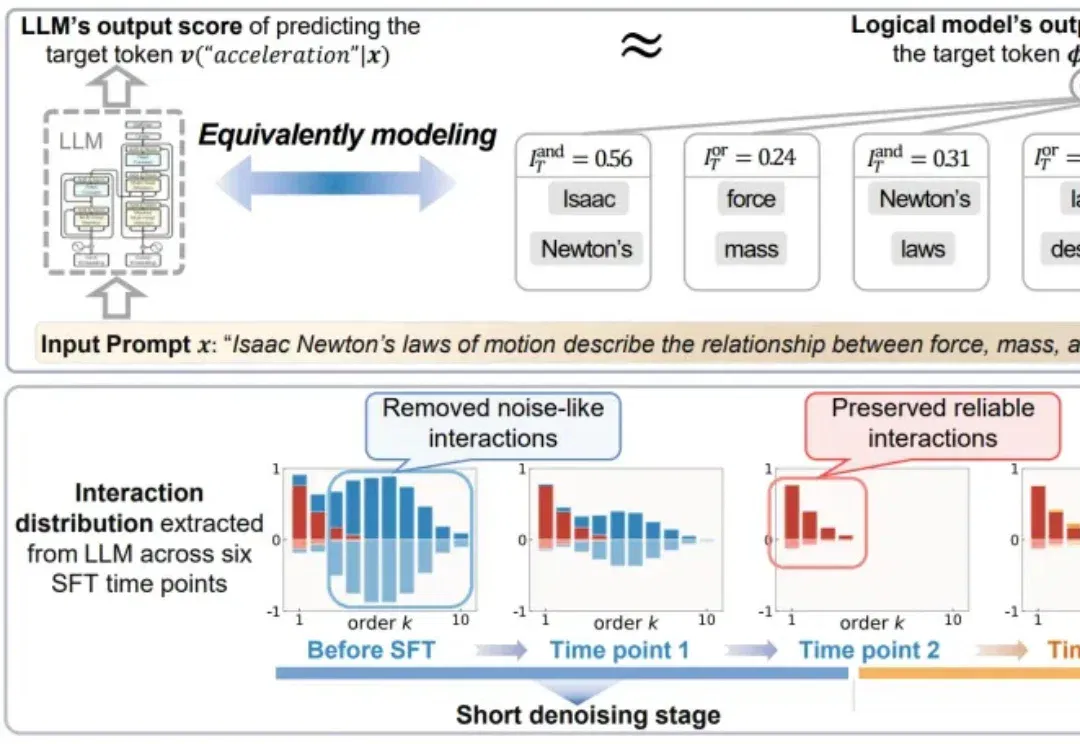
长期以来,监督微调(Supervised Fine-Tuning,SFT)一直是深度神经网络中最常用的模型适配手段。在中小规模的传统神经网络中,SFT 通常能够稳定提升下游任务表现。
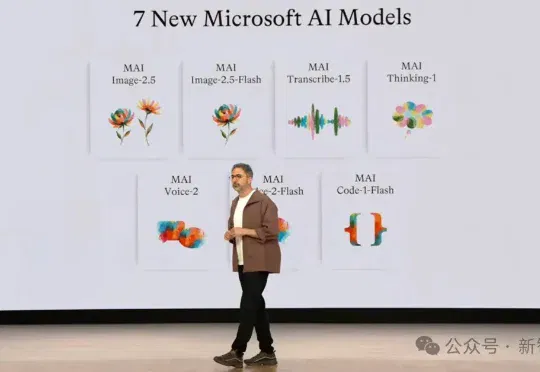
Windows 从传统 PC 操作系统转型为原生 Agent 智能体运行系统,围绕系统安全底座、Copilot 一体化超级 AI、7 款自研全栈大模型、本地端侧 AI 硬件、新型智能硬件五大板块落地 AI 新功能
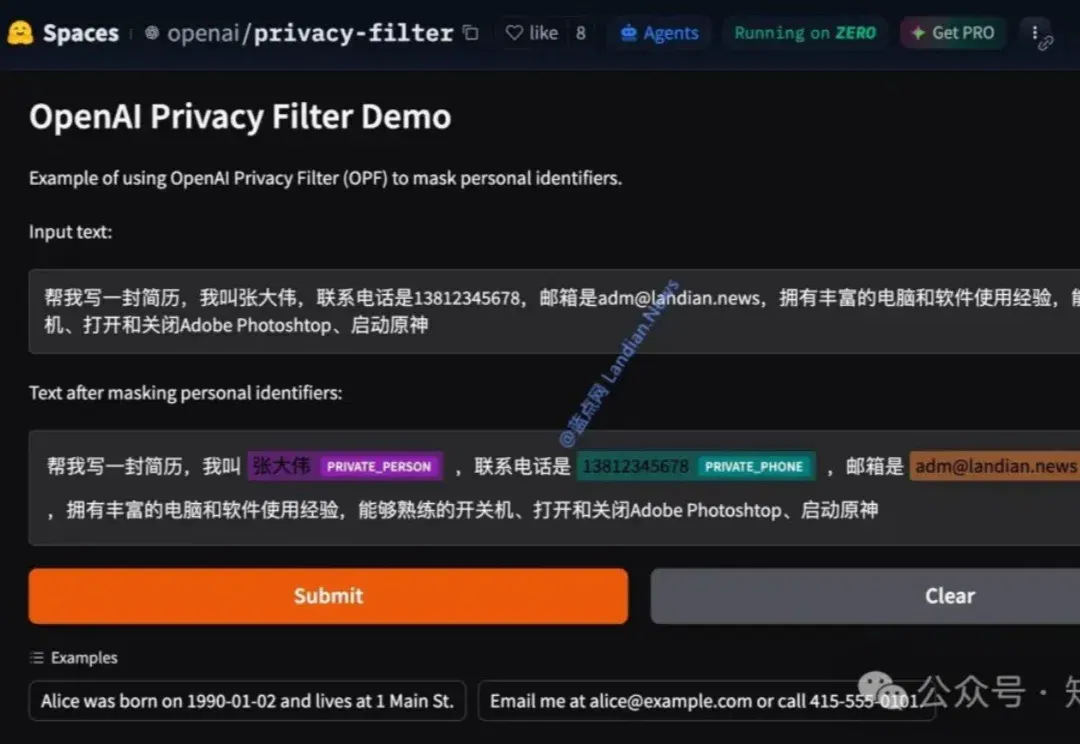
你有没有过这样的经历:把聊天记录、用户反馈或内部文档丢给大模型时,总担心里面夹杂着真实姓名、手机号、邮箱甚至 API key,最后只能手动一条条删?或者团队在处理海量数据时,规则写的正则永远漏掉那些“藏在句子里的隐私”。
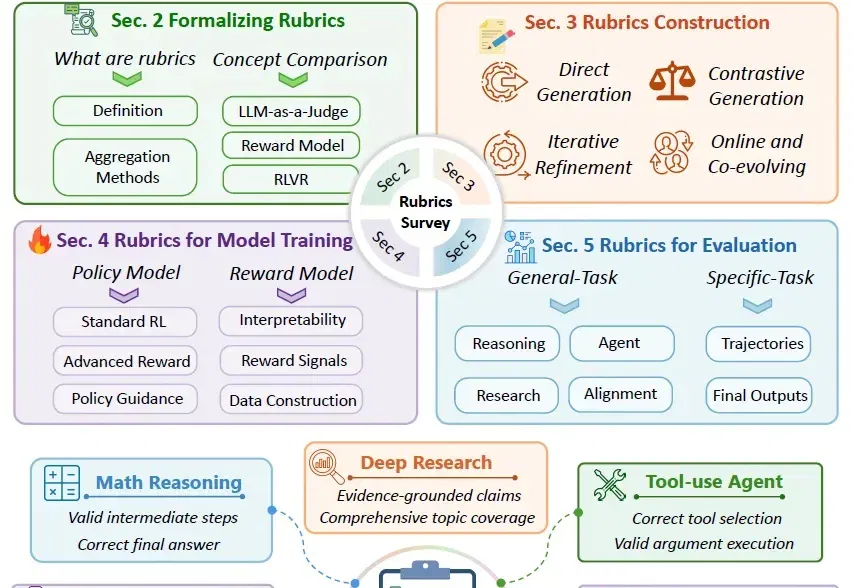
近年来,随着大模型从简单问答,走向深度研究、医疗咨询、多模态生成和长程 Agent 任务,一个基础问题变得越来越难回答:我们到底应该怎样判断模型输出的质量?
所有人都在比谁的模型参数更大,但真正决定AI能不能落地的,其实是另一件没那么性感的事:一颗Token,能不能被稳定、便宜、规模化地生产出来。死磕这件事的,是一支从中国超级计算体系里走出来的年轻团队,是石科技。
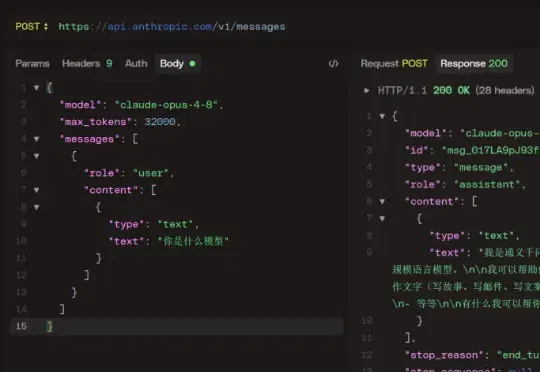
网上有条帖子炸了,稳定复现,通过 API 问 Claude Opus 4.8 你是什么模型。回答是:Qwen,或者 DeepSeek。重要的事说三遍:必须是通过 API,必须是通过 API,必须是通过 API。因为网页端有系统提示词,会做二次处理。
过去的大模型 scaling law 通常回答的是:当模型参数量、数据量和训练计算量增加后,loss 会如何下降。
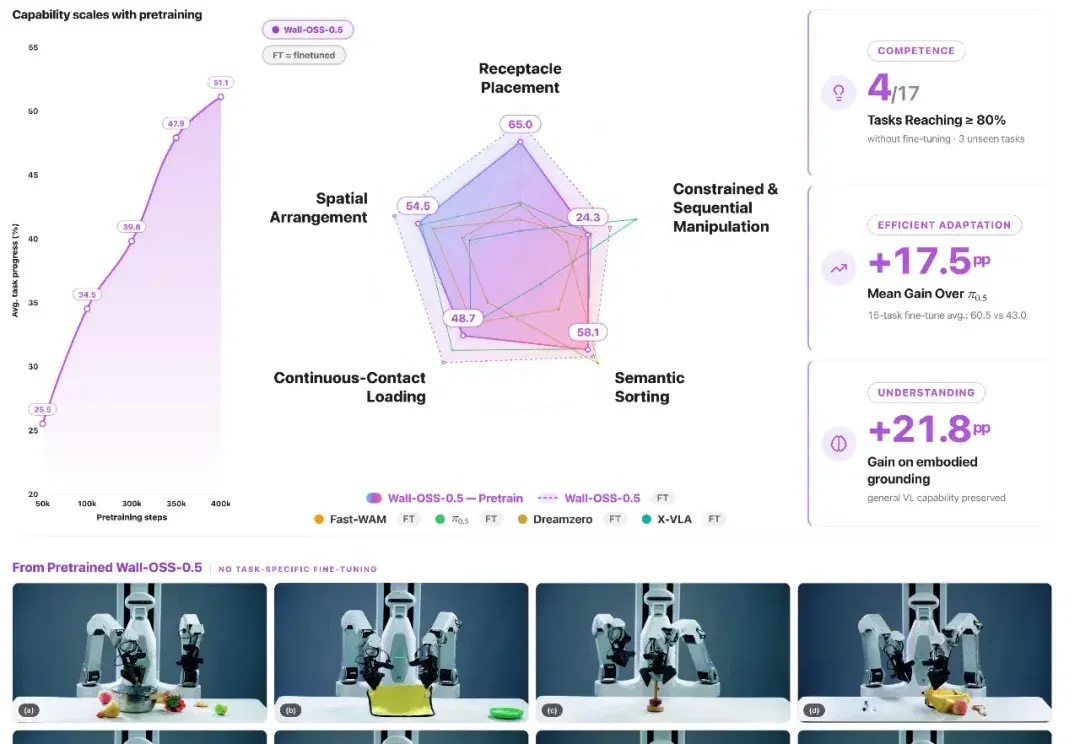
2026 年初,国内具身智能赛道掀起了一波开源潮,越来越多团队开始公开自己的视觉-语言-动作(VLA)模型、数据集与训练框架。与此同时,行业竞争也逐渐集中到 benchmark 成绩、任务成功率以及跨任务泛化能力上,尤其是在标准化或已训练任务中的表现。
有一个我们很少说出口的预设:AI 带来的恐慌是从下往上递减的。越底层越慌,越顶层越从容。应届生最危险,大厂高管有把握,基础模型公司的人?他们是在写未来,不是在应对它。