真实工作流,正在成为下一代训练数据 (opens in a new tab)
数据市场的故事,正在进入新一轮周期。来自企业真实工作流的 Real-world Data,成为越来越多 AI Labs 争夺的新资源。比如 GitHub 就是典型的 Real-world Data,它几乎完整保留了一个问题从出现到解决的全过程。相比之下,今天绝大多数 Human Data 公司提供的,仍是人为构造的数据。
Total 362 articles
数据市场的故事,正在进入新一轮周期。来自企业真实工作流的 Real-world Data,成为越来越多 AI Labs 争夺的新资源。比如 GitHub 就是典型的 Real-world Data,它几乎完整保留了一个问题从出现到解决的全过程。相比之下,今天绝大多数 Human Data 公司提供的,仍是人为构造的数据。
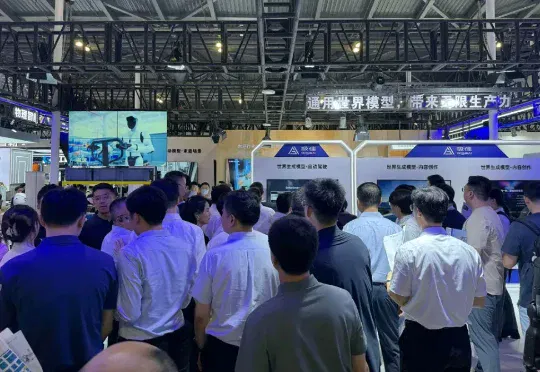
极佳视界把一套完整的「通用世界模型」产品矩阵摆到了现场:从面向内容创作的一粟 YiSu,到面向自动驾驶数据与仿真的 DriveDreamer;从面向具身智能的 GigaWorld,到负责把世界理解转化为行动的 GigaBrain 与 GigaWorld-Policy;再到进入家庭场景的拾光 S1,以及面向智能制造的 Maker H01。
WorldArena 1.0 的核心意义,在于将世界模型评测从 “好不好看” 推进到 “是否真的有用”。它不再只关注视频观感,而是把物理一致性、可控性、3D 准确性和具身任务功能性纳入统一评测框架,使许多看似流畅的生成结果第一次在机器人具身任务中接受检验。
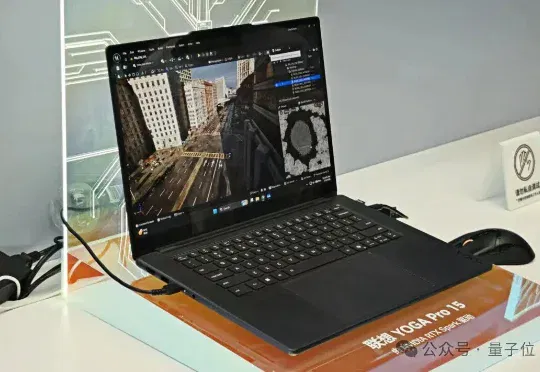
就在这届Bilibili World上,英伟达首次面向大众玩家展示了搭载RTX Spark超级芯片的笔记本电脑。这款芯片专为个人智能体打造,不仅搭载了Blackwell RTX GPU,连CPU也是出自英伟达的Grace CPU。
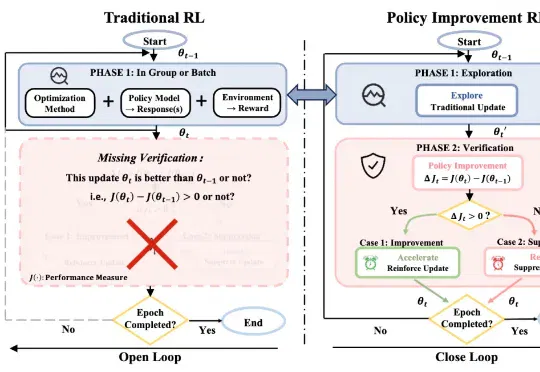
来自北航、北大、美团的研究团队提出了Policy Improvement Reinforcement Learning, PIRL,以及对应的落地算法 PIPO。这项工作关注的是大模型 RL 后训练中一个非常基础、但长期被默认跳过的问题:一次更新在当前数据上看起来优化了学习信号,是否就真的说明模型策略变强了?
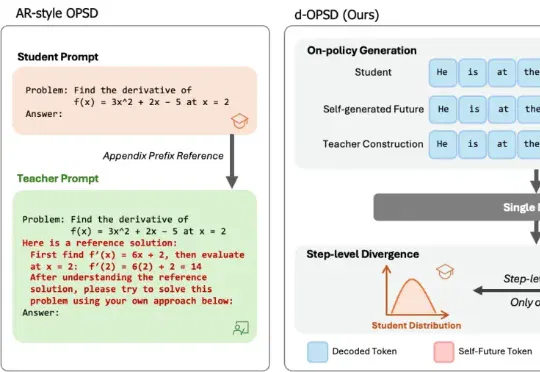
有没有一种更为合适的 OPSD 范式?近期,清华大学和马普所等机构的研究者们联合推出的 d-OPSD,给这一问题提供了完美的答案。这是第一个针对扩散大语言模型的 OPSD 范式,无需参考解,无需额外的教师模型,只需要 RL 十分之一的训练步数,便可以达到或超出 RL 的后训练效果。
最新世界模型 LingBot-World 2.0 正在试图实现的事情。「一个世界只需要几秒钟就能造出来」不再仅限于预制的世界,而是让每一次生成,都是一次全新的创造。这是一个秒级生成、支持实时交互的开源世界模型。
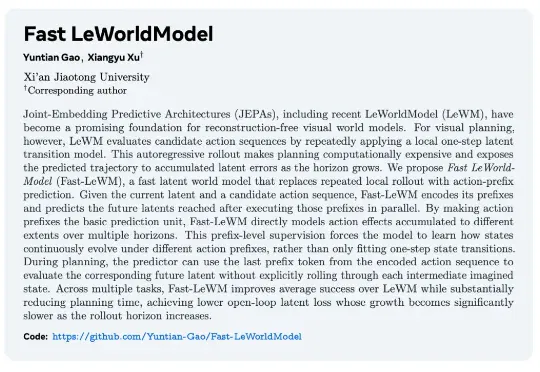
以 LeWorldModel(LeWM)为例,它在规划时有一个重要瓶颈:每评估一条候选动作序列,模型都要一步步自回归 rollout。也就是说,LeWM 先预测下一步 latent,再把预测出的 latent 输入 dynamics model,继续预测下一步:
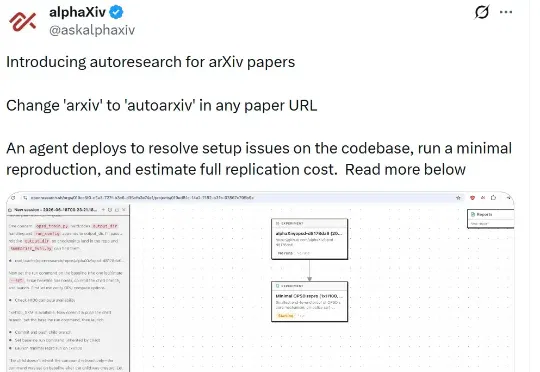
机器之心编辑部 AI 读论文这件事,正在进入下一个阶段。 最近,alphaXiv 推出了一个面向 arXiv 论文的 autoresearch 功能。 它的使用方式非常直接:当用户看到一篇论文时,只需要把论文 URL 里的「arxiv」改成「autoarxiv」,系统就会:
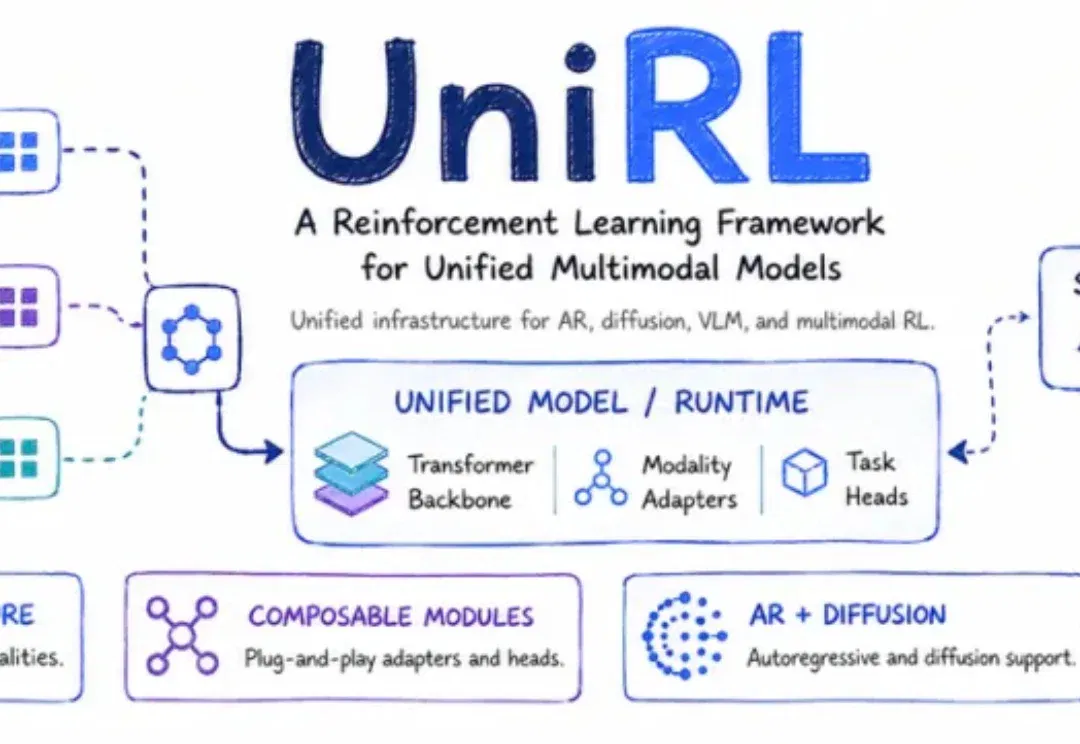
大语言模型的RL技术已日趋成熟,多模态生成模型的强化学习训练却仍在“各自为战”——图像扩散模型一套流程、视频生成另一套标准、VLM和LLM又有不同的技术栈。