智谱 5.3-flash 成了新的斩杀线 (opens in a new tab)
这几天 ox-alpha 用爽了吧...正如很多人猜的那样,这个模型来自智谱,正式名称为 glm-5.3-flash,支持多模态,但很多人没猜到的是:这个乱杀的模型只有 321B,且与 glm-5.3 不同,是完全的新架构
Total 235 articles
这几天 ox-alpha 用爽了吧...正如很多人猜的那样,这个模型来自智谱,正式名称为 glm-5.3-flash,支持多模态,但很多人没猜到的是:这个乱杀的模型只有 321B,且与 glm-5.3 不同,是完全的新架构
“你以为你买的是 DeepSeek Flash,实际上可能是个 1.5 bit 的 DeepSeek,或者里面掺了 Opus 用于训练。”这是 Pi 核心贡献者 Armin Ronacher 的一个比喻。他形容现在的 token 市场像一种成分不明的商品——量化程度、实际版本、是否掺了别的东西、计费方式,全是黑洞。
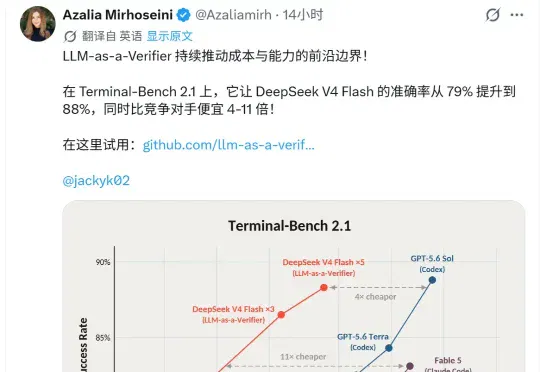
同样的模型,同样的任务,让它执行五遍,再让他自己挑一遍最稳的,效果能有多大提升?斯坦福把这套玩法用在了AI身上,DeepSeek V4 Flash在Terminal-Bench 2.1的成绩从79%一路涨到88%,反超了尖子生Fable 5。而且连做五遍加挑选这一通折腾,价格依然比Fable 5便宜了4-11倍。
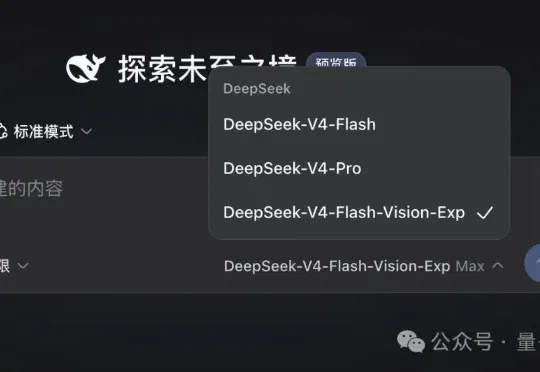
等了四个月,DeepSeek的多模态模型:deepseek-v4-flash-vision-exp,终于发布。我也是第一时间赶到现场,连夜开始实测。相比V4 Flash最大的不同,就是支持原生支持图片输入了,但图片生成当然还是没有的。
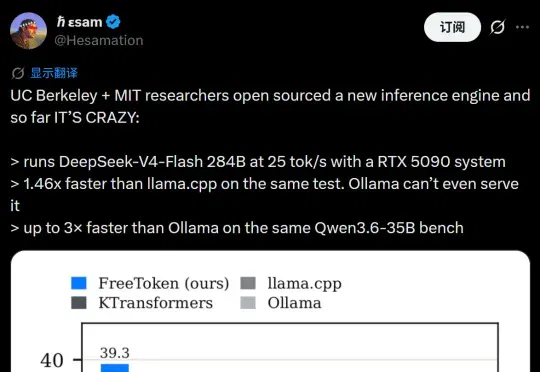
本周五,AI 社区热烈讨论的是一个端侧大模型部署技术,它能让笔记本 RTX 4060 跑 Qwen 3.6-35B,桌面 RTX 5090 跑得起 DeepSeek-V4-Flash 284B。而且都是单卡,模型都是满血的。Codex 生产 trace 的中位 decode 速度是 33 token/s
DeepSeek 终于「开眼」了。就在刚刚,DeepSeek 推出了一款面向 Agent 时代的多模态模型:deepseek-v4-flash-vision-exp。目前,该模型已经上线 DeepSeek API 平台上,用户可以通过设置 model='deepseek-v4-flash-vision-exp' 访问该模型。
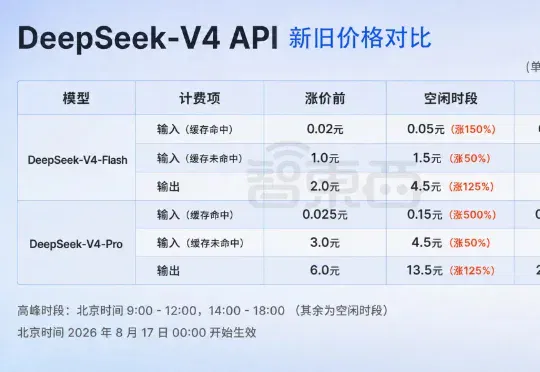
今日零时起,DeepSeek正式执行新版API价格,DeepSeek-V4-Flash和DeepSeek-V4-Pro两款主力模型首次采用峰谷定价,闲时价格统一为高峰时段的一半。此次调整同步抬高了两款模型的基础价格。DeepSeek-V4-Flash高峰时段每百万Tokens缓存命中输入、缓存未命中输入和输出价格分别为0.1元、3元和9元,闲时分别降至0.05元、1.5元和4.5元。
DeepSeek刚刚做了一件很多人没想到的事:准备涨价。DeepSeek通过用户后台发布通知:靠低价打穿市场的DeepSeek,为什么突然开始涨价了?V4-Flash正式版7月31号发布,到今天满打满算也就一周时间,仅仅一周,因为极低的 API 成本和接近旗舰模型的能力,V4-Flash 的调用量直接飞升到全球第一,高峰期接口频繁超时。
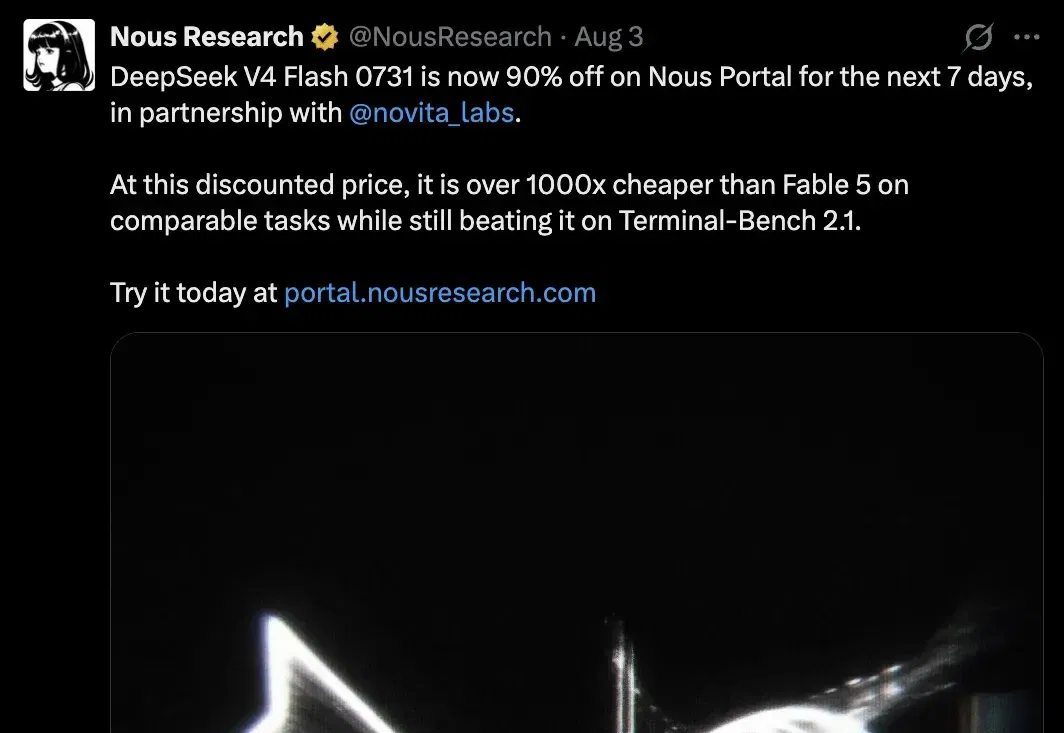
DeepSeek V4 Flash的价格风暴,还在继续。
其实 Codex 和 Claude Code 都支持切换模型,咱们直接用 DeepSeek-V4-Flash 来驱动它们就行,量大管饱、不用魔法、也不怕封号。而且现在 DeepSeek 官方已经做了原生适配,接入流程比以前简单多了。