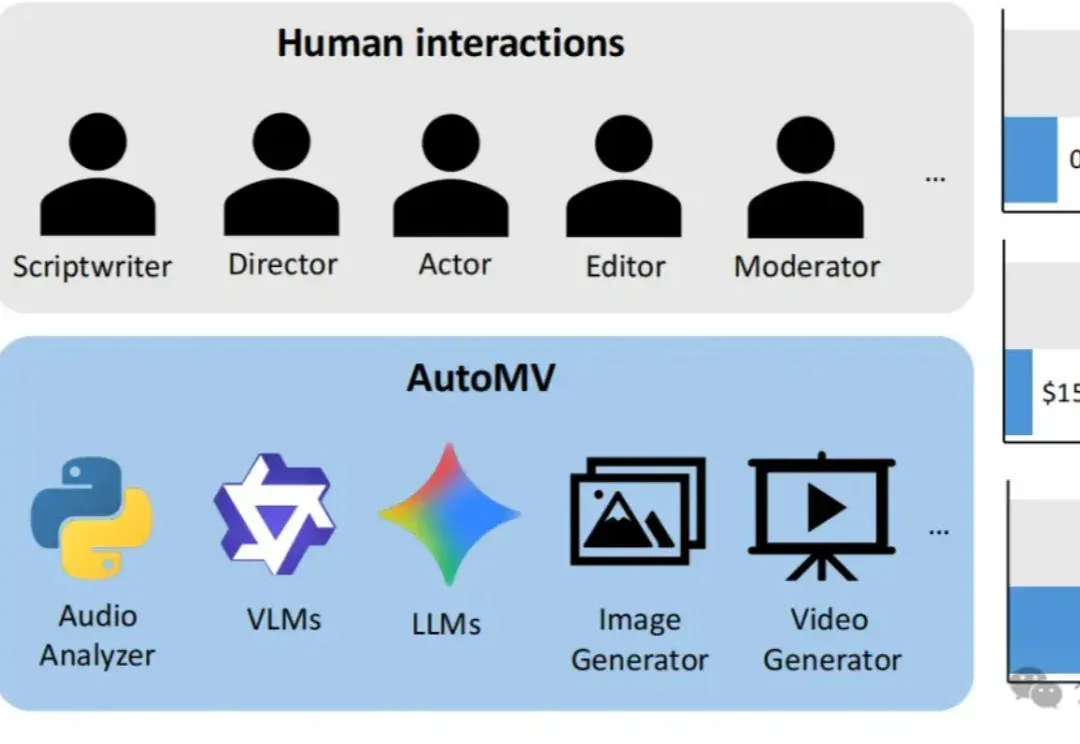
告别“音画割裂”与“人物崩坏”!AutoMV:首个听懂歌词、卡准节拍的开源全曲级MV生成Agent (opens in a new tab)
现有的AI视频生成模型虽然在短片上效果惊人,但面对一首完整的歌曲时往往束手无策——画面不连贯、人物换脸、甚至完全不理会歌词含义。
Total 76 articles
现有的AI视频生成模型虽然在短片上效果惊人,但面对一首完整的歌曲时往往束手无策——画面不连贯、人物换脸、甚至完全不理会歌词含义。
半年累计融资近60亿元。 智东西8月19日报道,昨天,据彭博社援引知情人士消息报道,北京视频生成模型独家收生数科技正考虑赴港IPO,募资金额可能超过5亿美元(约合人民币33.7亿元),该公司已与中金公司、中信证券两家投行展开合作。 其中一位知情人士称,生数科技的IPO可能于明年完成,相关讨论仍在进行中,规模和时间等具体细节可能仍有变动。截至发稿,生数科技、中金公司、中信证券暂未回复置评请求。 生数科技成立于2023年3月,由瑞莱智慧(RealAI)、蚂蚁集团与BV百度风投联合孵化。该公司创始人团队均具清华大学背景:创始人兼首席科学家朱军现任清华大学人工智能研究院副院长;联合创始人兼首席技术官鲍
再牛的大模型,也要放到行业面前公开露个面,才算真交卷。
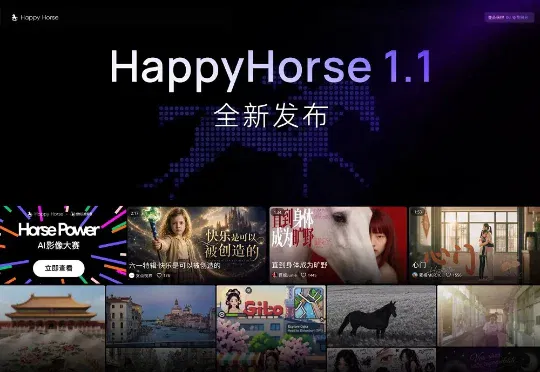
今天,阿里巴巴发布了其最新一代视频生成模型HappyHorse 1.1(快乐小马1.1)。阿里称,相比HappyHorse 1.1,这代模型在动态表现力、主体一致性、指令遵循、视觉质感和音频能力等维度有了一定提升。
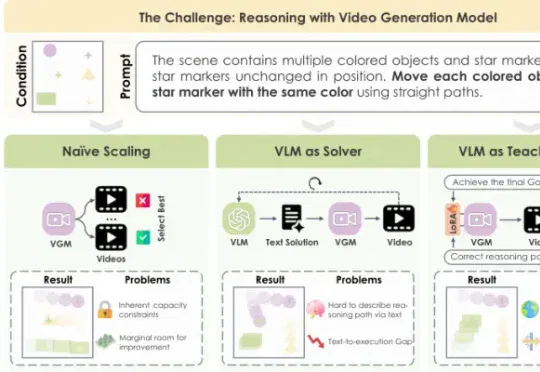
怎么让VGM学会按规则推理?过去主要有两条路。两条路,一个不动模型,一个只写文字,都没真正解决“执行”问题。为此,城大×快手可灵提出了第三条路:VLM-as-Teacher。
就在今天,美团龙猫大模型团队突然开源了商用级数字人视频生成模型 LongCat-Video-Avatar 1.5。在权威评测中,它的用户偏好胜率全面超越 Kling Avatar 2.0、OmniHuman-1.5 和 HeyGen 这三个头部玩家,并且直接以 MIT 协议开放,连商用限制都懒得设。
随着豆包大模型和seedance视频生成模型等业务的爆发,自研芯片成功后,字节有望大大降低其算力成本。
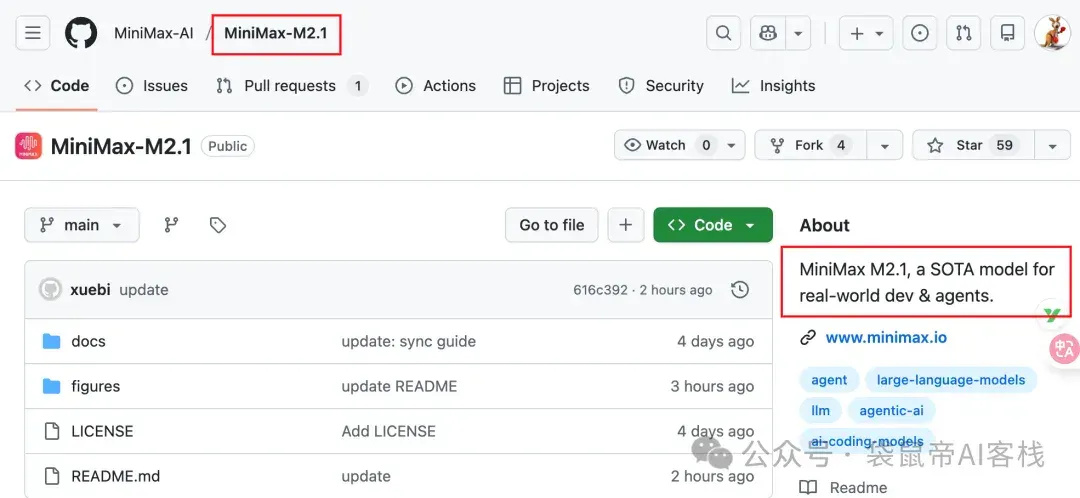
上周我还在折腾各种图片、视频生成模型,这周又到了编程周。前天MiniMax丢出了个在编程界绝对有分量的模型:MiniMax-M2.1。然后发现就在刚才已经开源了:
腾讯混元大模型团队正式发布并开源HunyuanVideo 1.5。
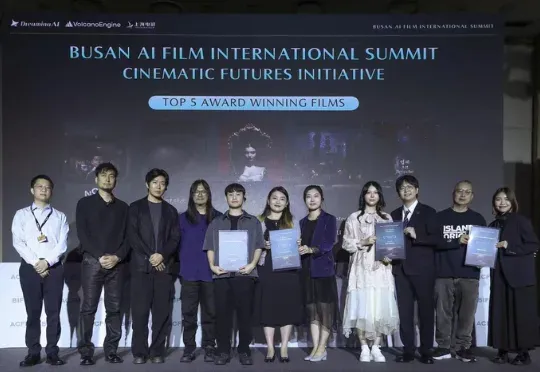
我一个 AI 圈的,为啥会关注到电影圈呢?倒不是因为我爱看电影,而是因为电影节的放映单元,突然冒出来了我们圈子里几个“老熟人”:Seedream(图像创作模型)、Seedance(视频生成模型)、即梦 AI。