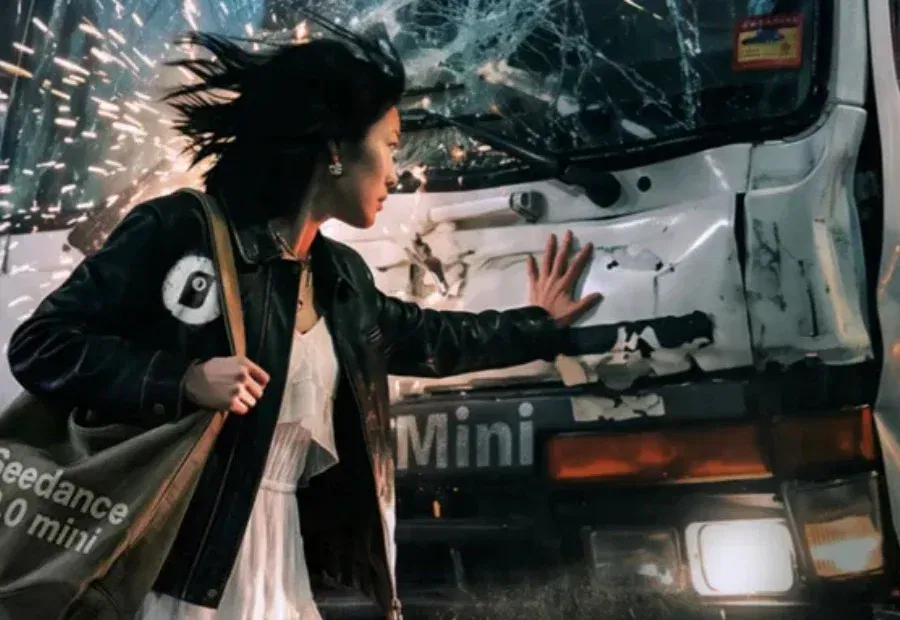
字节最便宜视频模型Seedance 2.0 Mini来了!1.6毛/秒,比Fast快,实测让黄仁勋和豆包一起踢球 (opens in a new tab)
昨晚,字节新模型Seedance 2.0 Mini深夜来袭,该模型主打性价比,侧重于提供更低的价格以及更快的生成速度。Seedance 2.0 Mini虽然定价更低,但保留了核心能力参考生成,用户可以通过融合提示词与最多12个多种模态的参考素材(包括6张图片、3段音频、3段视频)来锁定人物一致性、精细化控制运动轨迹、卡准剧情节奏。
Total 109 articles
昨晚,字节新模型Seedance 2.0 Mini深夜来袭,该模型主打性价比,侧重于提供更低的价格以及更快的生成速度。Seedance 2.0 Mini虽然定价更低,但保留了核心能力参考生成,用户可以通过融合提示词与最多12个多种模态的参考素材(包括6张图片、3段音频、3段视频)来锁定人物一致性、精细化控制运动轨迹、卡准剧情节奏。
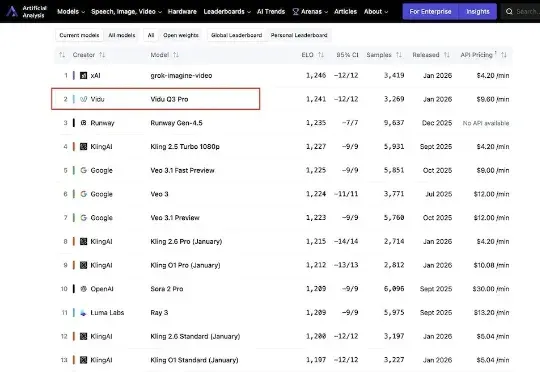
今日,来自生数科技的AI视频模型Vidu Q3 Pro登上国际权威AI基准平台Artificial Analysis榜单,位列中国第一,全球第二。这是最新榜单内,首个打入国际第一梯队的国产视频生成模型。
前段时间某视频模型更新 2.0 的时候,写了一篇文章,其中提到了一个观点:用户不需要第二个 AI 视频的抖音。这次核心不是模型能力提升,不是 AI Feed 流,而是底层模型能力提升带来的全新「创意社交」玩法。
自 Sora 亮相以来,AI 视频的真实感突飞猛进,但可控性仍是瓶颈:模型像才华横溢却随性的摄影师,难以精准执行 “导演指令”。我们能否让 AI 做到: 仅凭一张静态照片,就能 “脑补” 出整个 3D
英伟达联合MIT和牛津大学团队提出Physis-Lang,通过物理语言描述、自进化准则和能力导向的数据检索提升视频模型的物理理解与生成表现,其Cosmos3-Super和Cosmos3-Nano在Physics-IQ Verified分列第一、第二。
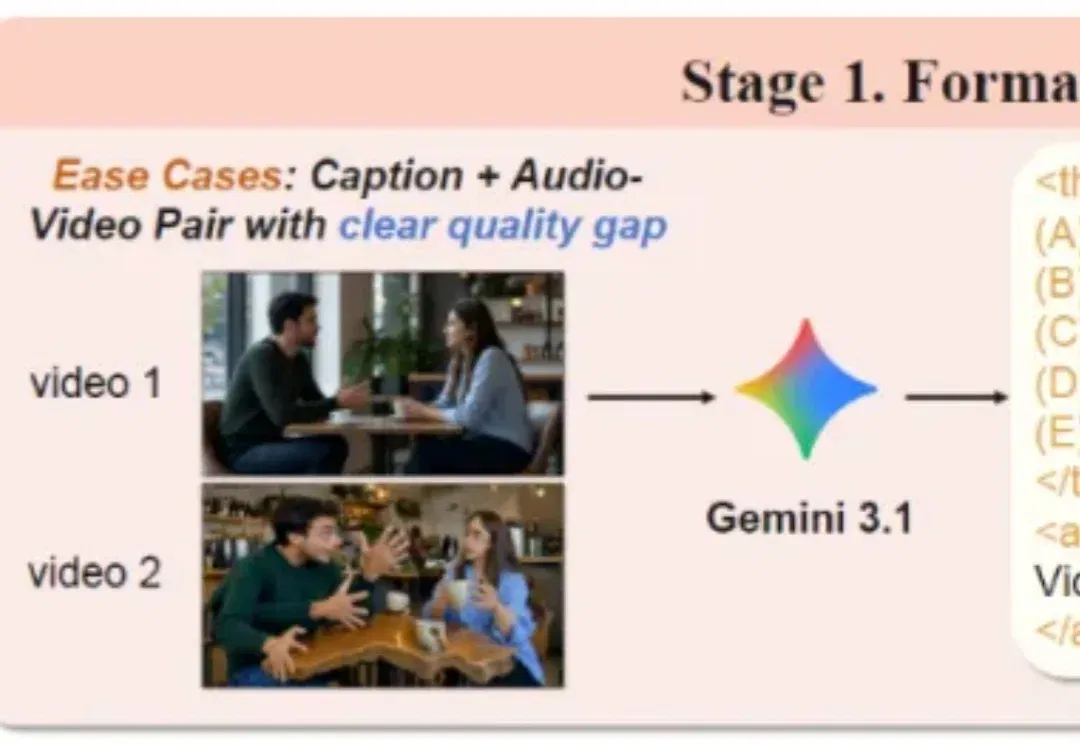
现有的音视频奖励模型,能通过局部指标捕捉到画质或同步上的优势,却往往忽略声音失真、台词与提示不符,以及动作和语音配合不自然等问题。
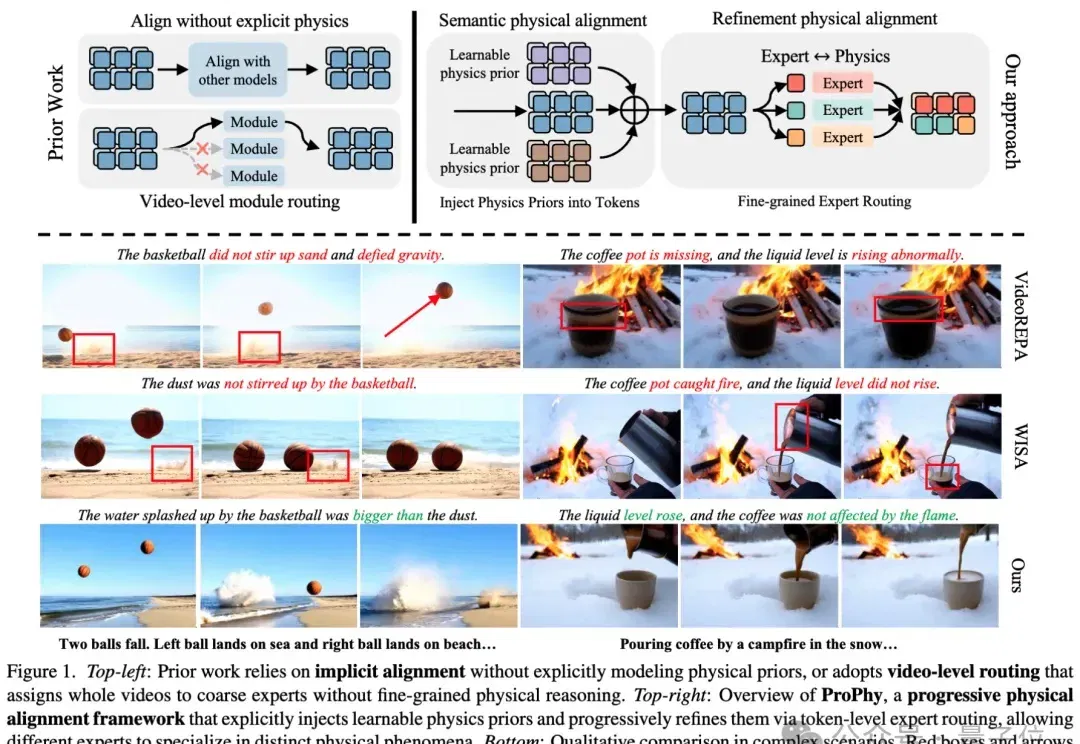
当人们谈到“世界模型”(World Models)时,很多人会首先想到近年来迅速发展的生成式视频模型。
据 The Informaton 报道,字节跳动已经暂缓了视频生成模型 Seedance 2.0 的全球发布计划。背后的导火索,是一连串来自好莱坞头部片厂和流媒体平台的版权争议。
这两周,字节新发布的 AI 视频模型 Seedance2.0 特别火,真正的全民热议。 我给我爹看了几个模型生成的视频,他的反应特别有代表性。看完以后他跟我说了一句话:「你别胡说八道,这就是真人啊。」
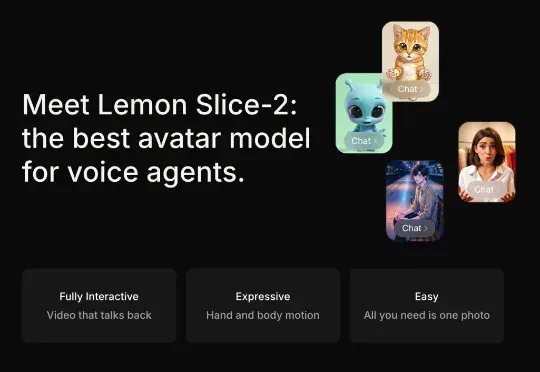
他们开发了一个叫做 Lemon Slice-2 的 AI 模型,可以把任何一张静态图片——无论是公司员工照、卡通角色、还是文艺复兴时期的油画——瞬间变成一个能实时对话的视频头像。