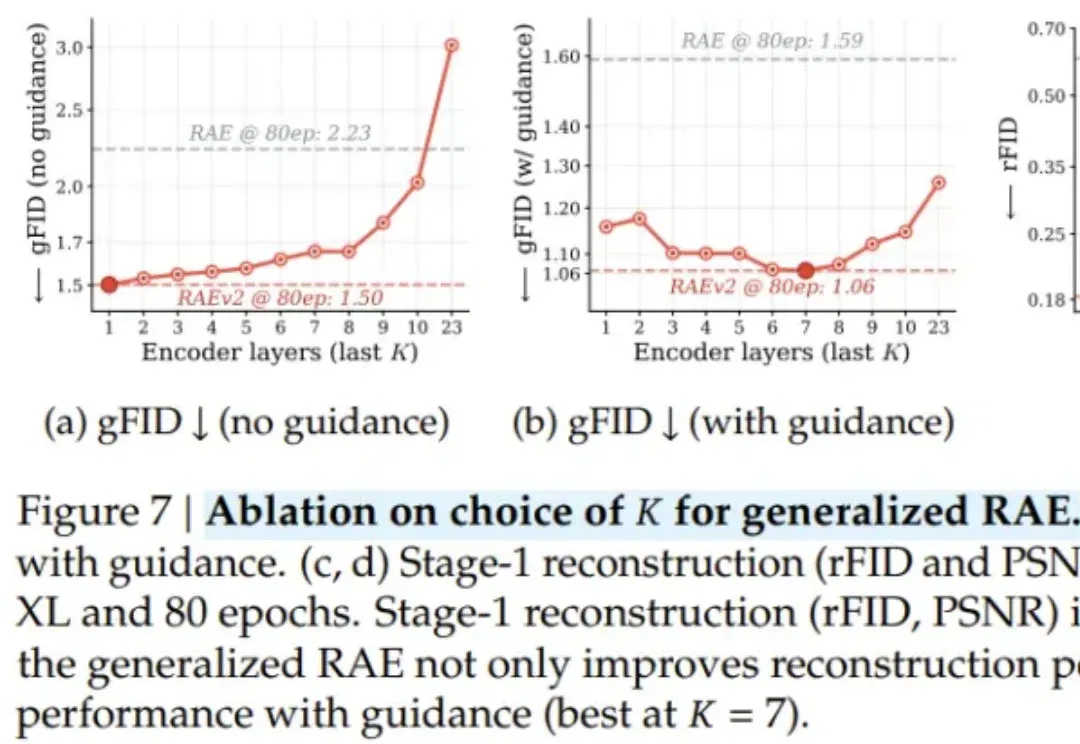
刚刚,谢赛宁团队放出第二代表征自编码器 RAEv2 (opens in a new tab)
AI 图像生成通常遵循「能力越强、代价越高」的铁律;与此同时,学界却在悄悄质疑另一个更根本的浪费:传统 VAE 对图像语义几乎一无所知,而 DINOv2、SigLIP 等视觉编码器早已从数亿张图片中习得了丰富的视觉常识。图像生成模型,真的需要从零开始「发明」对图像的理解吗?
Total 8436 articles
AI 图像生成通常遵循「能力越强、代价越高」的铁律;与此同时,学界却在悄悄质疑另一个更根本的浪费:传统 VAE 对图像语义几乎一无所知,而 DINOv2、SigLIP 等视觉编码器早已从数亿张图片中习得了丰富的视觉常识。图像生成模型,真的需要从零开始「发明」对图像的理解吗?
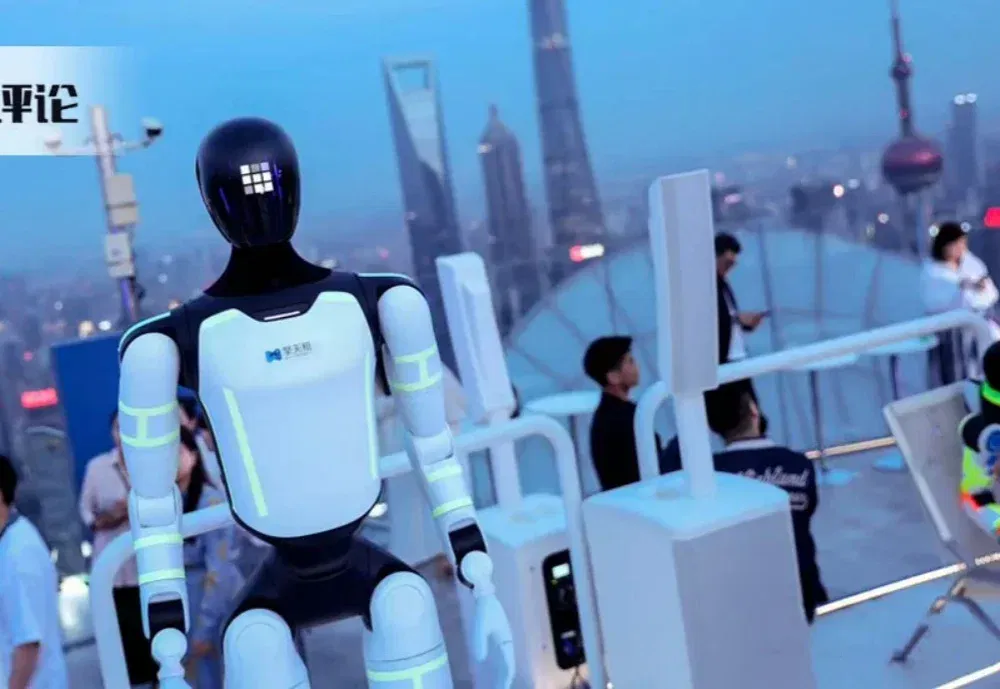
机器人租赁,开始从流量走向生产力。 AI 科技评论独家获悉,擎天租已于近期完成A轮及A+轮融资,融资金额达数亿元。本轮融资完成后,擎天租估值达到70亿元,正式跻身独角兽企业行列。 擎天租成立于2025年12月,定位机器人即服务(RaaS)平台,提供机器人本体直租及场景解决方案租赁服务,目前已接连斩获六轮融资,融资节奏十分迅猛。 与上一阶段主要围绕文旅、商演、展会、商业营销等展示型和互动型场景不同,本轮融资后,擎天租将进一步把业务重心推向更高频、更刚需的产业场景。 擎天租方面表示,本轮融资将重点用于RaaS(Robot as a Service,机器人即服务)体系建设和工业等场景拓展,推动机器人
哈喽,大家好,我是刘小排。 我今天花了很多时间,反复学习了两个 YC 的创业课程,越看越觉得有意思,越看越激动。
让 AI 来管理代码的话,每次读 500 行反而比读 1000 行更费 Token,而且人工编排流程真不如让大模型自己定,「很多的事儿,还是很反直觉的」
学术圈的震中,是一个叫“耿同学讲故事”的B站up主。36天时间里,他连续实名举报了5位985高校院长级学者的论文造假,被点名的无一例外都是手握国家杰出青年科学基金和“长江学者”等头衔的资深学者。
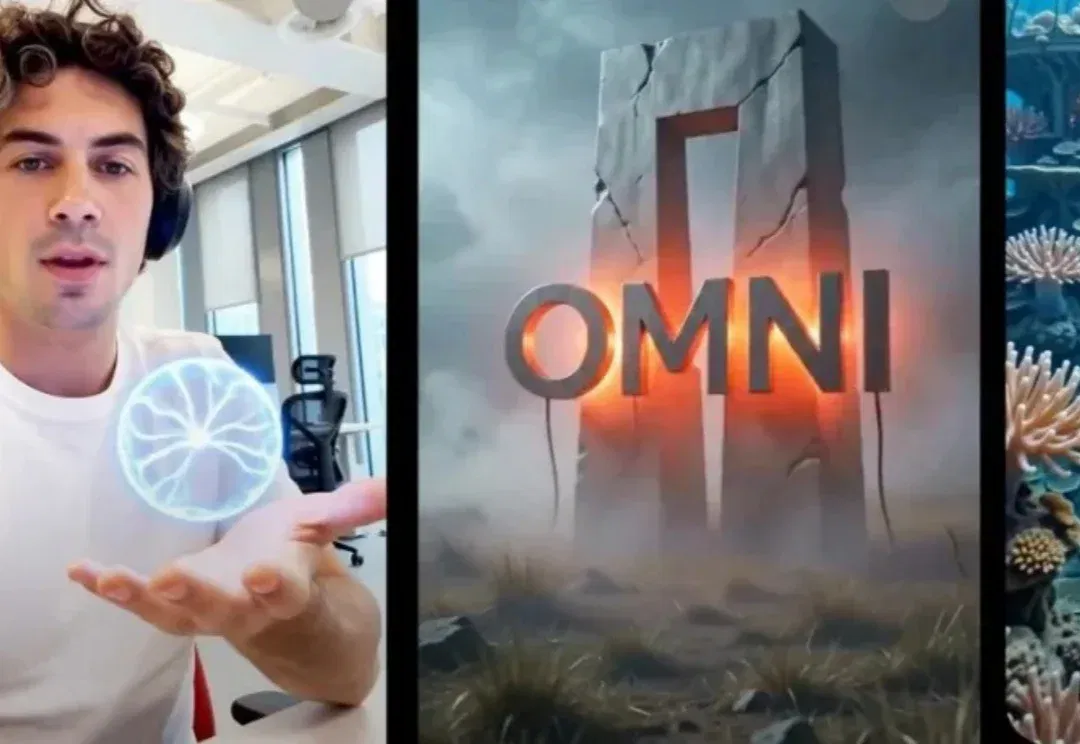
过去AI视频是「生成内容」,Omni直接升级成「生成世界」。它懂动能、重力、因果,还能把复杂概念瞬间可视化。人类距离「言出法随」的梦想,还剩几个Gemini Omni的距离?
5月初的一个上午,我走进杭州西溪附近的一间办公室,眼前的人被同事叫醒,从地板上爬起来。头戴一顶深灰色、紧紧包住脑袋的绒布帽,上身是一件紫色紧身短袖上衣,露出清晰可见的肌肉线条,而下身是一条黑色长裙。
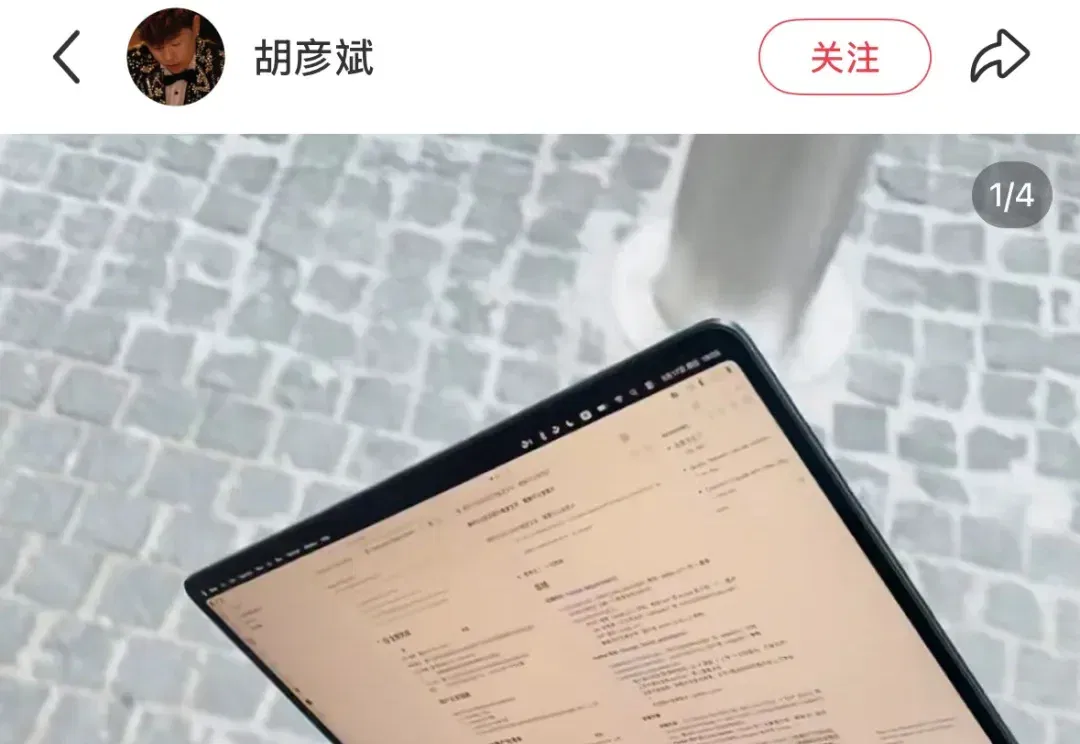
前天,胡彦斌发了一条小红书。 人在路上,MacBook 摊在腿上,屏幕里是 VS Code 加 Claude Code 的插件,配文一句:正在 AI Vibe Coding。 当然也有人说作秀,不过,至少姿势看着还挺专业的。 评论区直接热闹起来,有个网友顺手把他的歌改了一遍 —— 「你要的 token 全拿走,把 memory 化成空。不要在乎 model context 有所保留,说过的话当 skill 附送。」 整个画风非常抽象。 但你仔细看大家讨论的点,会发现核心争议在另一个地方:「一个音乐人怎么也来抢程序员饭碗了」。 可如果你翻一翻各个社区,你会发现还有相当一部分人对 Vibe Cod
先说明一点,我并不是要挑起Windows和Mac的对立,这篇文章我只讲事实和逻辑。
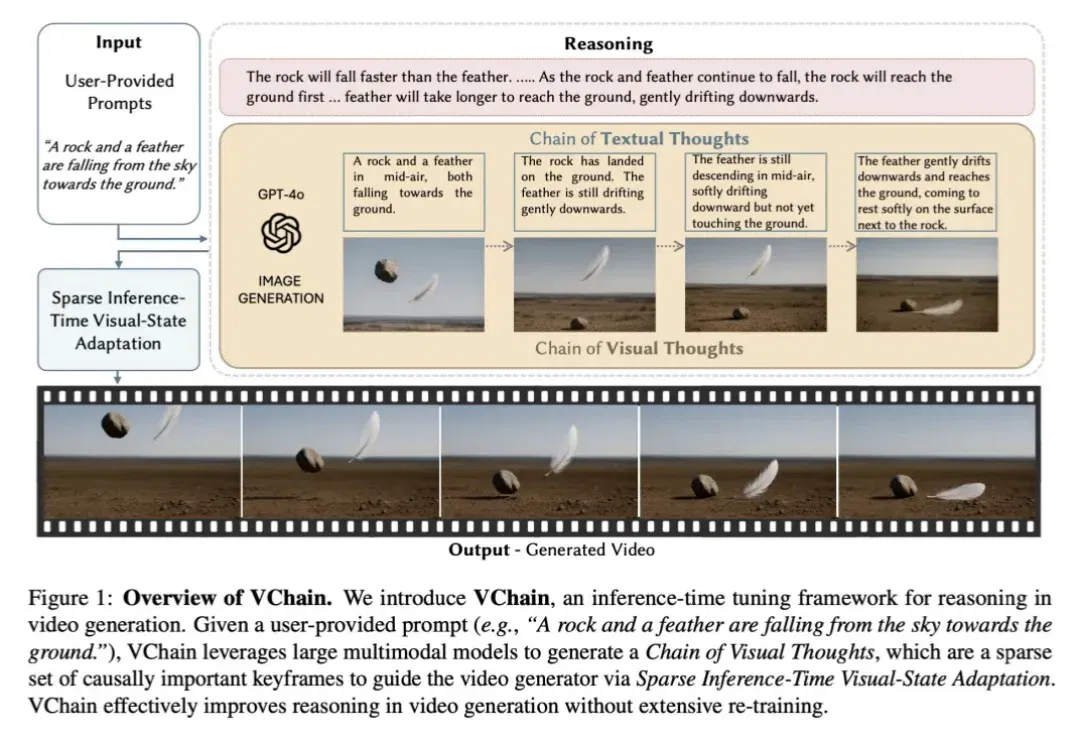
当视频生成模型在视觉保真度上不断突破时,一个核心瓶颈正变得愈发清晰:模型是否真正理解了真实世界?能否推理出合理的演变过程?