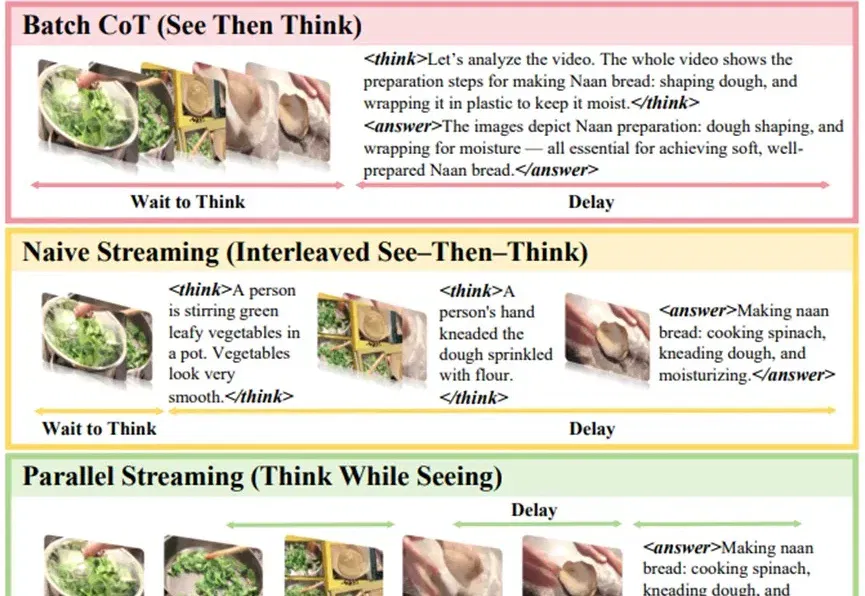
打破视频推理「先看后想」惯性,实现真正的「边看边想」丨CVPR'26 (opens in a new tab)
今天的大型视觉语言模型(VLM)做离线视频分析很强,但一到实时场景就尴尬: 视频在往前走,模型还在“补作业”。
Total 68 articles
今天的大型视觉语言模型(VLM)做离线视频分析很强,但一到实时场景就尴尬: 视频在往前走,模型还在“补作业”。
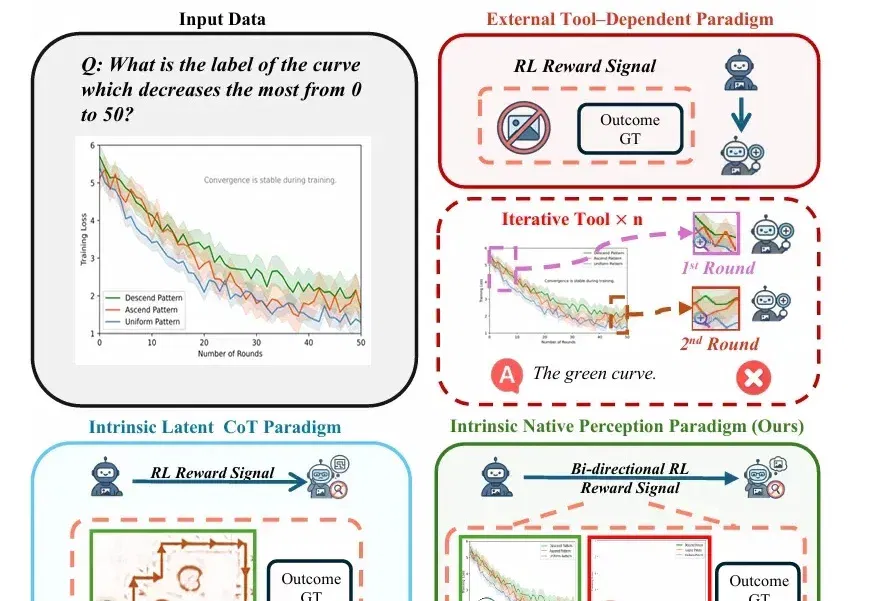
随着视觉-语言模型(VLM)推理能力不断增强,一个隐蔽的问题逐渐浮现: 很多错误不是推理没做好,而是“看错了”。
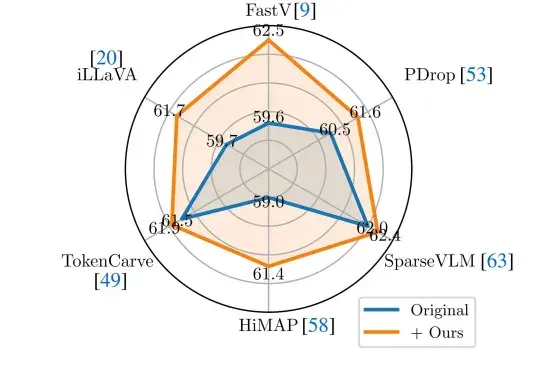
近年来,Vision-Language Models(视觉—语言模型)在多模态理解任务中取得了显著进展,并逐渐成为通用人工智能的重要技术路线。
这一框架可用于集成额外文本、语音和视觉等多种模态。
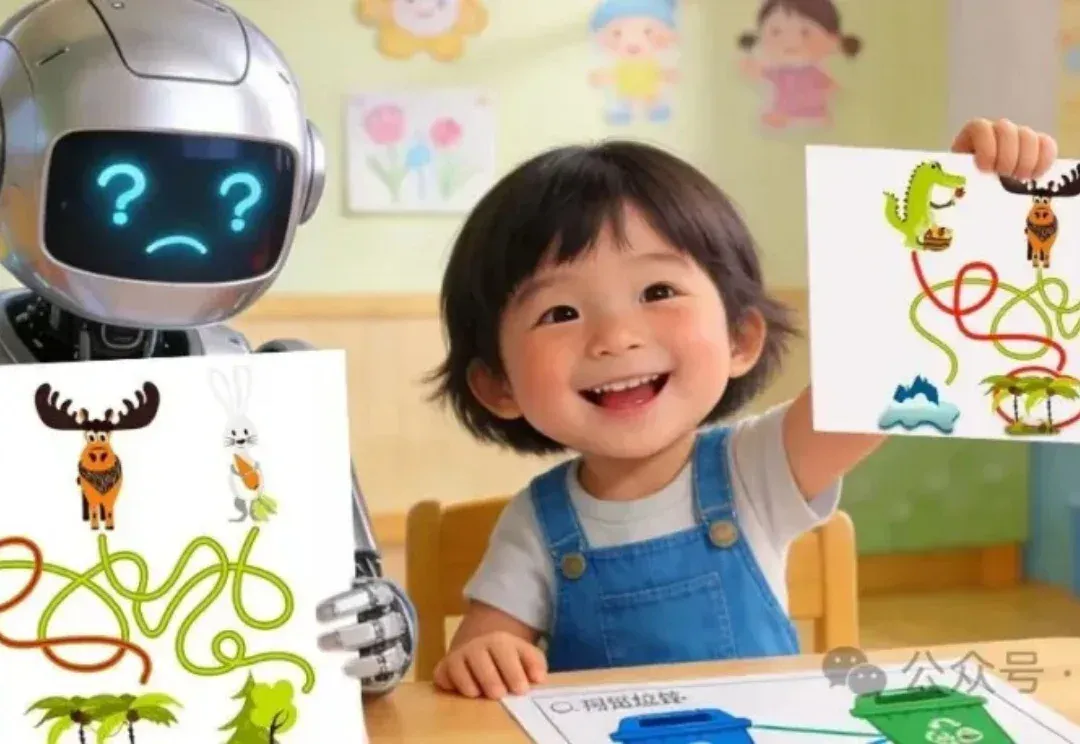
大模型能写代码、解奥数,却连幼儿园小班都考不过?简单的连线找垃圾桶、数积木,人类一眼即知,AI却因为无法用语言「描述」视觉信息而集体翻车。大模型到底「懂不懂」,这个评测基准给出答案。
要说真学术,还得看推特。 刚刚,谢赛宁自曝团队新作iREPA其实来自4个多月前的,一次与网友的辩论。 这场短暂的线上辩论虽然以谢赛宁被网友说服告终,但在3个多月后,居然有了意料之外的后续—— 多个团队合作,沿着这一思路写出了一篇完整的论文,而且核心框架仅需3行代码。 致谢部分还感谢了当时参与讨论的网友。 一篇推特引发的学术论文 事情是这样的。 一位网友在8月份表示: 别再痴迷于ImageNet-1K的分类分数了!自监督学习(SSL)模型应该专门为稠密任务(如REPA、VLM等)进行训练,因为这些任务真正依赖的是patch tokens中的空间和局部信息,而不是[CLS]token所代表的全局分
全球首个可大规模落地的开源原生多模态架构(Native VLM),名曰NEO。要知道,此前主流的多模态大模型,例如我们熟悉的GPT-4V、Claude 3.5等,它们的底层逻辑本质上其实玩的就是拼接。
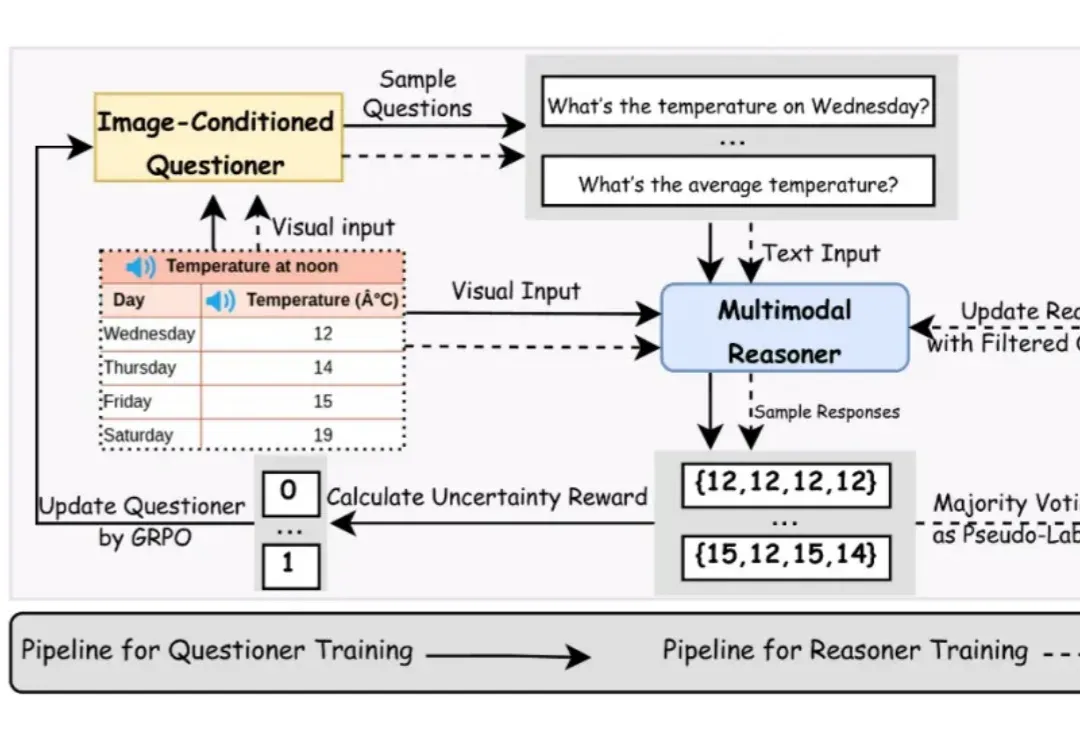
在 Vision-Language Model 领域,提升其复杂推理能力通常依赖于耗费巨大的人工标注数据或启发式奖励。这不仅成本高昂,且难以规模化。
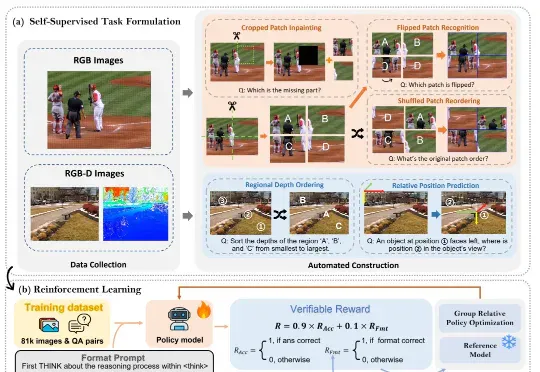
本文第一作者为刘禹宏,上海交通大学人工智能专业本科四年级学生,相关研究工作于上海人工智能实验室科研实习期间完成。通讯作者为王佳琦、臧宇航,在该研究工作完成期间,均担任上海人工智能实验室研究员。
在多模态智能浪潮中,视觉语言模型(Vision-Language Models, VLM)已成为连接视觉理解与语言生成的核心引擎。从图像描述、视觉问答到 AI 教育和交互系统,它们让机器能够「看懂世界、说人话」。