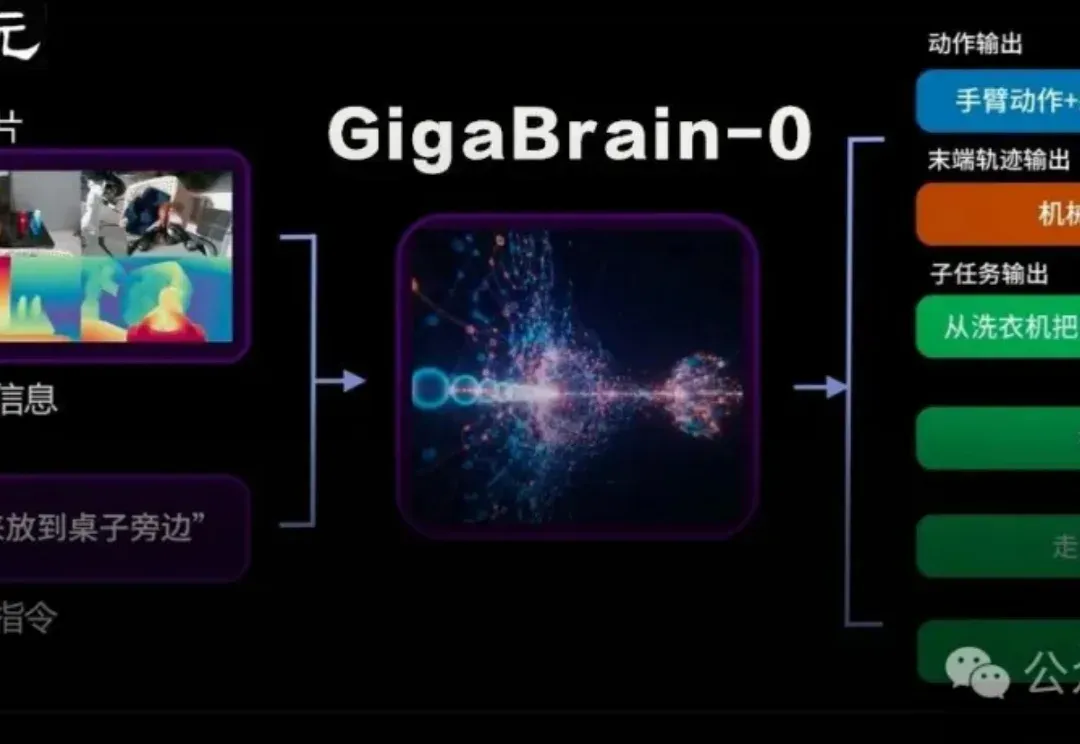
刚刚,最佳VLA模型GigaBrain-0开源:世界模型驱动10倍数据,真机碾压SOTA (opens in a new tab)
国内首个利用世界模型生成数据实现真机泛化的端到端VLA具身基础模型GigaBrain-0重磅发布。
Total 122 articles
国内首个利用世界模型生成数据实现真机泛化的端到端VLA具身基础模型GigaBrain-0重磅发布。
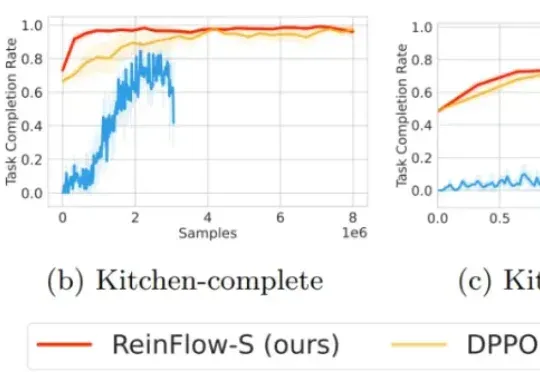
今年,流匹配无疑是机器人学习领域的大热门:作为扩散模型的一种优雅的变体,流匹配凭借简单、好用的特点,成为了机器人底层操作策略的主流手段,并被广泛应用于先进的 VLA 模型之中 —— 无论是 Physical Intelligence 的 ,LeRobot 的 SmolVLA, 英伟达的 GR00T 和近期清华大学发布的 RDT2。
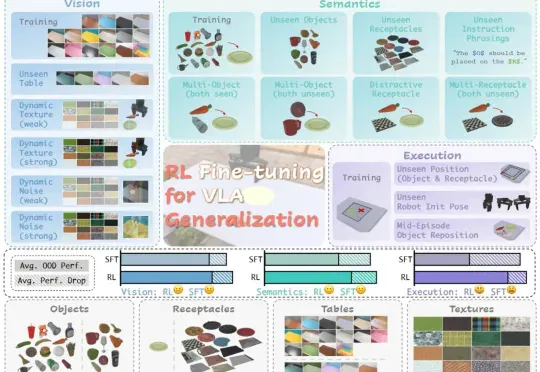
在具身智能领域,视觉 - 语言 - 动作(VLA)大模型正展现出巨大潜力,但仍面临一个关键挑战:当前主流的有监督微调(SFT)训练方式,往往让模型在遇到新环境或任务时容易出错,难以真正做到类人般的泛化
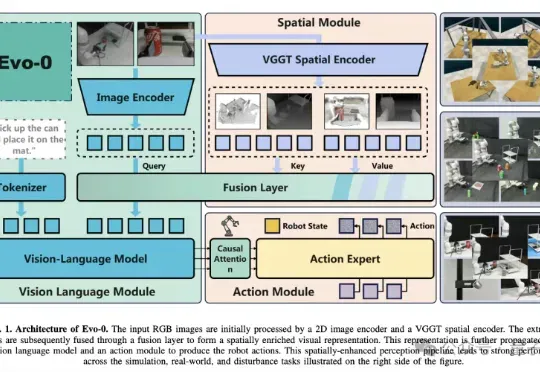
VLA模型通常建立在预训练视觉语言模型(VLM)之上,仅基于2D图像-文本数据训练,缺乏真实世界操作所需的3D空间理解能力。
机器人拉个拉链,到底需不需要“脑子”? 过去几年,从OpenVLA到π0、π0.5,具身大模型已经能让机器人把指令和动作连得有模有样。 但一旦包的位置挪了几厘米,或者光照暗了一点,它们往往就会“大脑宕机”。 究其原因,是因为这些机器人大多在玩“连连看”:看到观察结果,直接输出动作。 它们只是记住了轨迹,却并不理解背后的物理逻辑。 现在,一种让机器人“先想明白,再稳定行动”的新范式来了。 由至简动力、北大、港中文联合提出的LaST-R1,首次将隐空间物理推理塞进了强化学习的闭环。 同时,LaST-R1作为LaST₀基座模型的物理世界后训练范式,LaST₀首创面向机器人的隐空间物理思维链推理,并已
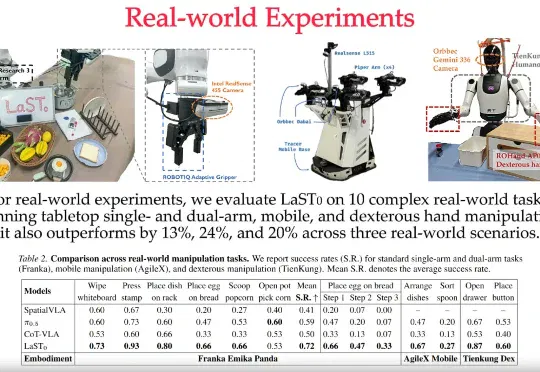
LaST₀团队 投稿 量子位 | 公众号 QbitAI 近日,至简动力、北京大学、香港中文大学、北京人形机器人创新中心提出了一种名为LaST₀的全新隐空间推理VLA模型,在基于Transformer混
过去几年,机器人操作领域几乎被一批新概念重新 “刷屏”。 LLM Planner、VLA、Diffusion Policy、Flow Matching、Latent Action、World Mode
就在这一背景下,银河通用联合清华北大英伟达等众多机构联合发布了跨本体「隐式世界-动作基础模型」LDA-1B,将目光投向了具身智能 Scaling Law 的这个终极命题:如何让模型有效利用互联网规模的异构数据。
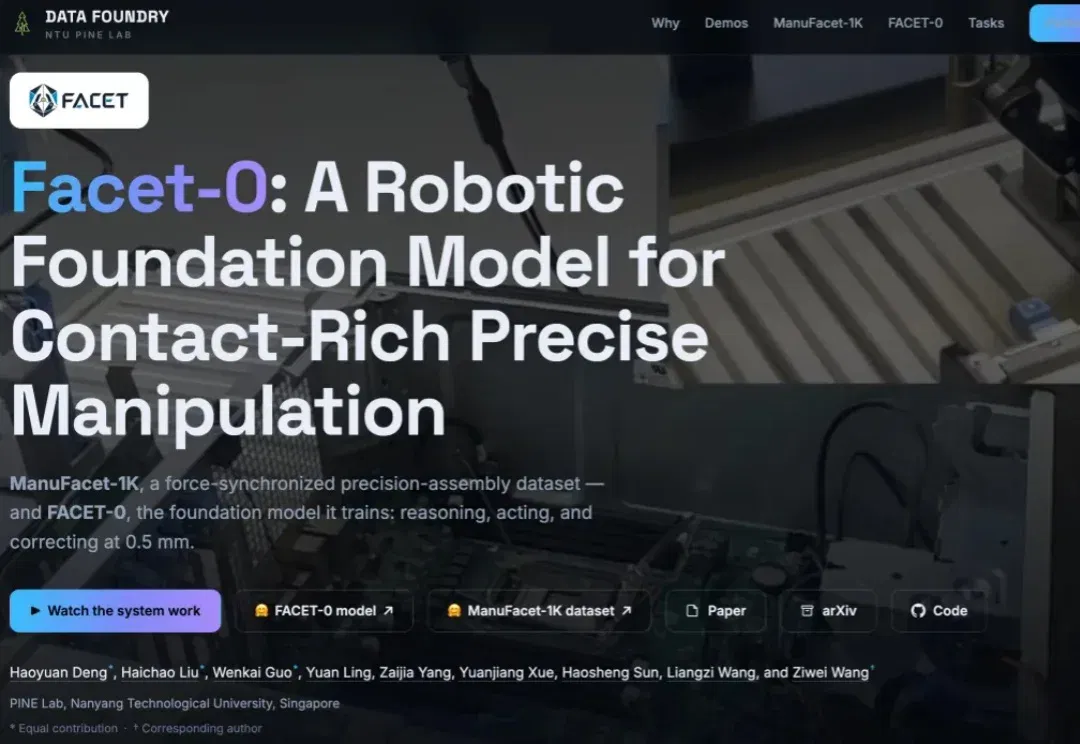
机器人正在变得越来越「通用」。 从抓取日常物品,到根据语言指令完成多步骤操作,视觉 — 语言 — 动作(VLA)模型正在让机器人摆脱过去「一项任务、一套程序」的开发方式。但当机器人真正走向制造现场,问题也随之发生了变化:会不会做,已经不是唯一标准;能不能在毫米甚至亚毫米级接触中稳定完成,并在出错后自己恢复,才决定它能否真正进入生产环节。 精密装配恰恰是这道门槛最集中的地方。零件可能已经「看起来对齐」,却在最后几毫米发生偏斜、卡滞;一次没有恢复的异常,就可能让整条任务链中断。 项目地址:https://pine-lab-ntu.github.io/facet-0/论文链接:https://arx
开普勒机器人前 CEO 胡德波已开启具身智能赛道的第二次创业,新公司名为「索塔无界」。这一次,他选择了一条和开普勒不同的路。索塔无界将在今年夏天展示完整大脑能力,包括世界模型、多模态 VLA 以及 Physica-Claw 机器人操作系统,并在实验室跑通早期商业场景全流程。