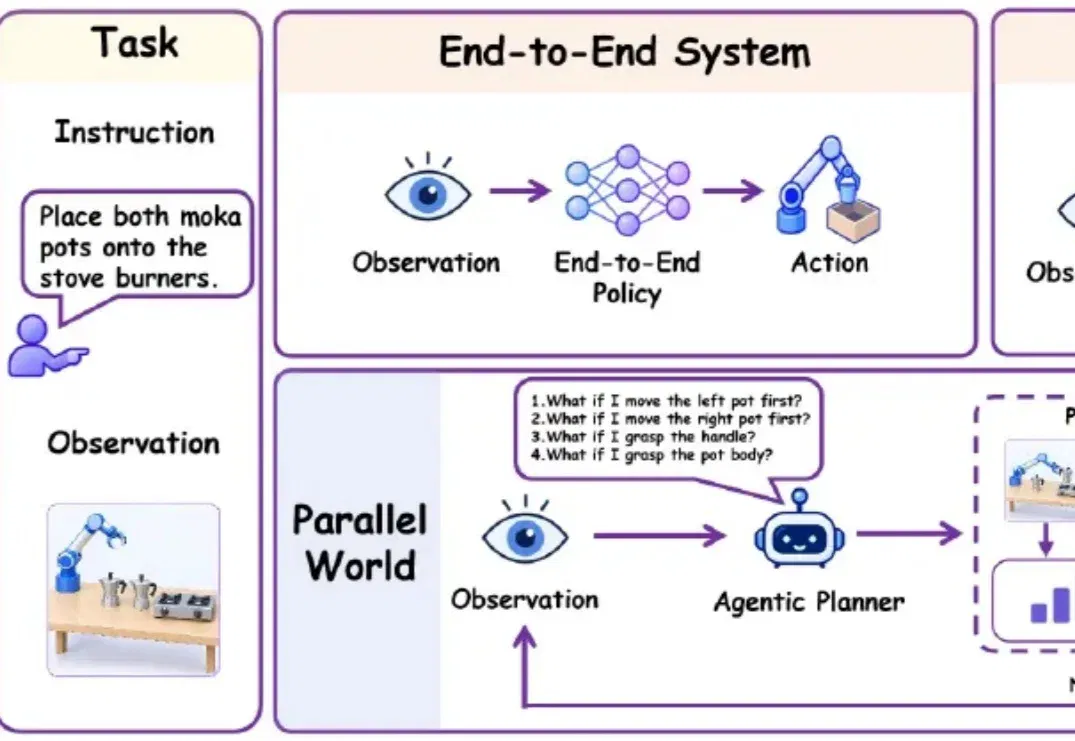
先在平行世界里试一试,机器人再动手:清华提出ParallelWorld (opens in a new tab)
机器人动手前,能不能先看一看不同选择会带来什么后果?ParallelWorld 将多步预演引入具身智能体的高层规划,将任务成功率从 56% 提升至 83%。
Total 362 articles
机器人动手前,能不能先看一看不同选择会带来什么后果?ParallelWorld 将多步预演引入具身智能体的高层规划,将任务成功率从 56% 提升至 83%。
AI原生娱乐正从角色聊天走向地图化、多人参与的互动叙事:All Football Inc.的Worldo以可编辑人物、地点和故事事件构建共享虚拟世界,快看漫画Livo与Saylo则探索持续演化、视觉化和多人互动。
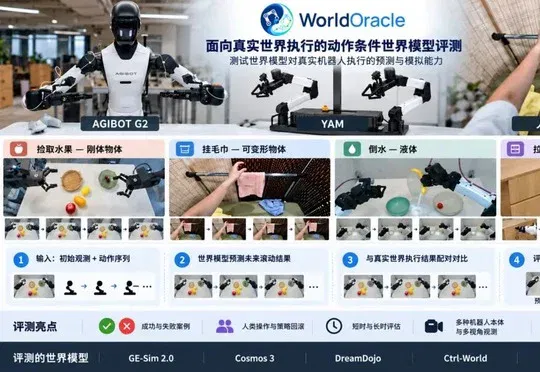
普林斯顿大学、得克萨斯大学奥斯汀分校、多伦多大学、NVIDIA和智元研究人员提出WorldOracle,并于10月16日开放评测平台;七种模型的真实执行对照显示,其机械臂轨迹较准但物体运动易偏离,长序列预测表现也会明显退化。
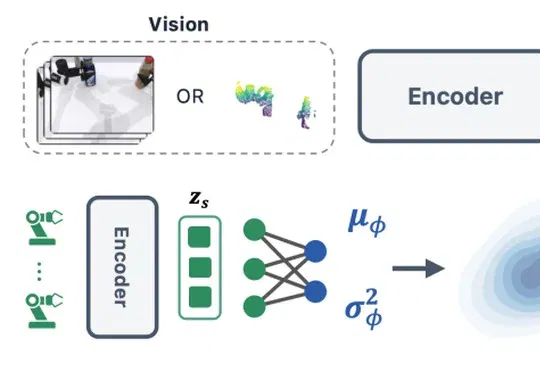
东南大学魏秀参团队提出LeaP(Learnable source Prior)方法,由本体感知信息驱动并联合预测动作生成起点的均值与方差,在RoboTwin仿真15项任务上平均成功率81.6%、较标准高斯基线提升25.5个百分点,相关论文已被CoRL 2026接收。
寰宇心生(WorldMind)于成立当月完成数千万元人民币种子轮融资,元生资本为投资方,点石资本担任独家财务顾问,所融资金将用于神经认知世界模型研发、训练基础设施建设、多模态数据采集体系搭建及团队扩张。
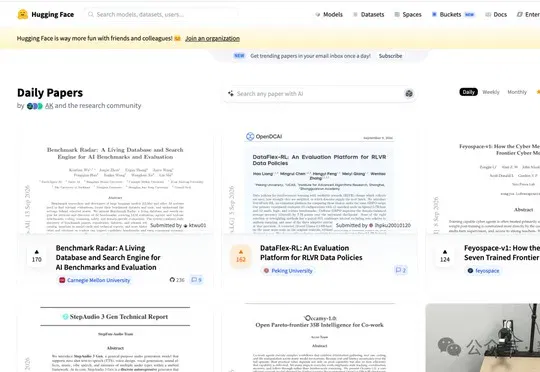
这个问题正随着推理模型和 RLVR 的发展变得更加重要。随着强化学习在大模型后训练中的作用不断增强,模型练什么、怎么练,也需要更仔细地安排。为了解决数据策略接入和效果比较中的麻烦问题,北大DCAI团队联合UCAS、上海算法创新研究院、中关村学院最新发布DataFlex-RL。
上海交通大学卢策吾、汶川团队联合穹彻提出LIFT(Late Reactive Injection of Force for VLA Post-Training),被CoRL 2026高分收录,该方法在保留预训练知识的前提下,仅通过20至30条在线带力数据后训练即可让VLA学会力反馈,显著提升叠毛巾、插书、汉诺塔圆环放置等接触密集型任务表现。
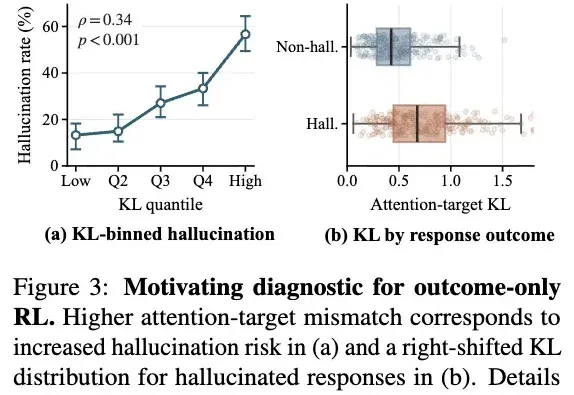
强化学习与可验证奖励(RLVR)已成为提升视觉语言模型(VLM)推理能力的标配手段。但一个隐蔽的问题始终存在:最终答案的奖励信号,只告诉模型「答对了没有」,却从不告诉它「答案应该从图像的哪个区域得出」。答对,可能是因为真的看懂了图,也可能只是语言先验的捷径、数据集的偏差,甚至是一次幸运的瞎猜。
影眸Hyper3D发布世界生成模型WorldGen,用户上传一张场景图片即可在两三分钟内生成由多个独立可交互物体组成的3D场景,物体具备质量、摩擦系数等物理属性,可直接接入Blender、Unity、Unreal Engine等主流工具及机器人仿真环境,标志着3D生成进入场景级时代。
近日,清华大学智能产业研究院(AIR)与加州大学伯克利分校(BAIR)团队合作提出了一种全新的预测范式 ODEWorld,其建立在连续的“物理时间流”(Physical-Time Flow, PT-Flow)之上。与传统方法直接预测下一帧是什么不同,ODEWorld 试图学习的是:世界究竟怎样从当前状态连续地变化到未来状态。