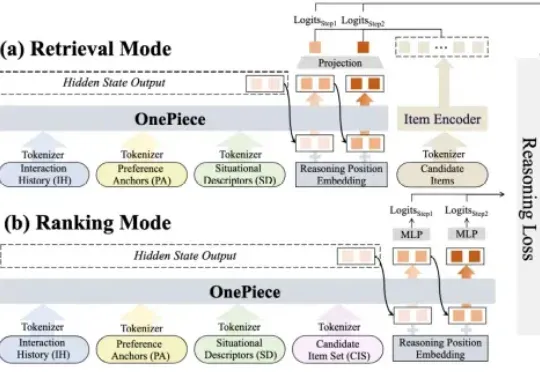
Shopee OnePiece:业内首个融合上下文工程、隐式推理和多目标训练策略的生成式搜推建模框架 (opens in a new tab)
2025 年,生成式推荐(Generative Recommender,GR)的发展如火如荼,其背后主要的驱动力源自大语言模型(LLM)那诱人的 scaling law 和通用建模能力(general-purpose modeling),将这种能力迁移至搜推广工业级系统大概是这两年每一个从业者孜孜不倦的追求。
Total 55 articles
2025 年,生成式推荐(Generative Recommender,GR)的发展如火如荼,其背后主要的驱动力源自大语言模型(LLM)那诱人的 scaling law 和通用建模能力(general-purpose modeling),将这种能力迁移至搜推广工业级系统大概是这两年每一个从业者孜孜不倦的追求。
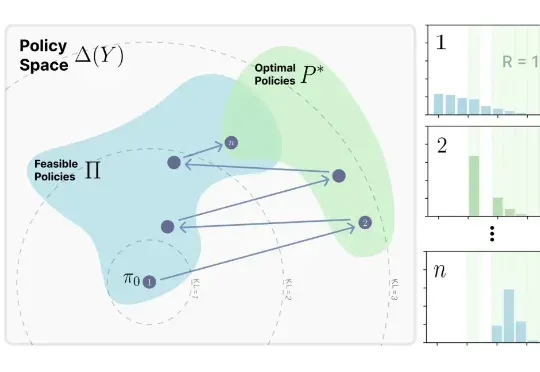
来自MIT Improbable AI Lab的研究者们最近发表了一篇题为《RL's Razor: Why Online Reinforcement Learning Forgets Less》的论文,系统性地回答了这个问题,他们不仅通过大量实验证实了这一现象,更进一步提出了一个简洁而深刻的解释,并将其命名为 “RL's Razor”(RL的剃刀)。
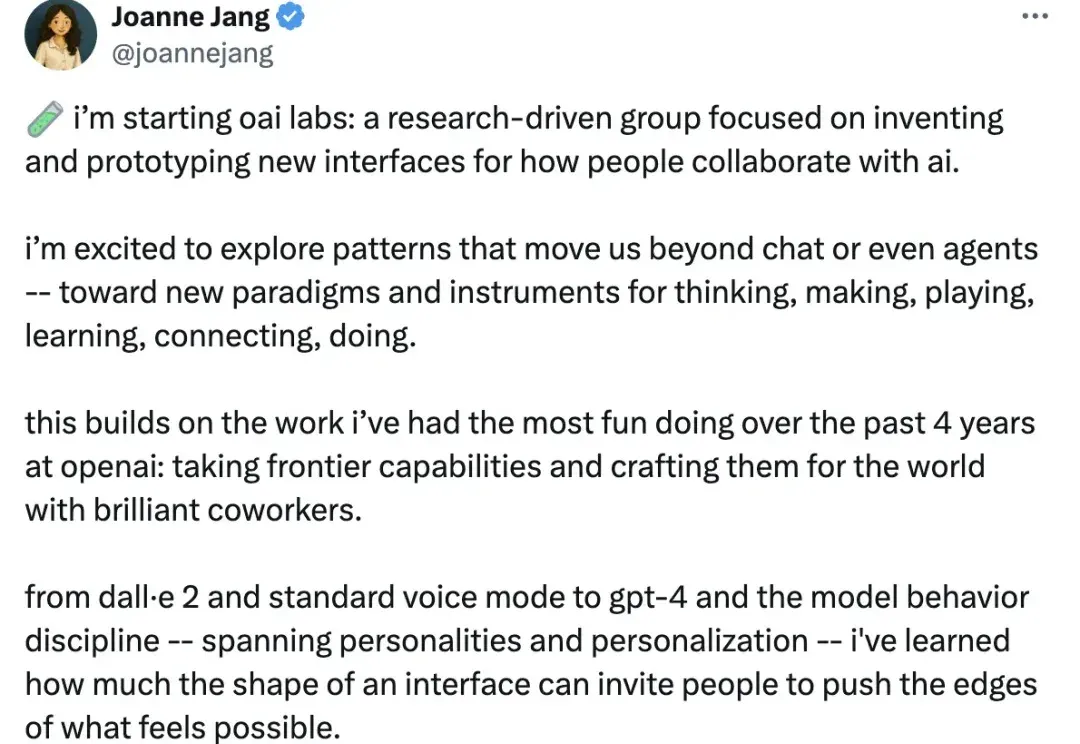
OpenAI又要成立新团队了! TechCrunch消息,OpenAI正在对其模型行为(Model behavior)团队进行重组。 模型行为团队,就是OpenAI内部专门塑造模型“个性”的核心研究小组。迄今已参与GPT-4、GPT-4o、GPT-4.5与GPT-5等版本的后训练工作。 随着重组的进行,其创始负责人Joanne Jang,也正在组建一个名为OAI Labs的新研究团队。 Joanne介绍,OAI Labs的职责是探索人与AI协作的新范式。 这是一个以研究为导向的团队,专注于发明和设计人们与人工智能协作的新接口。 OpenAI成立OAI Labs 作为模型行为团队改组行动的一部分
OpenAI重磅结构调整:ChatGPT「模型行为」团队并入Post-Training,前负责人Joanne Jang负责新成立的OAI Labs。而背后原因,可能是他们最近的新发现:评测在奖励模型「幻觉」,模型被逼成「应试选手」。一次组织重组+评测范式重构,也许正在改写AI的能力边界与产品形态。
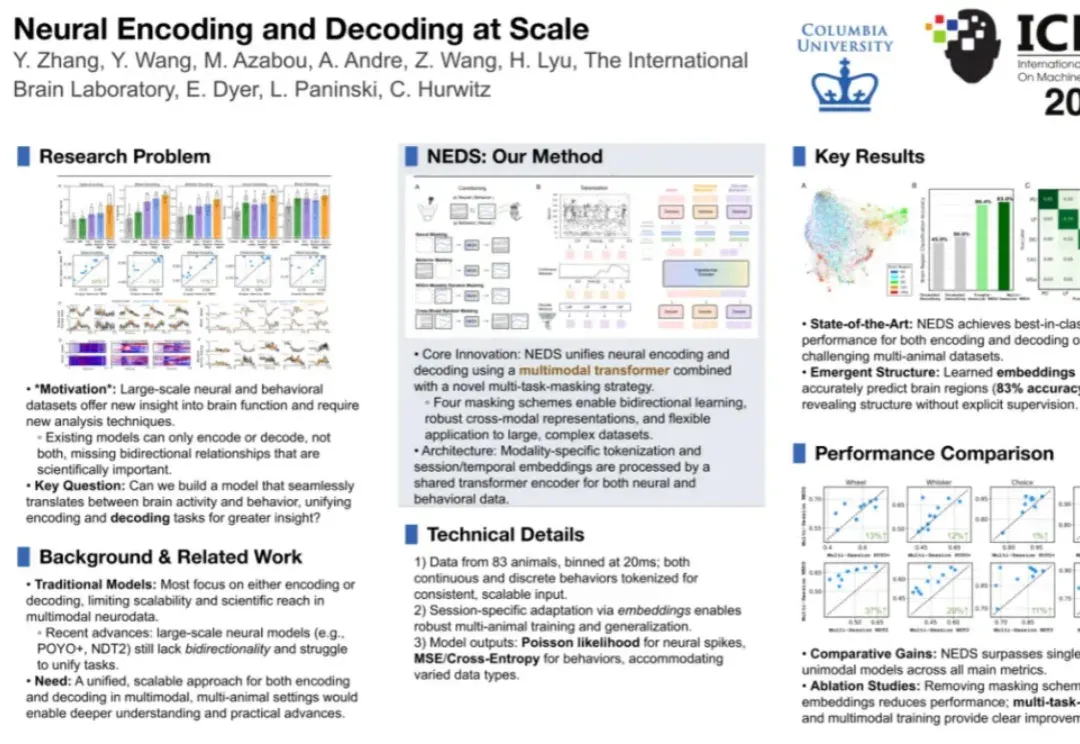
许多研究者在参加学术会议前,常常会因为制作海报所耗费的大量时间和精力而感到困扰。一张精心设计的海报是高效的学术交流媒介,但现有自动化方法普遍忽略了核心设计原则,导致生成的海报仍旧需要大量人工调整。