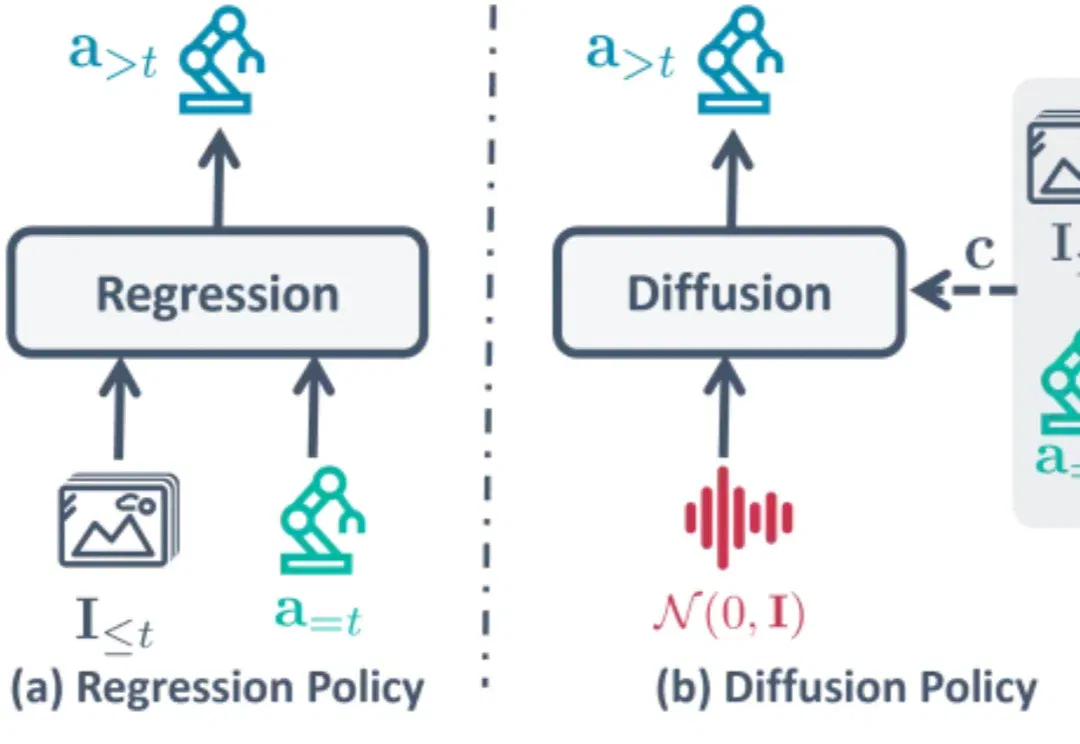
告别噪声初始化:NTU MARS Lab提出A2A新范式,实现机器人高性能单步动作生成 (opens in a new tab)
在机器人领域,扩散策略(Diffusion Policy)已经成为了标准模仿学习策略和 VLA 动作生成范式,但其「从随机噪声中迭代解噪」的机制带来了不容忽视的推理延迟。如果机器人不再从随机高斯噪声开始「盲猜」,是否可以基于「刚刚做了什么」来预测「下一步做什么」呢?
Total 66 articles
在机器人领域,扩散策略(Diffusion Policy)已经成为了标准模仿学习策略和 VLA 动作生成范式,但其「从随机噪声中迭代解噪」的机制带来了不容忽视的推理延迟。如果机器人不再从随机高斯噪声开始「盲猜」,是否可以基于「刚刚做了什么」来预测「下一步做什么」呢?
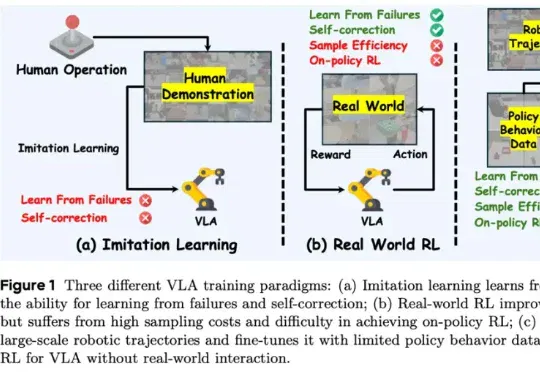
香港科技大学 PEI-Lab 与字节跳动 Seed 团队近期提出的 WMPO(World Model-based Policy Optimization),正是这样一种让具身智能在 “想象中训练” 的新范式。该方法无需在真实机器人上进行大规模强化学习交互,却能显著提升策略性能,甚至涌现出 自我纠错(Self-correction) 行为。
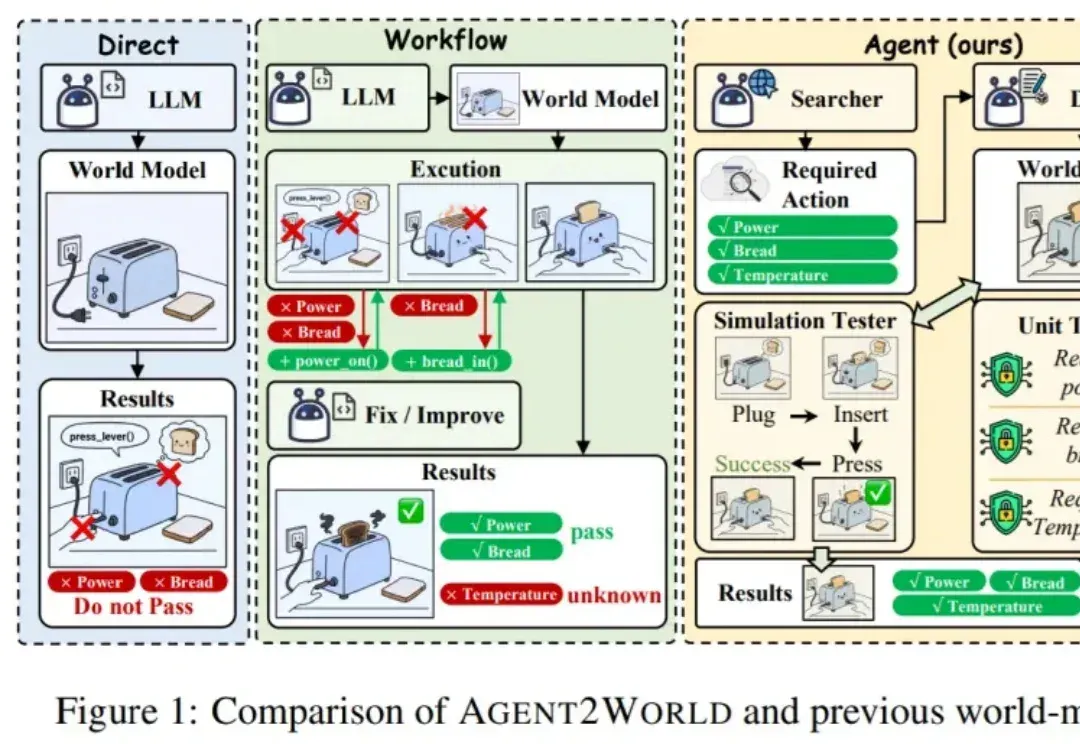
让模型真正 “能行动”,往往需要一个可执行、可验证的符号世界模型(Symbolic World Model):它不是抽象的文字描述,而是能被规划器或执行器直接调用的形式化定义 —— 例如 PDDL 领域 / 问题,或可运行的环境代码 / 模拟器。
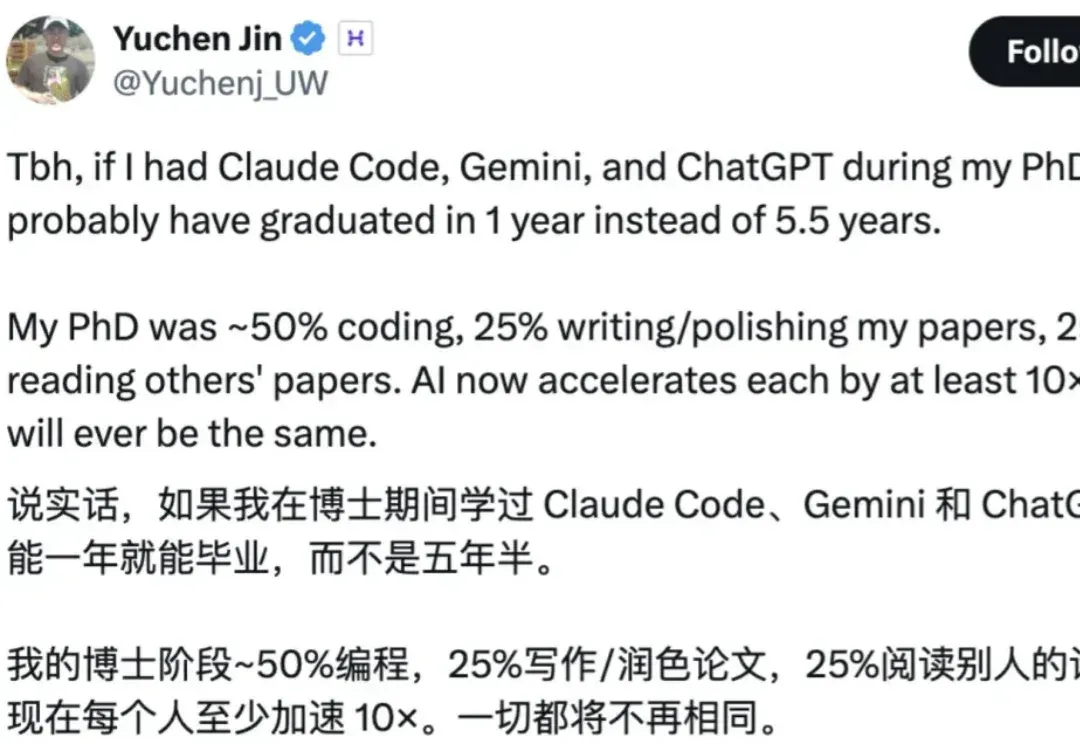
近日,X 知名博主、Hyperbolic 联创 & CEO Yuchen Jin 发帖称,如果在他读博士的时候就有 Claude Code、Gemini 和 ChatGPT 等各类 AI 工具出现,那么也许只要一年就能毕业,而不是用了 5.5 年。
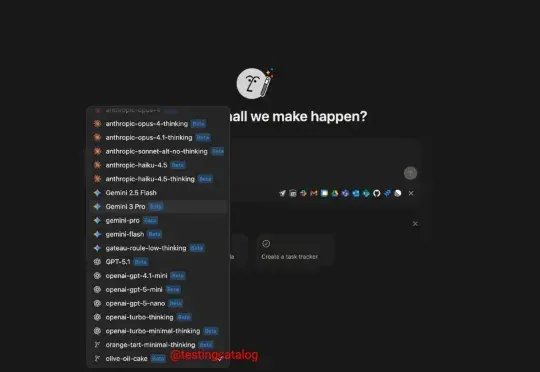
让我们细数一下这两年令人印象深刻的模型代号:草莓、香蕉、胡萝卜……每次一亮相,总要和水果蔬菜沾点关系。最新的主角叫:Olive Oil Cake(橄榄油蛋糕),另加 Chestnut and Hazelnut(栗子和榛子)。
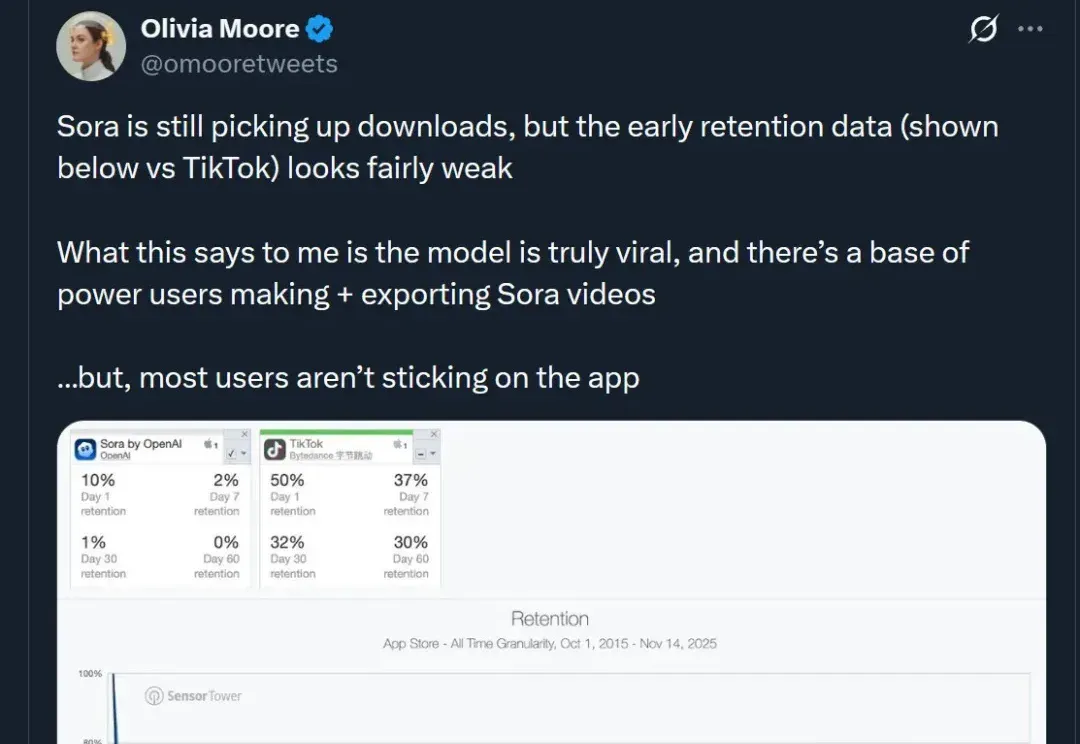
Sora APP,这就凉凉了?! 刚刚,a16z合伙人Olivia Moore分享了一组数据,结果让所有人都大吃一惊—— 这款爆发速度比ChatGPT还要快的应用(5天下载破百万),用户留存率一路从10%(day1)降至2%(day7)、1%(day30)、0%(day60),但需要说明的是,Sora APP上线还不足60天… 不过还是某种维度说明,虽然新增还在继续,但用户留存不下来…玩玩儿就腻了。 单看一处细节也能一窥Sora APP的困境。 刚出道时,它轻轻松松地拿下了App Store免费榜第一,但此时此刻它的排位已经降至第22,别说和谷歌Gemini对打了(第2),连麦当劳(第11)、
先说一句最关键的。十月,ChatPlayground.ai 的月访问量估算为25万上下,环比暴涨六倍多,具体是 611.53%。这个数据来自 Toolify 的十月增长榜。
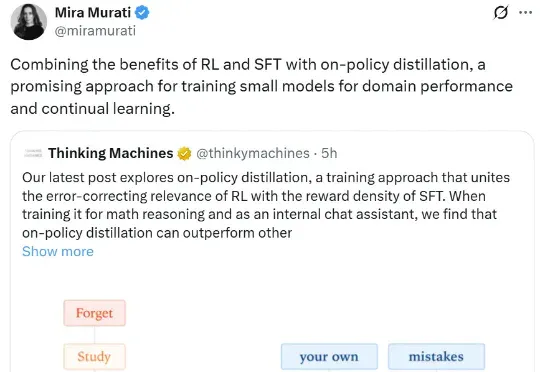
刚刚,不发论文、爱发博客的 Thinking Machines Lab (以下简称 TML)再次更新,发布了一篇题为《在策略蒸馏》的博客。在策略蒸馏(on-policy distillation)是一种将强化学习 (RL) 的纠错相关性与 SFT 的奖励密度相结合的训练方法。在将其用于数学推理和内部聊天助手时,TML 发现在策略蒸馏可以极低的成本超越其他方法。
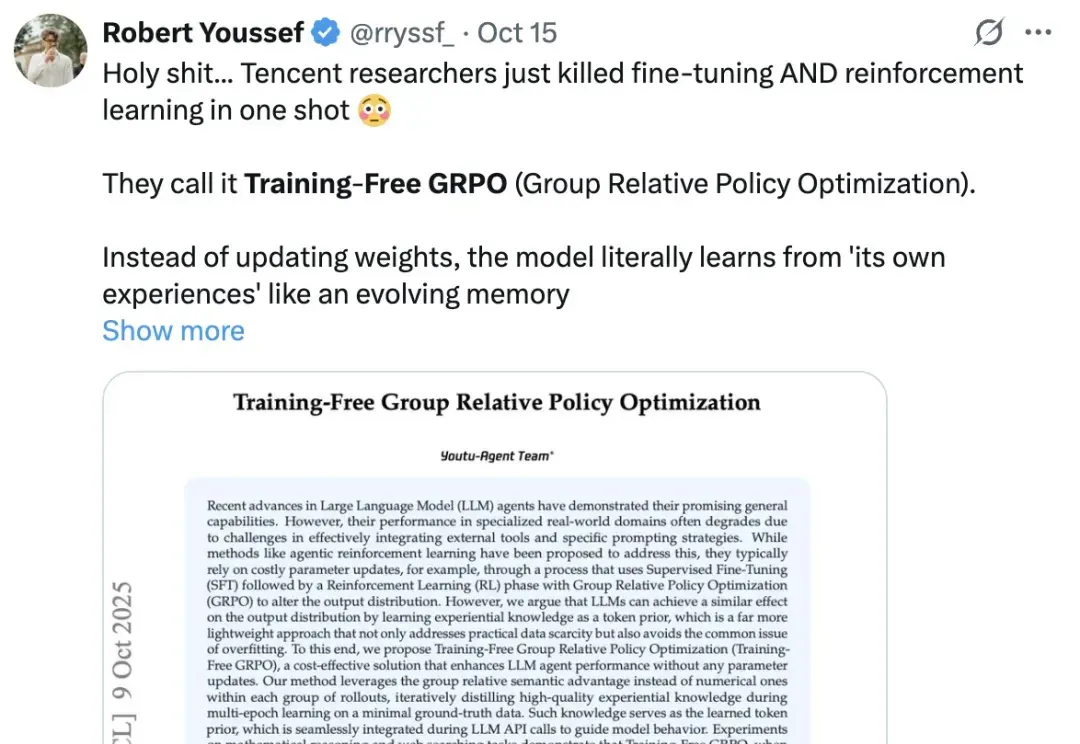
年初的 DeepSeek-R1,带来了大模型强化学习(RL)的火爆。无论是数学推理、工具调用,还是多智能体协作,GRPO(Group Relative Policy Optimization)都成了最常见的 RL 算法。
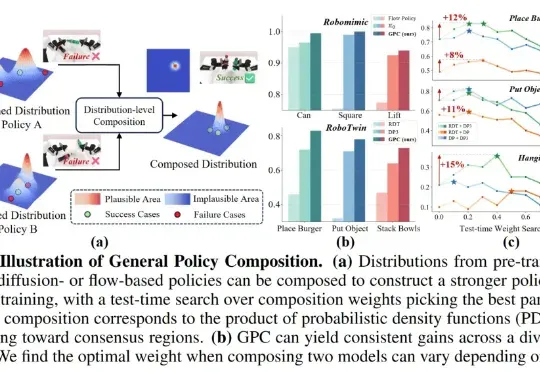
在机器人学习领域,提升基于生成式模型的控制策略(Policy)的性能通常意味着投入巨额成本进行额外的数据采集和模型训练,这极大地限制了机器人能力的快速迭代与升级。面对模型性能的瓶颈,如何在不增加训练负担的情况下,进一步挖掘并增强现有策略的潜力?