我去,Sonnet 5.5代码反超Opus?这下GPT-6 Sol成路边一条了 (opens in a new tab)
说好的未来几周,Anthropic只等了6天。上周Opus 5.5发布的时候,官方顺手剧透了一嘴,Sonnet 5.5和Haiku 5.5都在后面。刚刚,Sonnet 5.5先到了。而且Claude家的“中杯”,已经撵着刚发布的旗舰追了。
Total 71 articles
说好的未来几周,Anthropic只等了6天。上周Opus 5.5发布的时候,官方顺手剧透了一嘴,Sonnet 5.5和Haiku 5.5都在后面。刚刚,Sonnet 5.5先到了。而且Claude家的“中杯”,已经撵着刚发布的旗舰追了。
EvoMap团队推出自进化智能体EvoX,采用无中心调度的蜂群模式让大量Agent平级协作、自主组队,在563道逻辑、数学、物理题上将Claude Haiku 4.5的正确率从单Agent的26.29%提升至70%以上,并开源AutoResearch项目构建Agent经验基础设施。
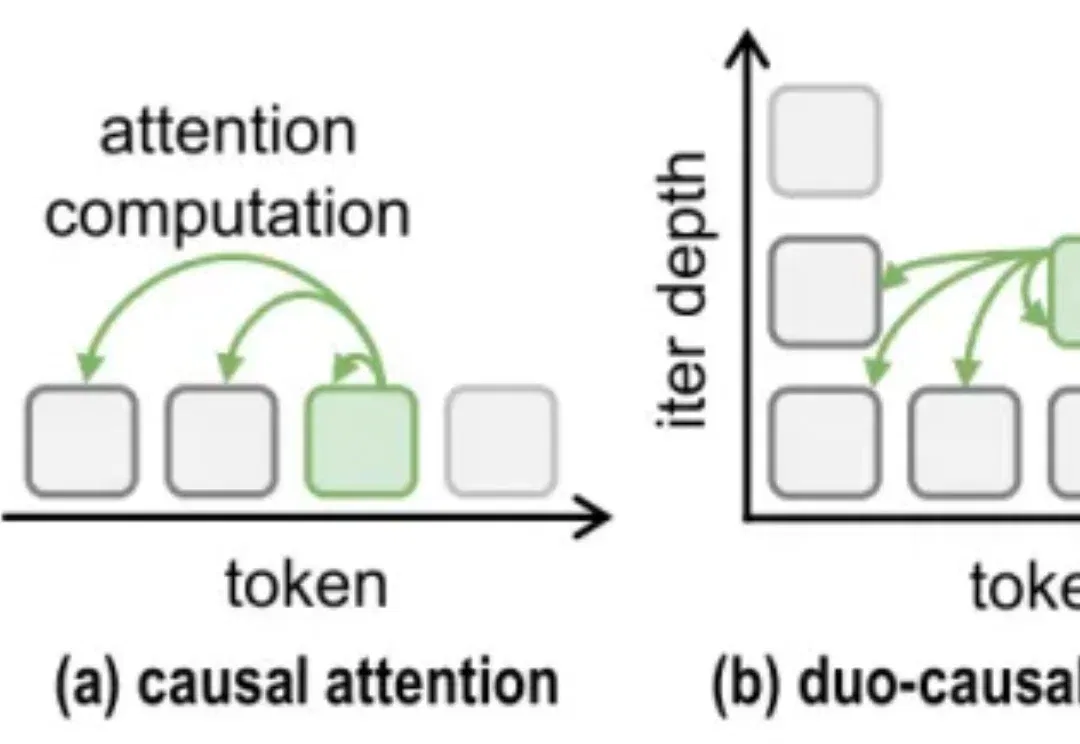
随着 o1/R1 等推理模型的发展 [1][2],「让模型多想一会儿」几乎成了提升复杂推理能力的标准方案。更长的 Chain-of-Thought、更大的测试时计算、更深的内部推理,都在用更多计算换取更可靠的答案。
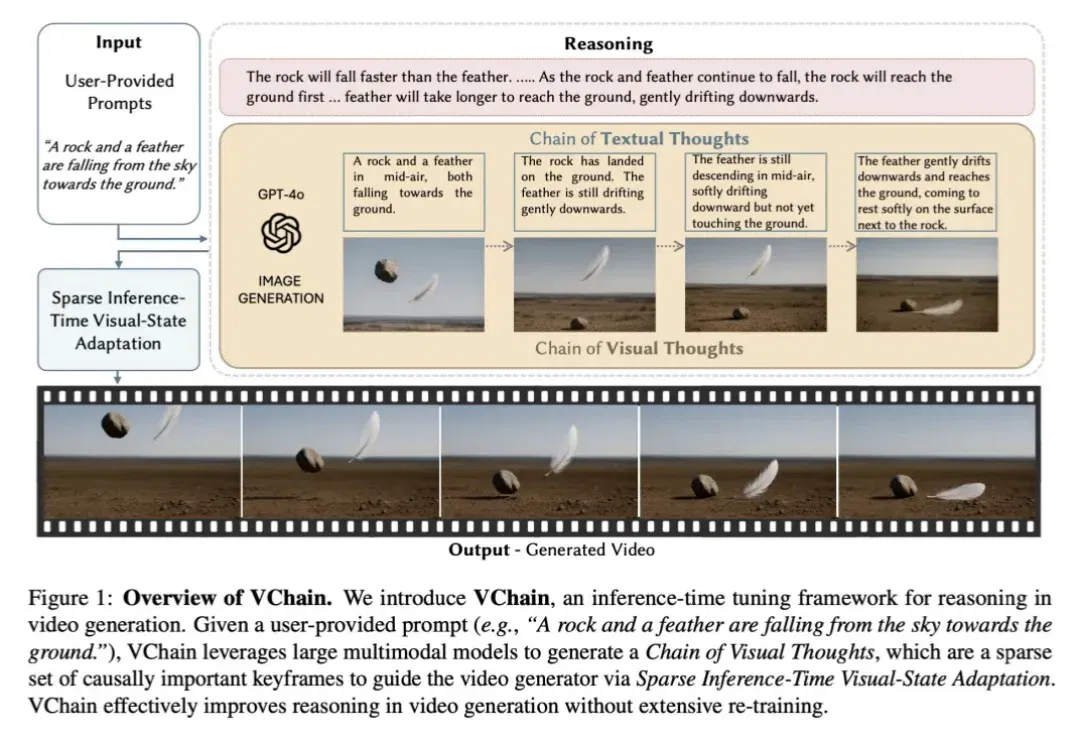
当视频生成模型在视觉保真度上不断突破时,一个核心瓶颈正变得愈发清晰:模型是否真正理解了真实世界?能否推理出合理的演变过程?
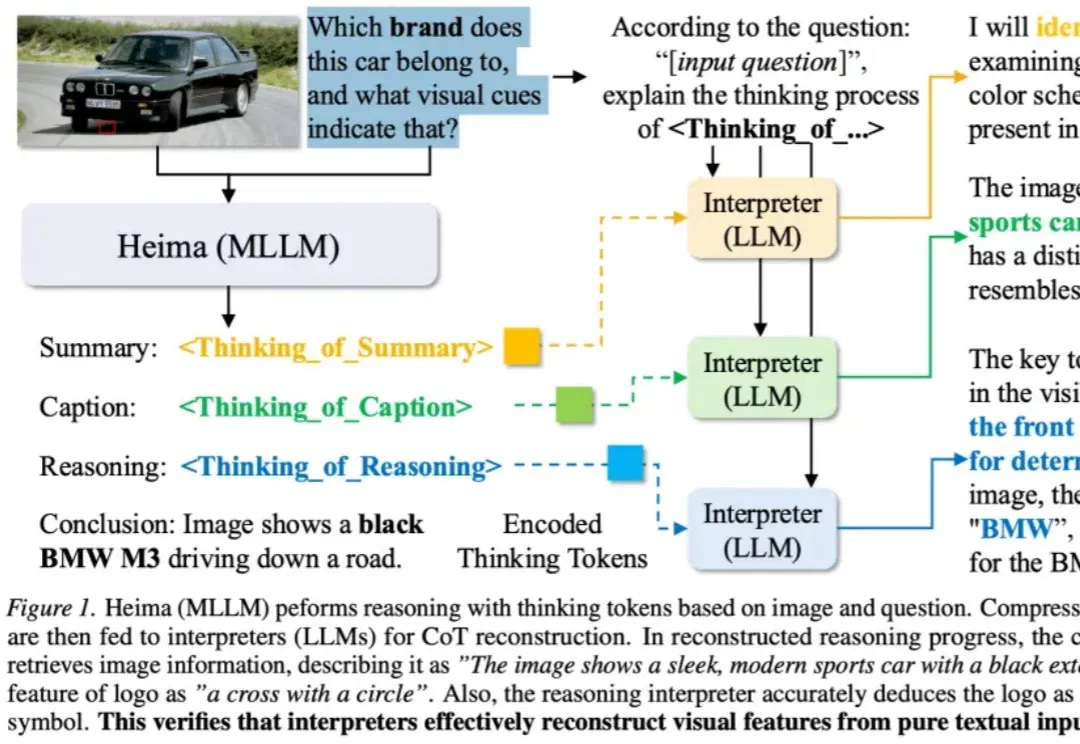
近年来,Chain-of-Thought(CoT)推理已经成为提升大语言模型和多模态大语言模型复杂问题求解能力的重要技术路径。
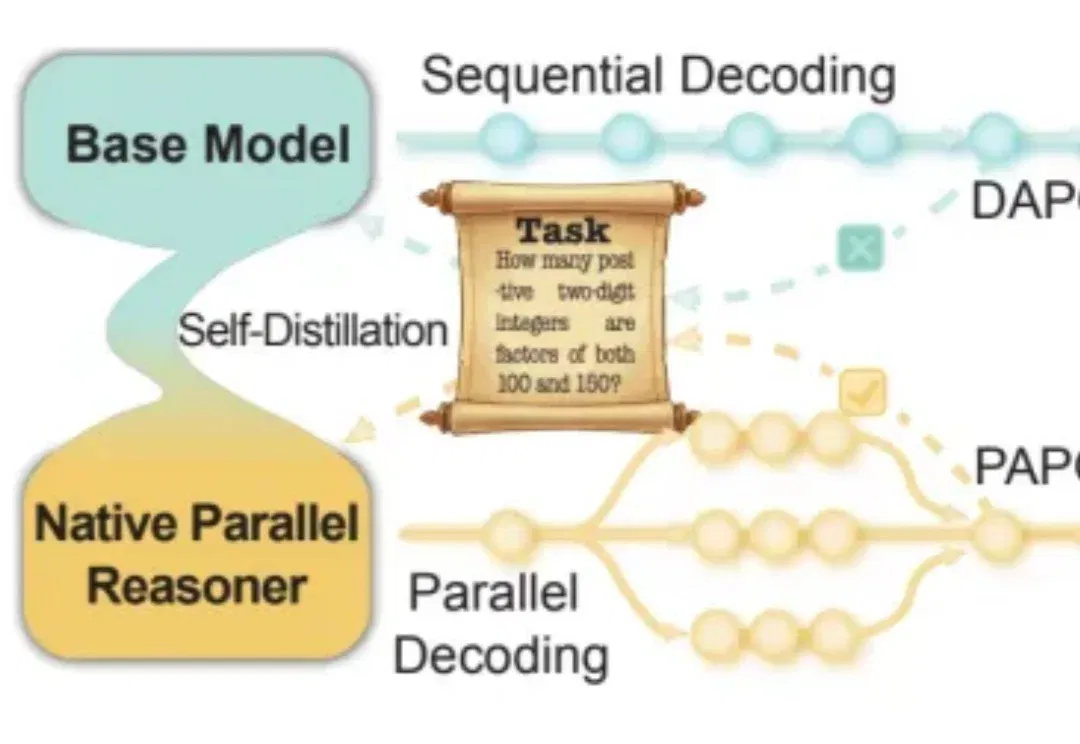
近年来,大语言模型在「写得长、写得顺」这件事上进步飞快。但当任务升级到真正复杂的推理场景 —— 需要兵分多路探索、需要自我反思与相互印证、需要在多条线索之间做汇总与取舍时,传统的链式思维(Chain-of-Thought)往往就开始「吃力」:容易被早期判断带偏、发散不足、自我纠错弱,而且顺序生成的效率天然受限。
深夜,Anthropic官宣重磅更新:Claude「顾问策略」(Advisor Strategy)上线。这一架构的核心逻辑是——让智商最高的Opus 4.6退居幕后当「顾问」; 让性价比极高的Sonnet 4.6或Haiku 4.5冲在前面当「执行者」。
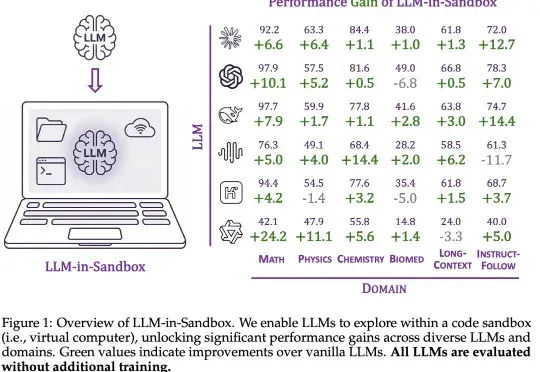
大模型的能力正在被不同的范式逐步解锁:In-Context Learning 展示了模型无需微调即可泛化到新任务;Chain-of-Thought 通过引导模型分步推理来提升复杂问题的求解能力;近期,智能体框架则赋予模型调用工具、多轮交互的能力。
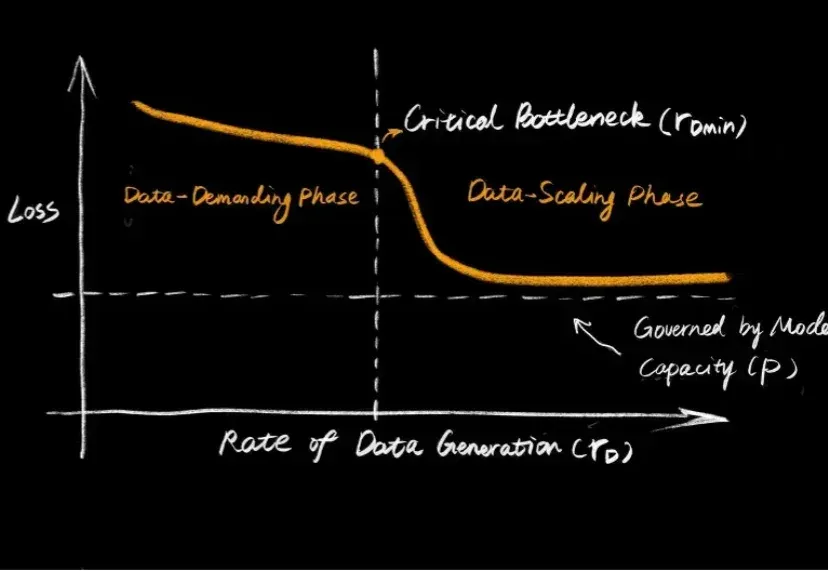
大语言模型的爆发,让大家见证了 Scaling Law 的威力:只要数据够多、算力够猛,智能似乎就会自动涌现。但在机器人领域,这个公式似乎失效了。
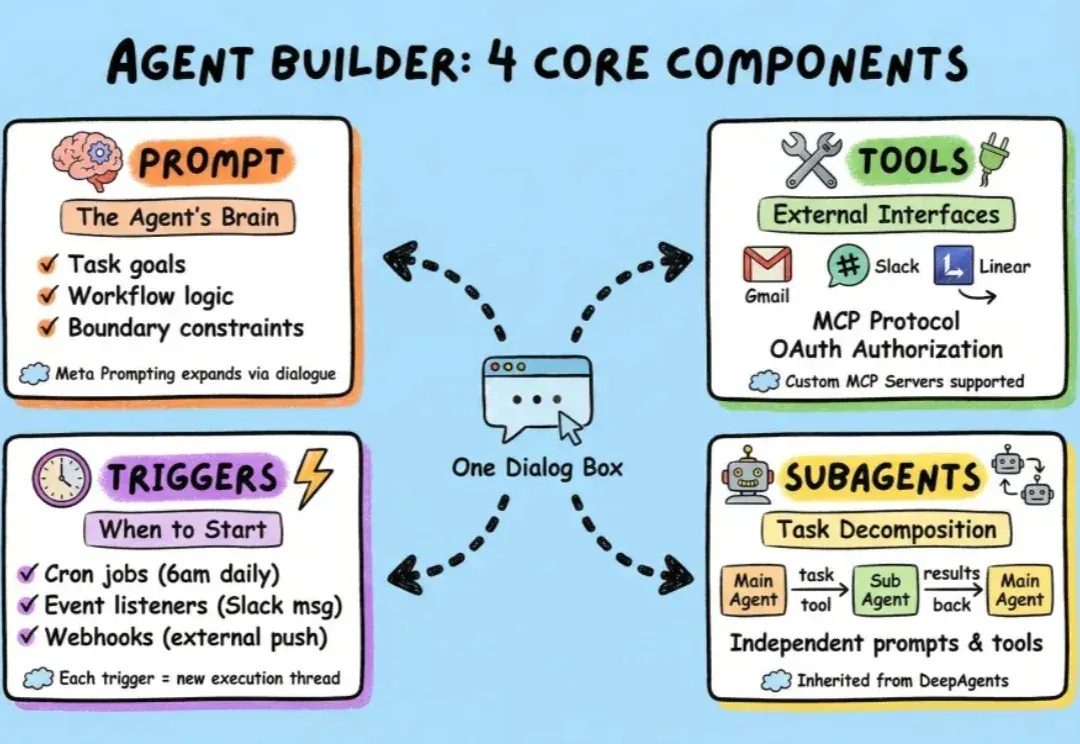
过去一段时间,我们介绍了很多小白入门级的agent框架,也介绍了包括langchain在内的很多专业级agent搭建框架。