登顶GitHub Hacker News,这个开源项目让AI编程的成本降低98%|涌现新项目 (opens in a new tab)
除此之外,context-mode 将大模型的记忆力从30分钟提升至 3 小时。
Total 62 articles
除此之外,context-mode 将大模型的记忆力从30分钟提升至 3 小时。
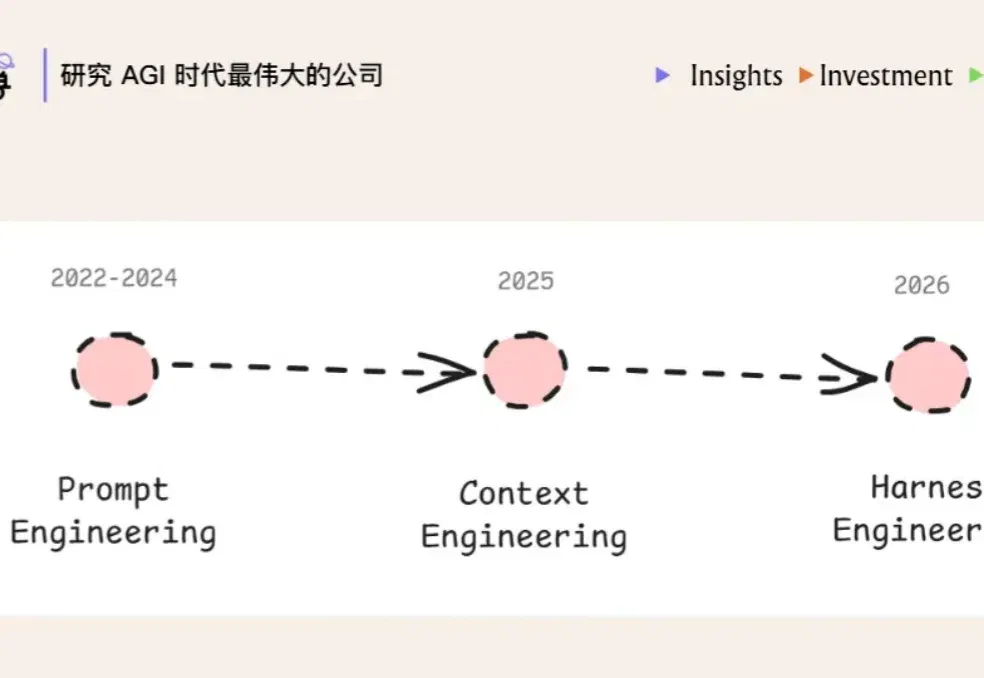
最近,harness engineering 又成了继 prompt engineering、context engineering 之后新一代的 buzzword。
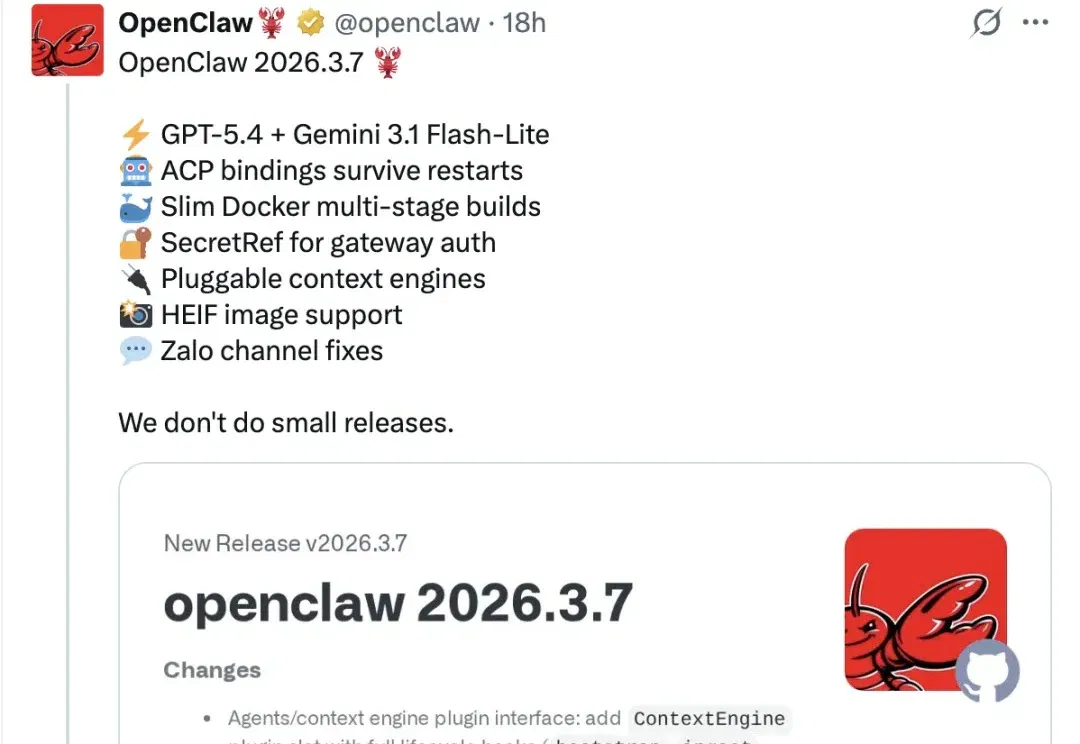
报!龙虾更新了! 刚刚,新的OpenClaw测试版(2026.3.7)已经推出,并光速上线OA两家最新模型GPT-5.4和Gemini Flash 3.1。 与此同时,一并更新的还有: ACP绑定在重启后依然可保留精简版Docker多阶段构建 用于网关认证的SecretRef 可插拔的上下文引擎 支持HEIF图像格式 修复Zalo渠道问题 其中,可插拔的上下文引擎(pluggable context engine)可谓是这次更新的重点,不少网友纷纷表示: 相比于跑那个模型,上下文才是关键。 细心的你甚至还发现了,在官方的changelog上直接点名了一个插件例子lossless-claw。 那
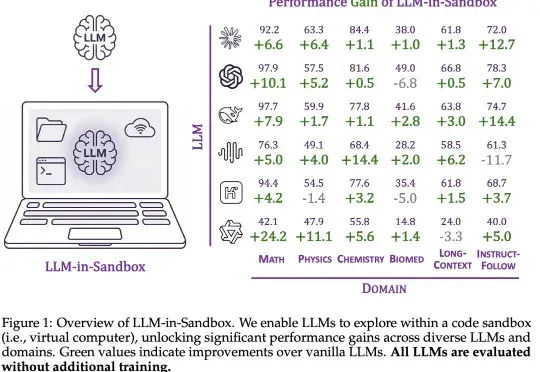
大模型的能力正在被不同的范式逐步解锁:In-Context Learning 展示了模型无需微调即可泛化到新任务;Chain-of-Thought 通过引导模型分步推理来提升复杂问题的求解能力;近期,智能体框架则赋予模型调用工具、多轮交互的能力。
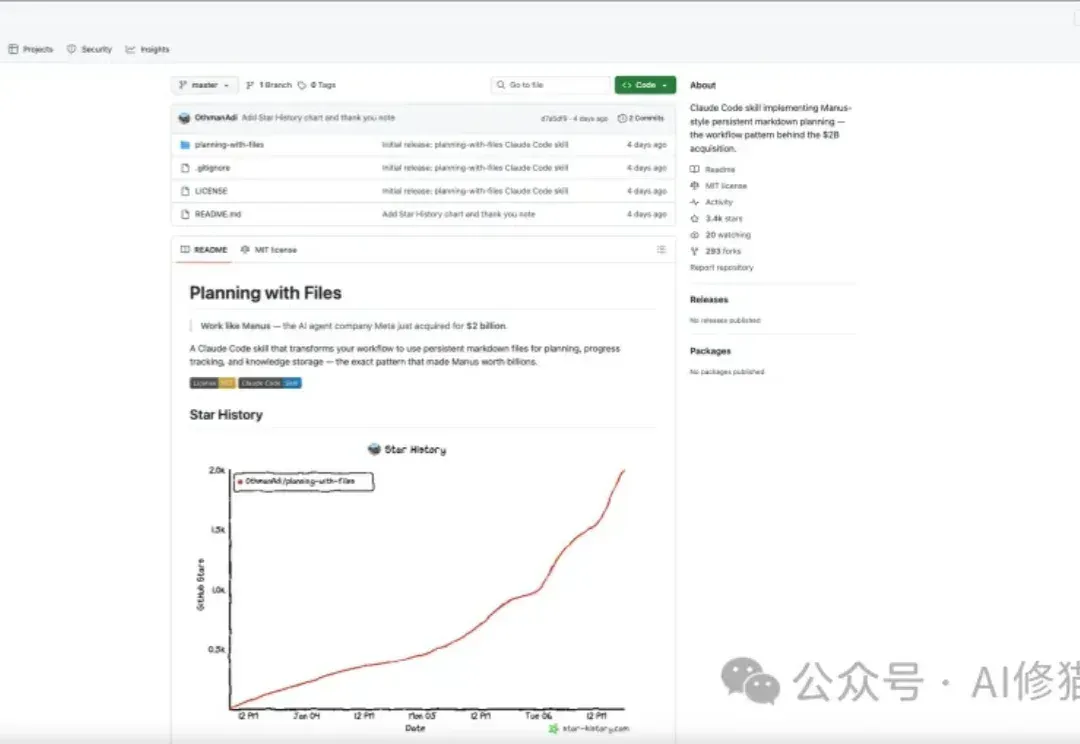
planning-with-files是开源社区最近疯传的一个Skill,发布仅四天收获3.3k star。目前还在持续增长。
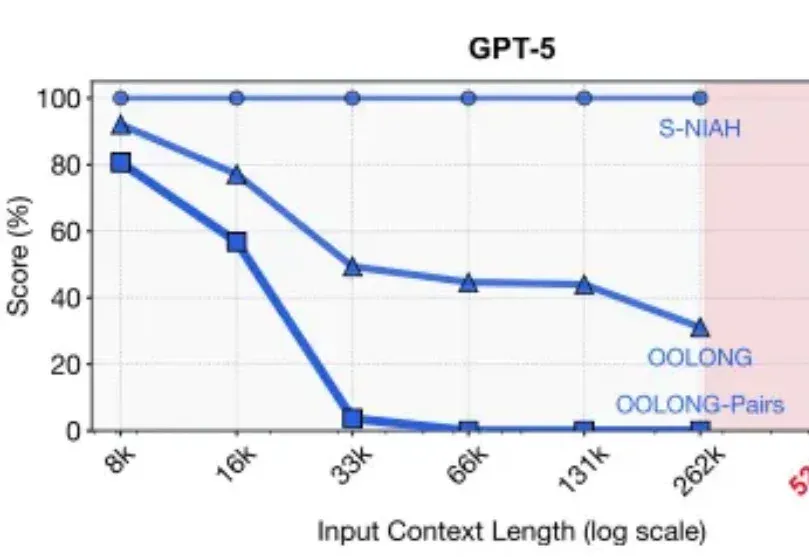
2025年的最后一天, MIT CSAIL提交了一份具有分量的工作。当整个业界都在疯狂卷模型上下文窗口(Context Window),试图将窗口拉长到100万甚至1000万token时,这篇论文却冷静地指出了一个被忽视的真相:这就好比试图通过背诵整本百科全书来回答一个复杂问题,既昂贵又低效。
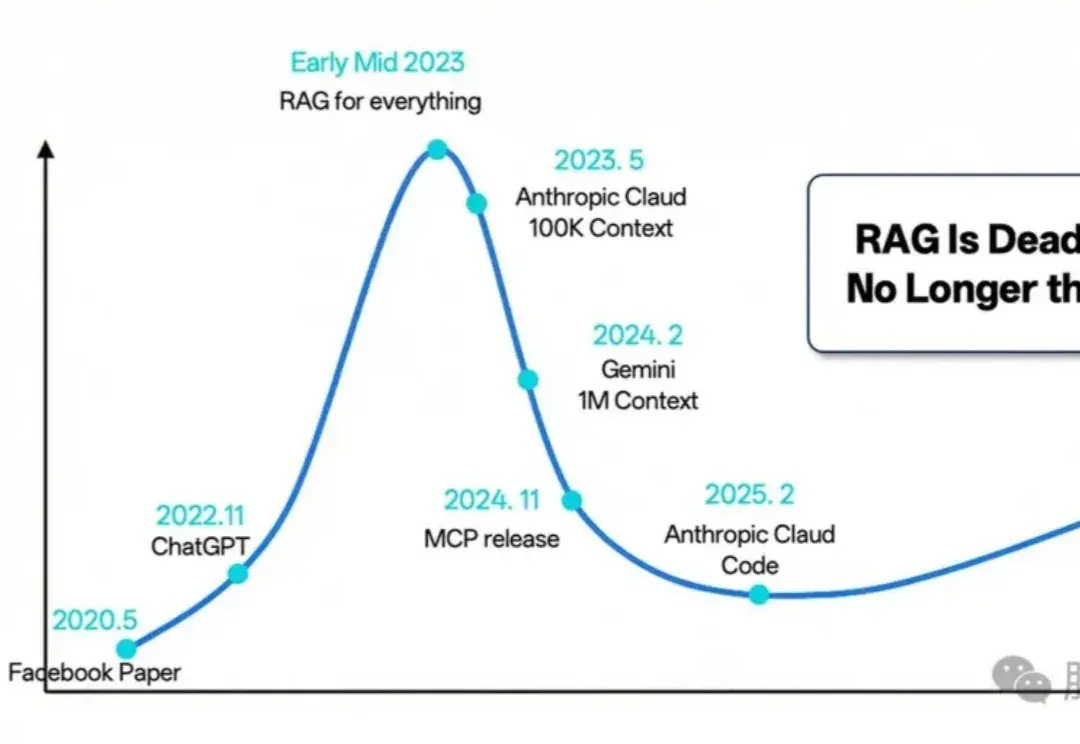
过去的 2025 年,对于检索增强生成(RAG)技术而言,是经历深刻反思、激烈辩论与实质性演进的一年。
dots.ocr 支持多语言文档的解析,能够在单一模型中统一完成版面检测、文本识别、表格解析、公式提取等任务,并保持良好的阅读顺序。他们之所以在一个模型中完成这些任务,是因为他们相信这些任务之间可以相互促进,为彼此提供更多的 context,从而达到更高的性能上限。目前,该项目的 star 量已经超过了 5000。
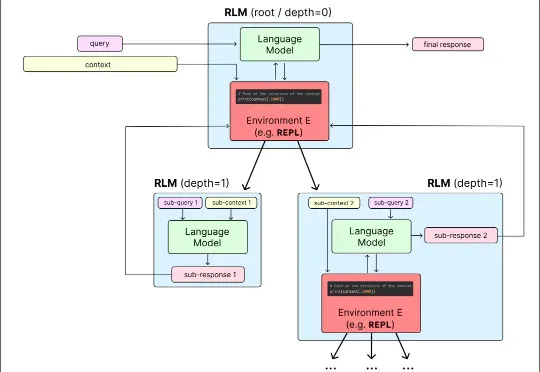
目前,所有主流 LLM 都有一个固定的上下文窗口(如 200k, 1M tokens)。一旦输入超过这个限制,模型就无法处理。 即使在窗口内,当上下文变得非常长时,模型的性能也会急剧下降,这种现象被称为「上下文腐烂」(Context Rot):模型会「忘记」开头的信息,或者整体推理能力下降。
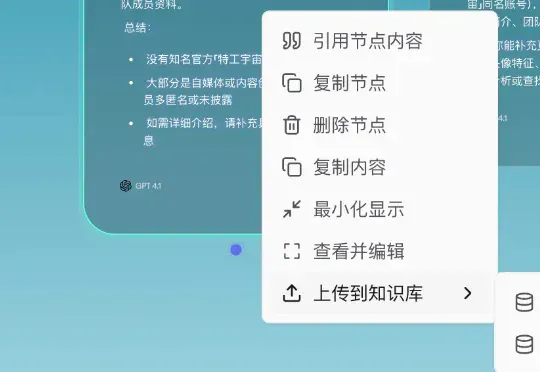
最近 flowith 推出了全新画布,交互形态全新升级,现在 AI 生成的任意内容,都可以被很方便的右键点击节点,存入任意知识库,后续工作都可以调用。说实话,flowith 是一款上手门槛比较高的产品,它不像一般对话式的 ChatBot 那样简单,