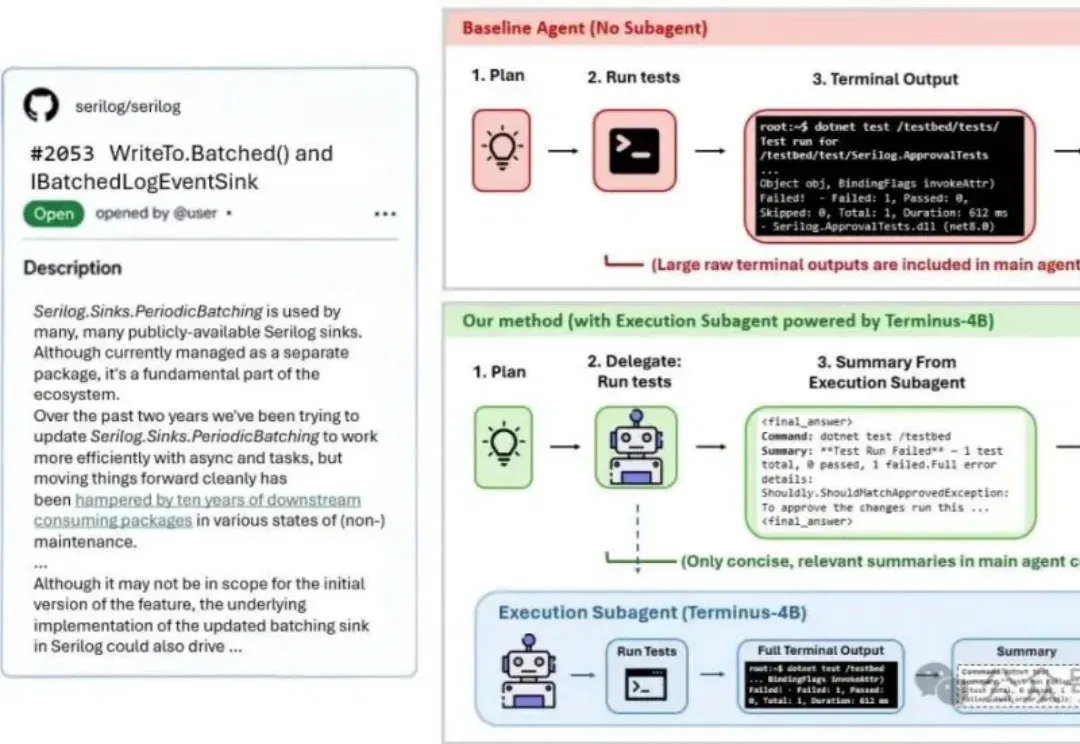
微软Terminus-4B之后,Agent可能会进入「专用小模型Sub Agent」时代 (opens in a new tab)
您有没有想过:在代码Agent里,执行终端命令、跑测试、读报错、总结日志这种任务,用Claude Opus、Claude Sonnet、GPT-5.3-Codex这类昂贵Token的大模型来执行,是不是有点浪费?一定要这么做吗?
Total 110 articles
您有没有想过:在代码Agent里,执行终端命令、跑测试、读报错、总结日志这种任务,用Claude Opus、Claude Sonnet、GPT-5.3-Codex这类昂贵Token的大模型来执行,是不是有点浪费?一定要这么做吗?
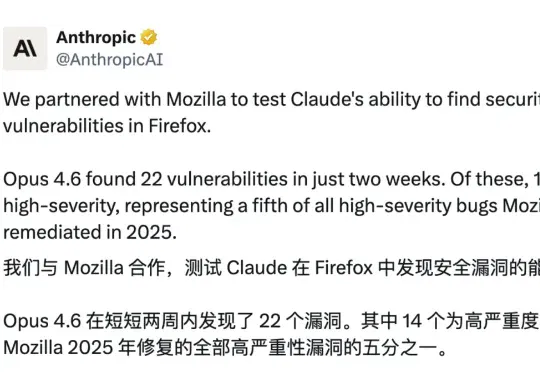
近日,Anthropic 公布了一组惊人的数字,在与 Mozilla 公司进行合作,测试旗下模型 Claude Opus 4.6 发现漏洞能力的过程中,两周内,就找出 Mozilla 公司「火狐」(Firefox)浏览器中 22 个不同的漏洞,其中 14 个是「高危漏洞」级别,而这几乎是 Mozilla 2025 年修复的全部「高危漏洞」的五分之一。
超越 GPT-5.5、Gemini 3.5 Flash、DeepSeek V4 Pro,阿里的最新旗舰模型 Qwen3.7 Max 在编程竞技榜拿下第二名,仅次于 Claude Opus 4.7。除了真实场景的用户选择,在传统的大模型固定评测榜单上,像是终端能力 Terminal Bench、编程能力 SWE Bench 等,Qwen3.7 Max 的表现也是拿下了国产模型的冠军。
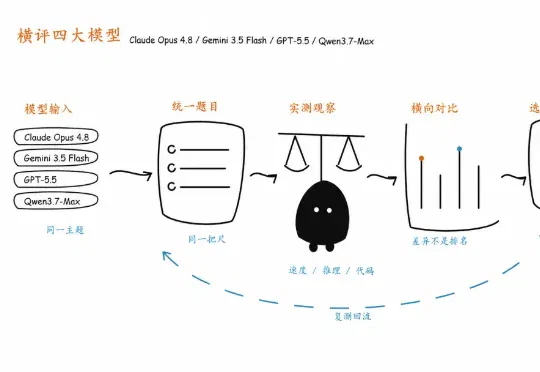
普通人看排行榜估计越看越疑惑,写文章该用哪个?数据分析该用哪个?写代码、审 PR、拆任务又该用哪个?我挑了四款最近讨论度很高的模型:Claude Opus 4.8、Gemini 3.5 Flash、GPT-5.5、Qwen3.7-Max,做一次横评,看看它们在真实任务里的交付表现。
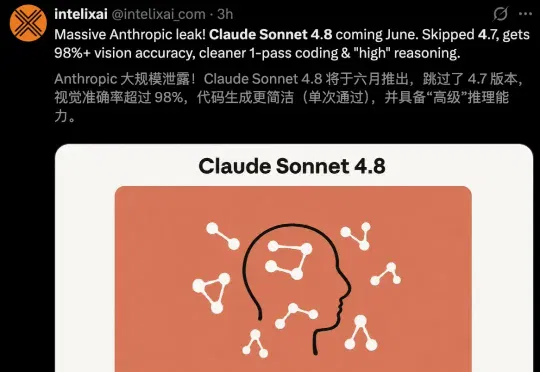
几乎同一天,Anthropic三大超级AI提前曝光!Claude Opus 4.8突袭谷歌后台,Sonnet 4.8跳级4.7。曾经叫嚣着「太危险不公开」的Mythos 1,也现身了。
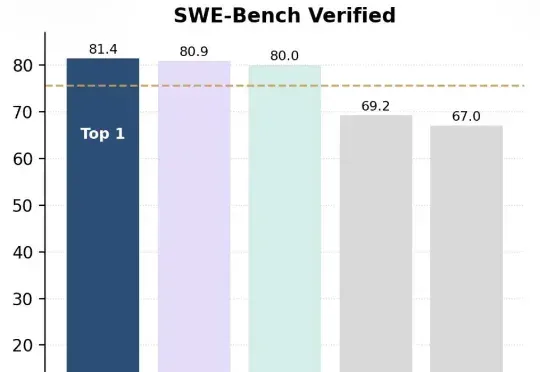
又一个中国新模型被推到聚光灯下,刷屏国内外科技圈。IQuest-Coder-V1模型系列,看起来真的很牛。在最新版SWE-Bench Verified榜单中,40B参数版本的IQuest-Coder取得了81.4%的成绩,这个成绩甚至超过了Claude Opus-4.5和GPT-5.2(这俩模型没有官方资料,但外界普遍猜测参数规模在千亿-万亿级)。
OpenAI深夜突袭,GPT-5.4新王炸场!一夜之间,直接粉碎了Gemini 3.1 Pro和Claude Opus 4.6的神话。这也是头一次,ChatGPT拥有真正「原生电脑使用」能力,办公效率直接拉满。而真正恐怖的地方在于,每一个维度上它都没有短板。
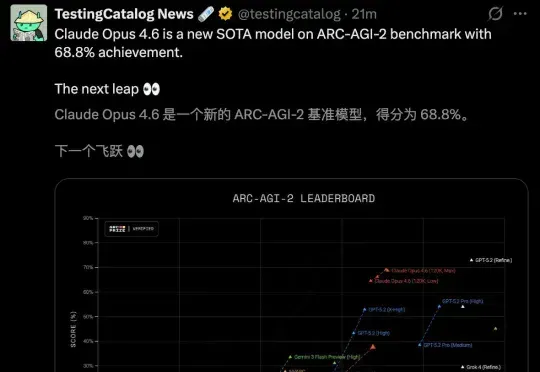
整个硅谷又癫狂了!Anthropic深夜扔出王炸,Claude 4.6用近乎恐怖的编程能力和智能体军团,给OpenAI和谷歌上了一堂名为「降维打击」的课。
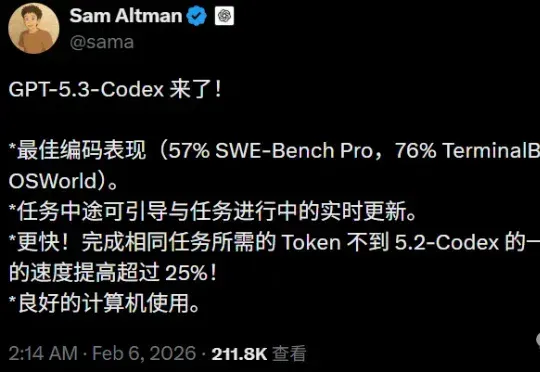
一天之内,两大编程AI轮番轰炸硅谷。Claude Opus 4.6之后,奥特曼紧急放出GPT-5.3-Codex。双雄争霸,彻底撕开AI王座争夺战的帷幕。
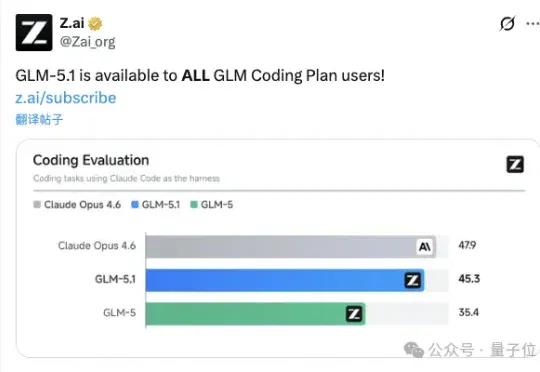
智谱GLM-5.1,突然上线!别的没再多说,只是默默甩出Coding Evaluation评测结果——在编程能力上相比上一代GLM-5直接飙升近10分。甚至嘛,距全球最强编程模型Claude Opus 4.6,也就只有2.6分之差??