Opus 5.5凭什么刷屏一周,看完这些爆款案例我悟了 (opens in a new tab)
Opus 5.5通过MV、3D游戏和机械沙虫等案例展示出编排完整创作流程的能力,文章指出爆款Demo正成为观察模型的新benchmark,但应结合时间、成本、工具与修改过程判断其成熟度。
Total 63 articles
Opus 5.5通过MV、3D游戏和机械沙虫等案例展示出编排完整创作流程的能力,文章指出爆款Demo正成为观察模型的新benchmark,但应结合时间、成本、工具与修改过程判断其成熟度。
模型的发布流程,早已在密集迭代中演变为精准的工业流水线:技术报告开路,Benchmark榜单刷屏,紧接着开放API,最后以开源权重收尾。
最近,葬AI和我们的朋友钟经纬、正阳一起,推出了懂模帝这个产品,现在任何人都可以登陆 fuckai.md 去看各种各样的benchmark。
对 AI Coding 来说,有人用,比任何 Benchmark 都管用,而有人持续付费,又比有人用更管用。
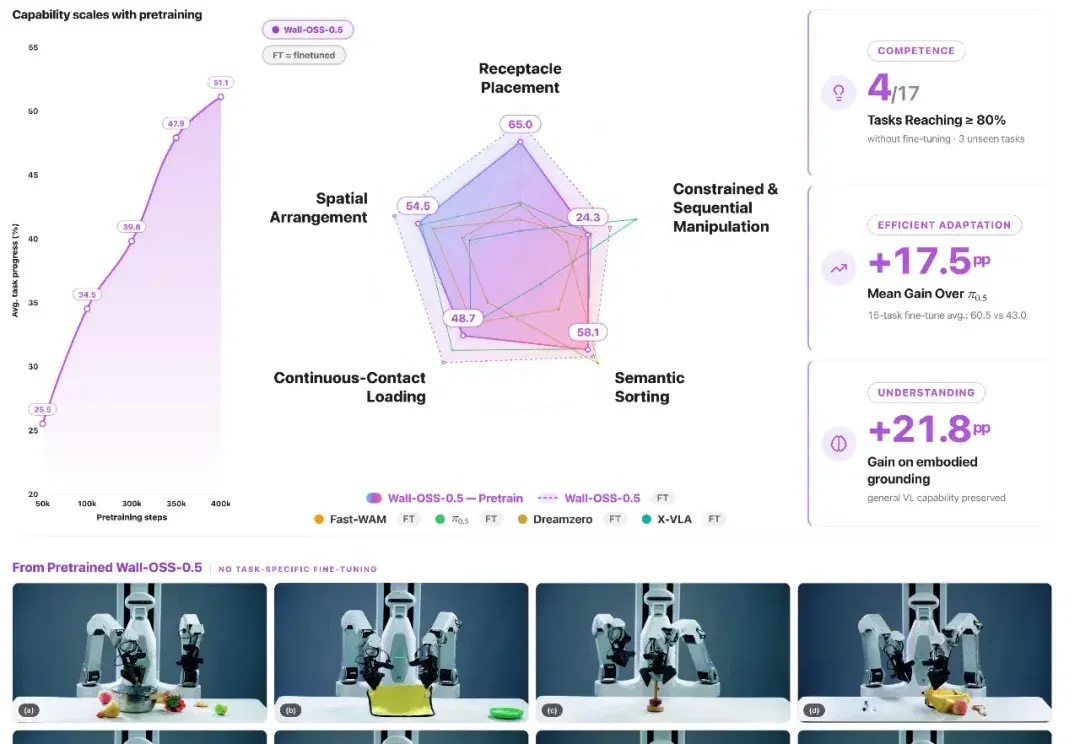
2026 年初,国内具身智能赛道掀起了一波开源潮,越来越多团队开始公开自己的视觉-语言-动作(VLA)模型、数据集与训练框架。与此同时,行业竞争也逐渐集中到 benchmark 成绩、任务成功率以及跨任务泛化能力上,尤其是在标准化或已训练任务中的表现。
本文综合北京大学王选计算机研究所发布的 ProactiveVideoQA 和 MMDuet2 两篇论文,介绍视频多模态大模型如何实现 “主动交互”—— 在视频播放过程中自主决定何时发起回复,而非等待用户提问。ProactiveVideoQA 提出评估指标和 benchmark,MMDuet2 则通过强化学习训练方法实现了 SOTA 性能,无需精确的回复时间标注即可训练出及时、准确的主动交互模型。
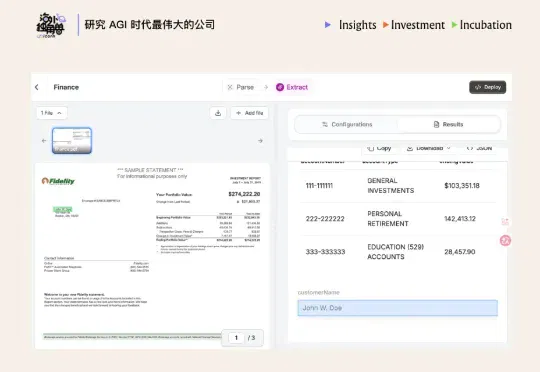
Reducto 在去年 6 个月内接连完成分别由 Benchmark 与 a16z 领投的两轮融资,估值翻了 3 倍,达到 6 亿美元。我们认为,Reducto 切中了 AI 应用走向生产环境过程中的“精确数据摄取”瓶颈。
今天,国产大模型再次迎来硬核进阶! 科大讯飞小年放出推理王炸——星火大模型X2。 什么概念呢?从星火X1.5到星火X2,仅仅间隔3个月,推理性能直接飙升50%~ 不仅快,而且猛。更重要的是,完全基于国产算力。 一方面,模型通用能力突出,Benchmark评测稳居行业一流水平,即使是和GPT-5.2、Gemini-3-Pro这些国际顶尖模型同台竞技也毫不逊色。 尤其是在数学计算、逻辑推理等核心能力上表现亮眼;同时130多种语言综合能力依旧稳稳在线,继续保持“国家队”水准。 另一方面,星火X2将升级的重点放在了场景落地上。 依靠深度优化的算法、高质量垂域数据和行业专家的参与,三位一体推动行业大模型
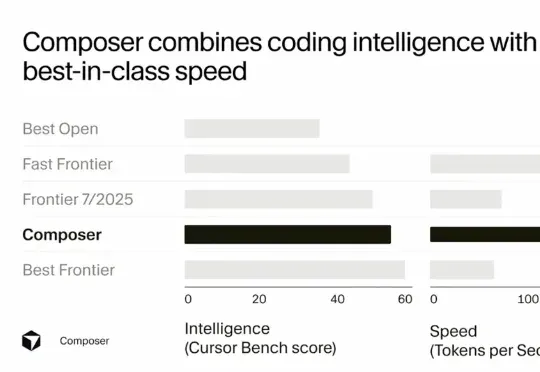
Sasha Rush 在分享开头就提到,Cursor Composer 在他们的内部 benchmark 上的表现几乎与最好的 Frontier 模型(前沿模型)持平,并且优于去年夏天发布的所有模型。它的表现明显好于最好的开源模型,以及那些被标榜为"快速"的模型。
香港科技大学KnowComp实验室提出基于《欧盟人工智能法案》和《GDPR》的LLM安全新范式,构建合规测试基准并训练出性能优异的推理模型,为大语言模型安全管理提供了新方向。