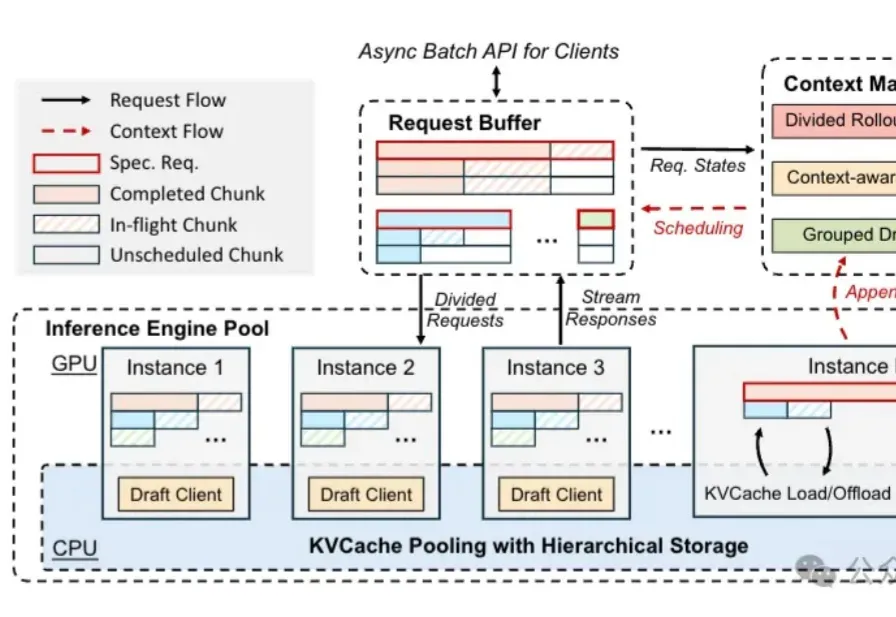
月之暗面公开强化学习训练加速方法:训练速度暴涨97%,长尾延迟狂降93% (opens in a new tab)
u1s1,现在模型能力是Plus了,但Rollout阶段的速度却越来越慢……
Total 60 articles
u1s1,现在模型能力是Plus了,但Rollout阶段的速度却越来越慢……
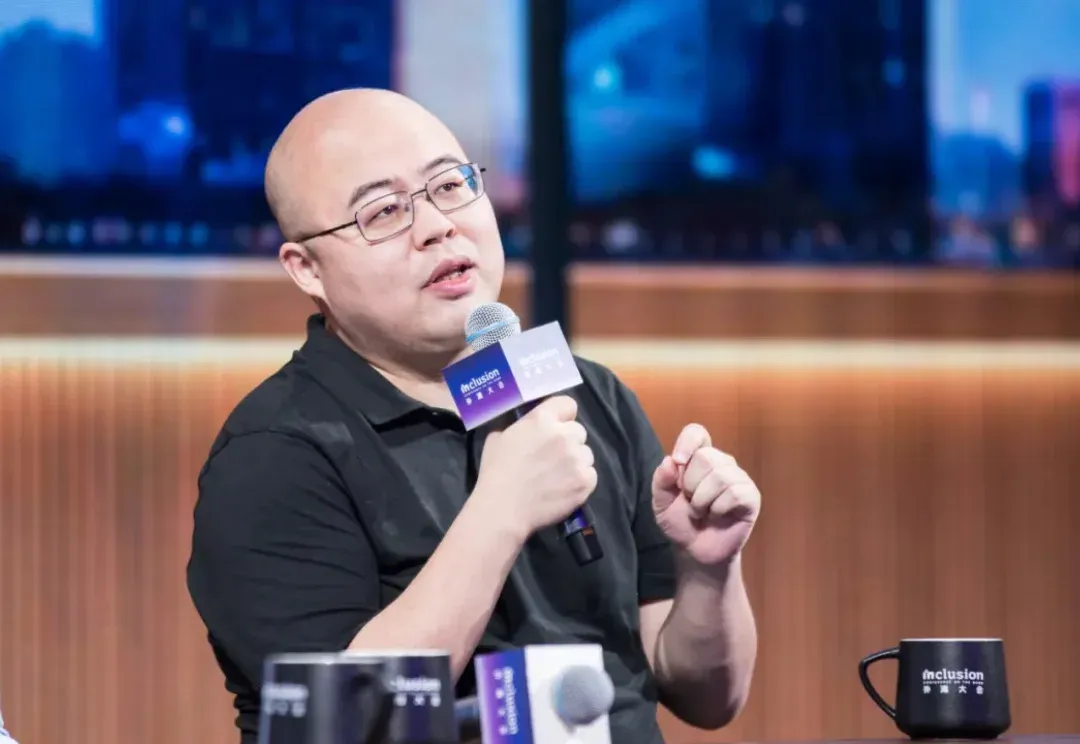
一时的技术成果或者用户增长,很难成为 AI 公司的竞争优势。
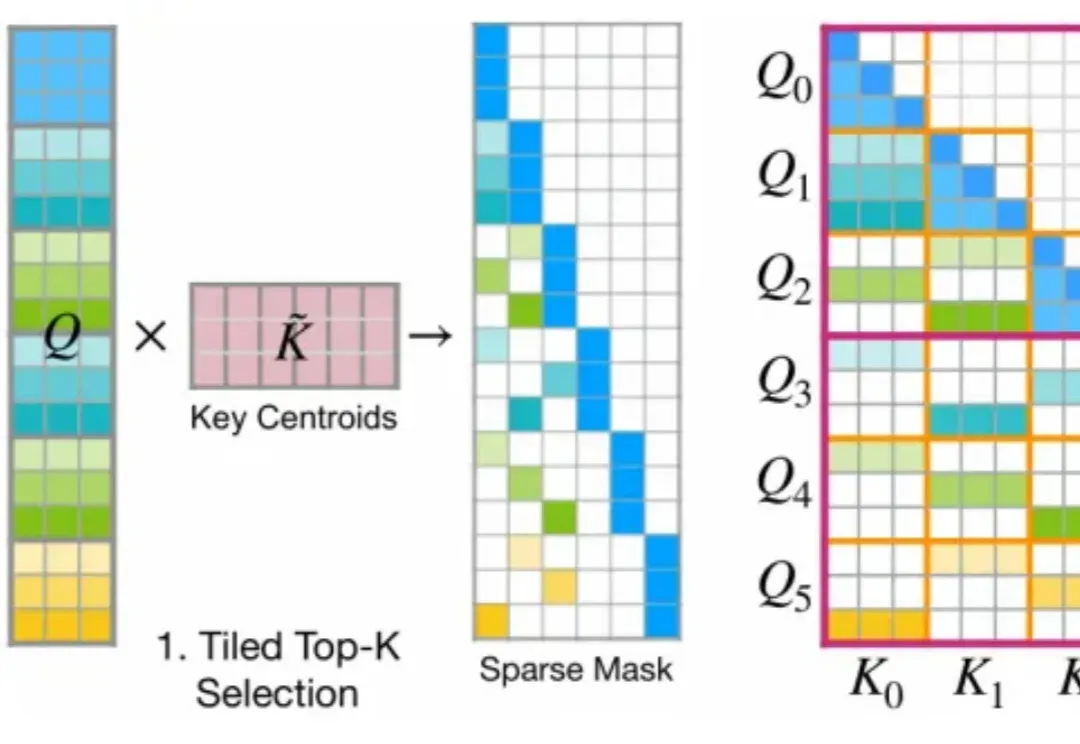
今年 2 月,月之暗面提出了一种名为 MoBA 的注意力机制,即 Mixture of Block Attention,可以直译为「块注意力混合」。
Kimi K2 Thinking训练真的只花了460万美元?杨植麟亲自带队,月之暗面创始团队出面回应了。这不是官方数据。训练成本很难计算,因为其中很大一部分用于研究和实验。他们还透露训练使用了配备Infiniband的英伟达H800,GPU数量也比巨头的少,但充分利用了每一张卡。
2025年前盛行的闭源+重资本范式正被DeepSeek-R1与月之暗面Kimi K2 Thinking改写,二者以数百万美元成本、开源权重,凭MoE与MuonClip等优化,在SWE-Bench与BrowseComp等基准追平或超越GPT-5,并以更低API价格与本地部署撬动市场预期,促使行业从砸钱堆料转向以架构创新与稳定训练为核心的高效路线。
昨天,月之暗面发布全新模型Kimi K2 Thinking,一上线就挤爆了服务器。思考,是它的核心卖点,自称是开源的「思考Agent模型」。在Tau2 Bench Telecom基准测试中,K2 Thinking位列第一。
月之暗面最新发布的开源Kimi Linear架构,用一种全新的注意力机制,在相同训练条件下首次超越了全注意力模型。在长上下文任务中,它不仅减少了75%的KV缓存需求,还实现了高达6倍的推理加速。
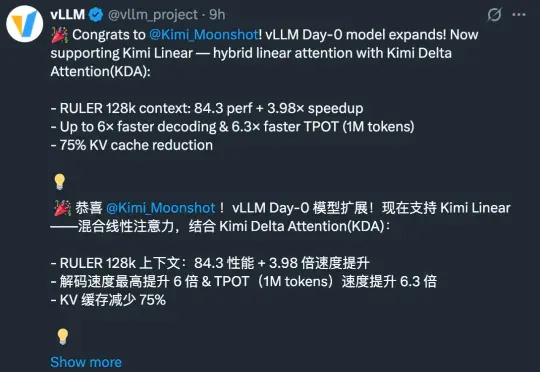
月之暗面在这一方向有所突破。在一篇新的技术报告中,他们提出了一种新的混合线性注意力架构 ——Kimi Linear。该架构在各种场景中都优于传统的全注意力方法,包括短文本、长文本以及强化学习的 scaling 机制。
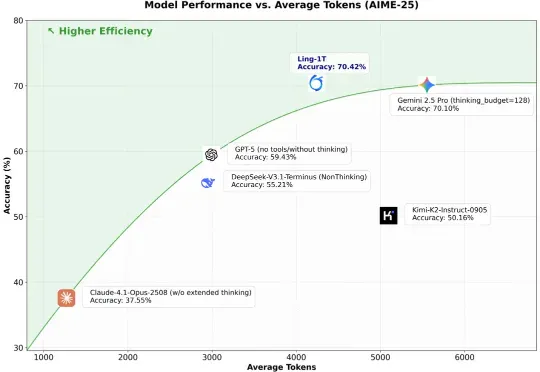
10 月 9 日凌晨,百灵大模型再度出手,正式发布并开源通用语言大模型 Ling-1T ——蚂蚁迄今为止开源的参数规模最大的语言模型。至此,继月之暗面Kimi K2、阿里 Qwen3-Max 之后,又一位重量级选手迈入万亿参数LLM 「开源俱乐部」。
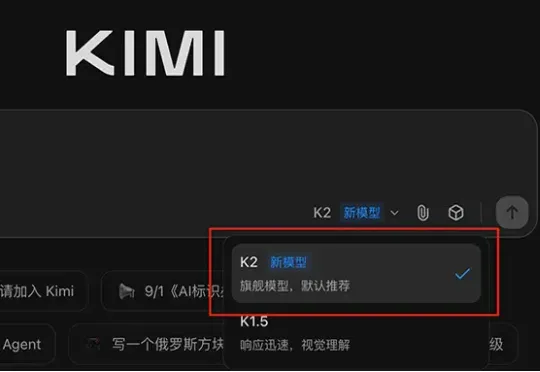
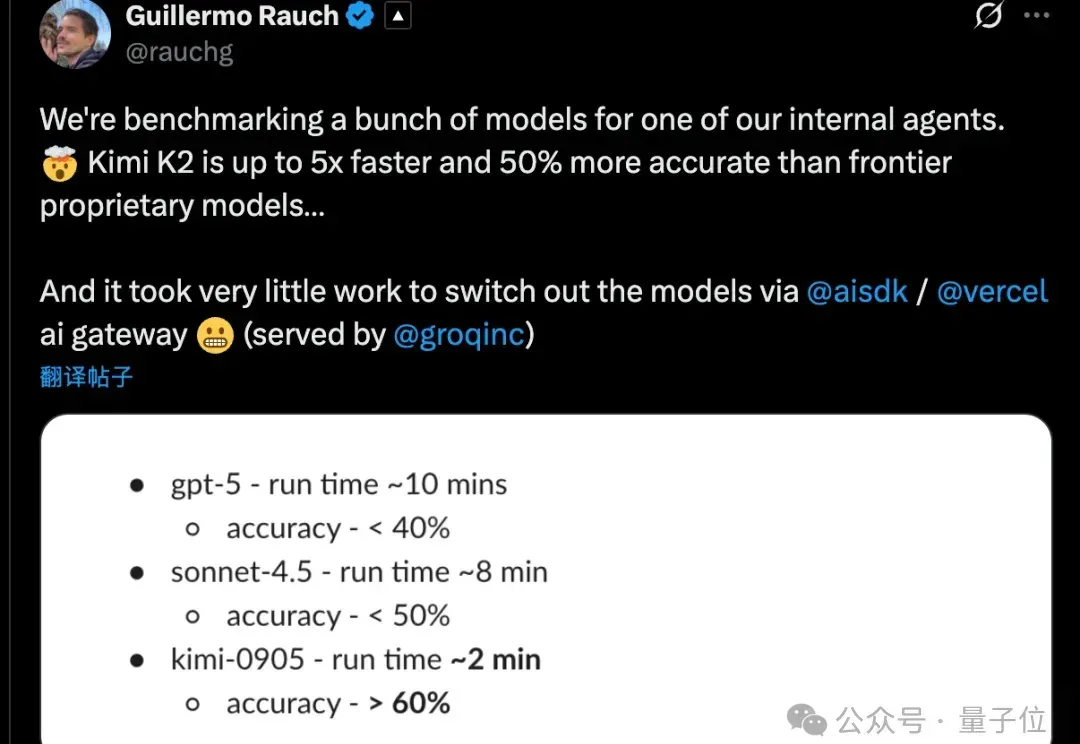
智东西9月5日消息,刚刚,大模型独角兽月之暗面发布新模型Kimi K2-0905,目前,Kimi应用和网页版中的K2模型已全量升级到Kimi K2-0905。该模型的核心升级点为Agentic Coding能力增强、支持256K上下文、API支持高达60-100Token/s的输出速度、支持Claude Code。