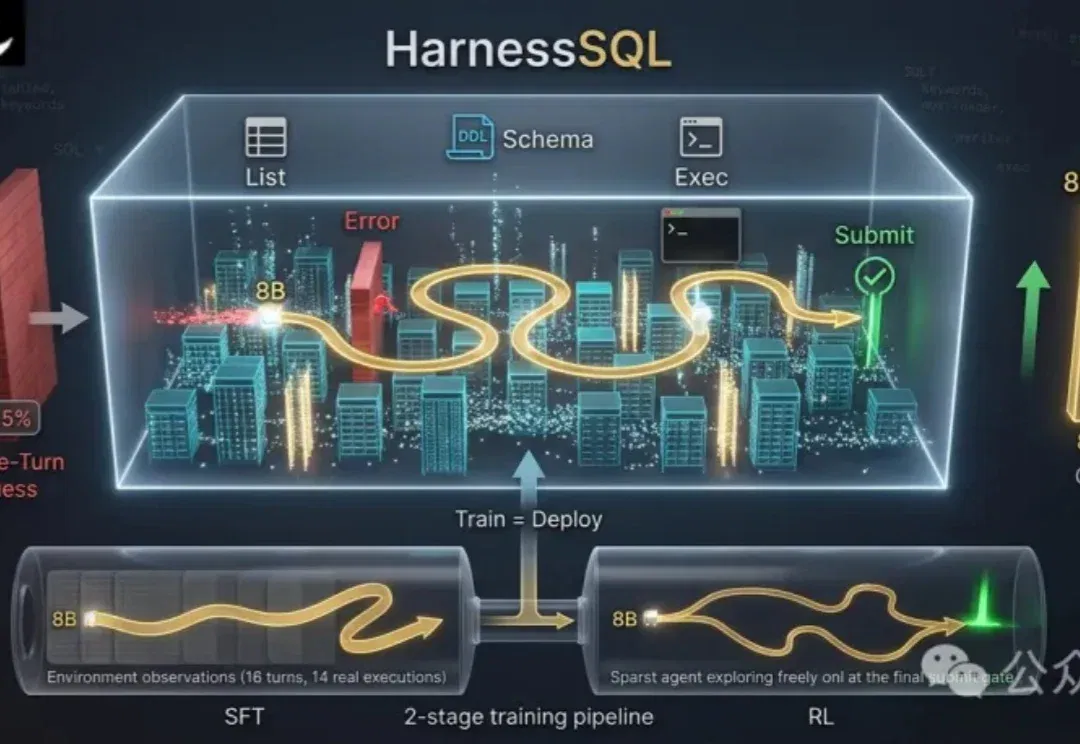
HarnessSQL 开源:把数据库交互环境纳入 SQL Agent 训练 (opens in a new tab)
HarnessSQL 在只读数据库沙盒内结合完整轨迹微调与执行奖励强化学习,让模型学习查表、试探查询和纠错。在Spider 2.0-SQLite上,8B模型报告45.2%执行准确率,高于所列32B基线;跨方言和更完整企业环境仍需进一步扩展。
Total 198 articles
HarnessSQL 在只读数据库沙盒内结合完整轨迹微调与执行奖励强化学习,让模型学习查表、试探查询和纠错。在Spider 2.0-SQLite上,8B模型报告45.2%执行准确率,高于所列32B基线;跨方言和更完整企业环境仍需进一步扩展。
过去一年,具身智能的技术迭代明显加快。VLA、世界模型持续演进,强化学习重新成为机器人学习的重要技术路径,Sim2Real加速从仿真走向真机,全身控制能力也在快速突破。

WalkingLab 是由清华大学与香港大学团队发起的开源非营利实验室,专注真实世界 AI 与项目制学习,成立五个月已推出涵盖工程实践、强化学习和大语言模型的三门核心课程,累计获超 20,000 GitHub Star 并登上 Hacker News 首页,致力于通过真实项目连接课程、论文与工程实践,加速 AGI 到来。
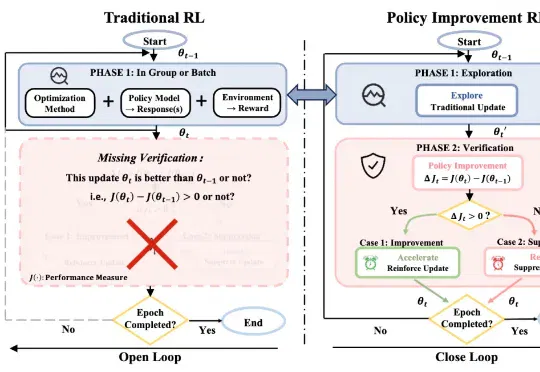
来自北航、北大、美团的研究团队提出了Policy Improvement Reinforcement Learning, PIRL,以及对应的落地算法 PIPO。这项工作关注的是大模型 RL 后训练中一个非常基础、但长期被默认跳过的问题:一次更新在当前数据上看起来优化了学习信号,是否就真的说明模型策略变强了?
Mindverse 完成由美团领投的 A 轮融资,元禾璞华、韶音、变量资本和老股东追加跟投。Mindverse (心洲科技) 是少数把赌注押在模型「内部」的一家创企,它在通用大模型的基础上,用强化学习让它从复杂、多步骤的真实任务中学会如何把事做成,让模型从「知道很多」变为「能办好事」。
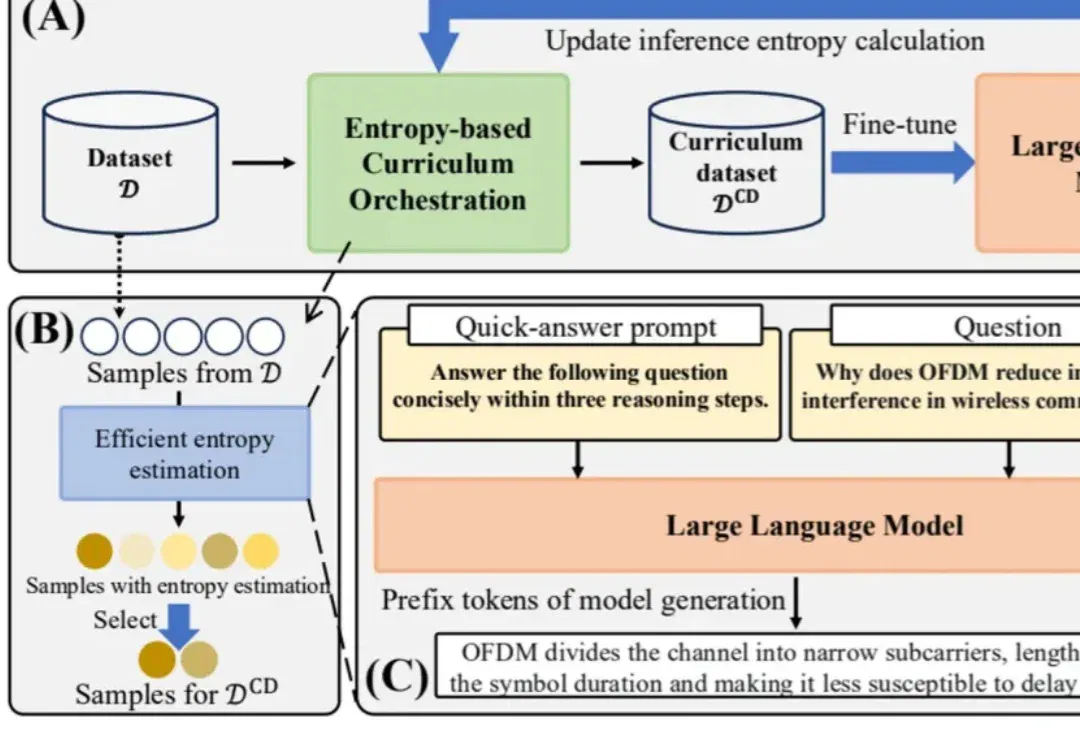
在大模型后训练中,数据不再只是 “越多越好”,而是要像人类学习一样,动态选择最合适难度的样本。华为提出的 EDCO 方法,将样本难度估计与动态课程编排引入领域大模型微调;数月后,由 Rutgers、Amazon、Google 等作者参与的 DARE 论文即引用 EDCO,并将其作为难度感知强化学习训练的重要对比基线。
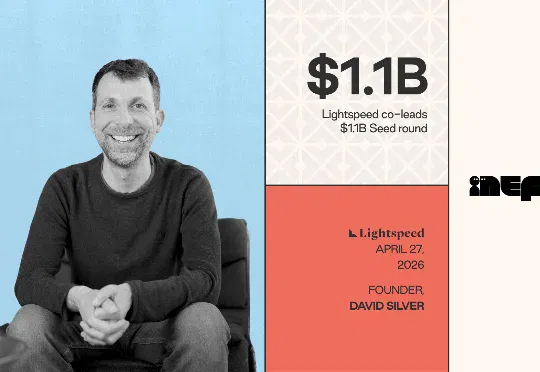
AlphaGo 之父 David Silver 创办的 Ineffable Intelligence 获 11 亿美元种子轮,创欧洲融资纪录,估值达 51 亿美元。这家公司押注强化学习和自我经验学习,试图挑战依赖 Scaling Law 的大模型主线。
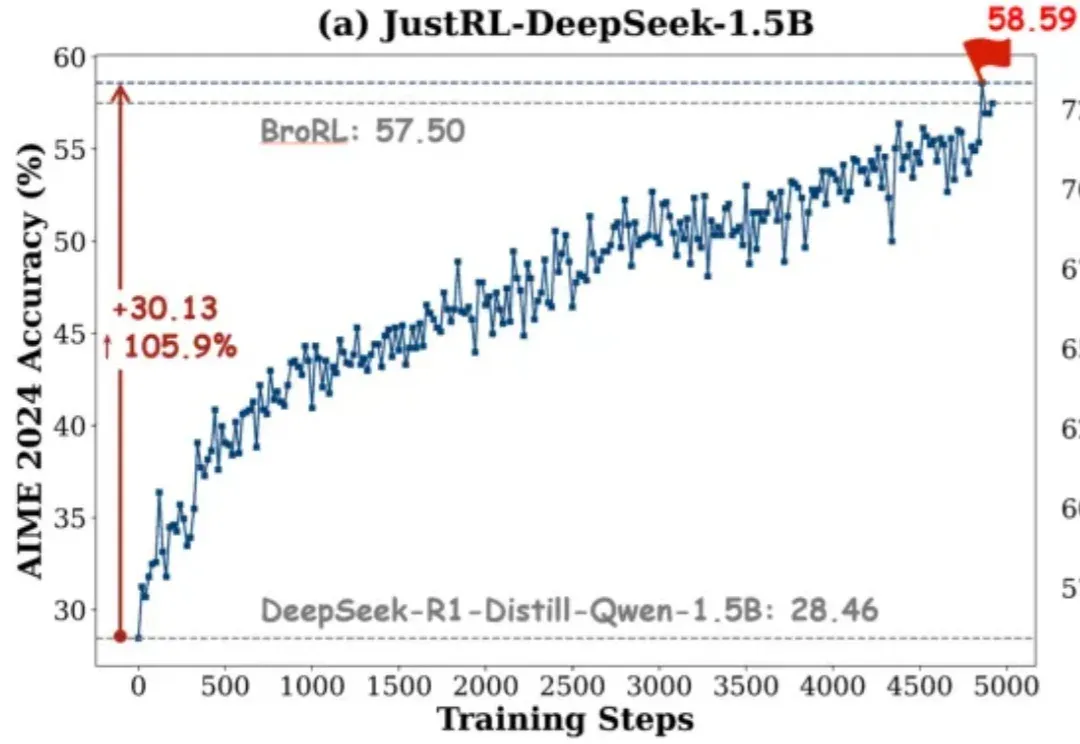
如果有人告诉你:不用分阶段做强化学习、不搞课程学习、不动态调参,只用最基础的 RL 配方就能达到小模型数学推理能力 SOTA,你信吗?
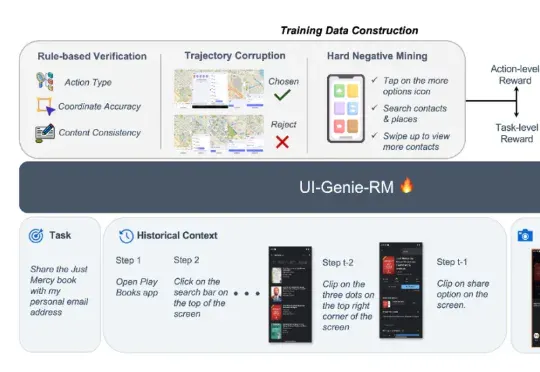
本文来自于香港中文大学 MMLab 和 vivo AI Lab,其中论文第一作者肖涵,主要研究方向为多模态大模型和智能体学习,合作作者王国志,研究方向为多模态大模型和 Agent 强化学习。项目 le
传统智能体系统难以兼顾稳定性和学习能力,斯坦福等学者提出AgentFlow框架,通过模块化和实时强化学习,在推理中持续优化策略,并使小规模模型在多项任务中超越GPT-4o,为AI发展开辟新思路。