全球最大开源具身大模型!中国机器人跑完马拉松后开始学思考 (opens in a new tab)
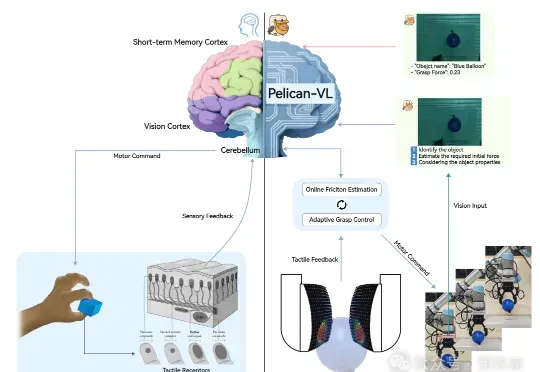
昨天,全球参数量最大的具身智能多模态大模型——Pelican-VL 1.0正式开源。它不仅覆盖了7B到72B级别,能够同时理解图像、视频和语言指令,并将这些感知信息转化为可执行的物理操作。
Total 85 articles
昨天,全球参数量最大的具身智能多模态大模型——Pelican-VL 1.0正式开源。它不仅覆盖了7B到72B级别,能够同时理解图像、视频和语言指令,并将这些感知信息转化为可执行的物理操作。
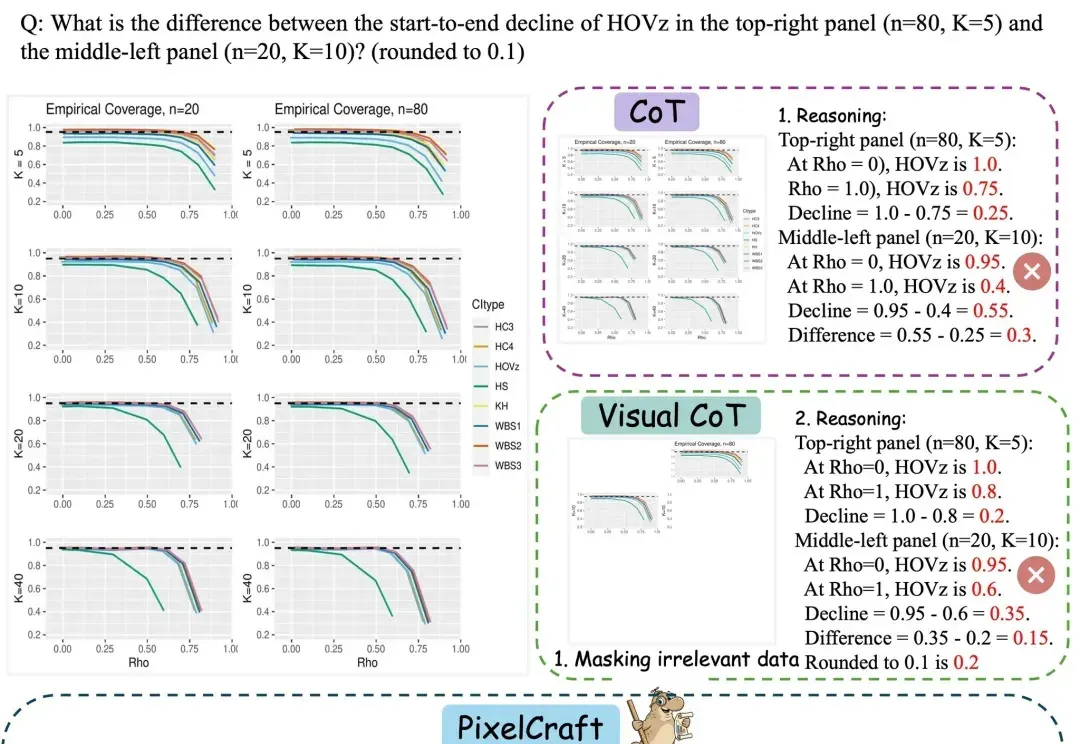
多模态大模型(MLLM)在自然图像上已取得显著进展,但当问题落在图表、几何草图、科研绘图等结构化图像上时,细小的感知误差会迅速放大为推理偏差。
用强化学习(RL)优化文生图模型的 prompt following 能力,是一条被广泛验证的路径 —— 让模型根据 prompt 用不同随机种子生成多张图片,通过 reward model 计算 reward,再利用相关 RL 算法优化模型。
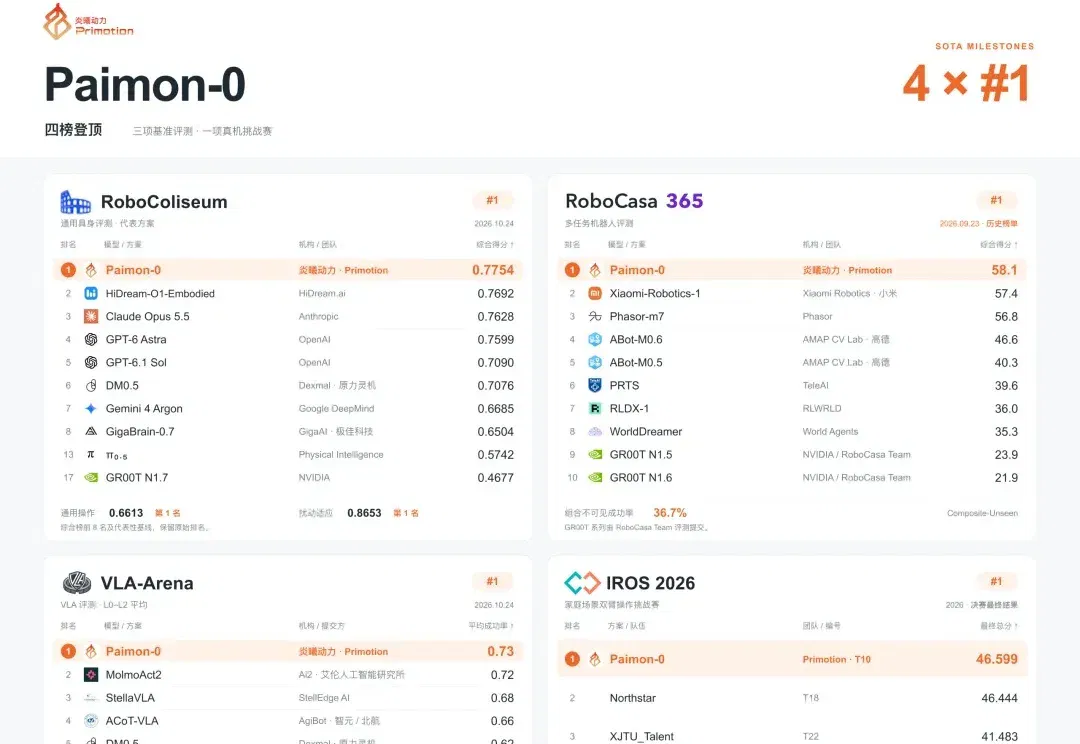
太反差了。 一家在深圳成立刚满三个月的公司,明明给自己的定位是做具身芯片,可它对外拿出的第一份成果,却是一个名叫Paimon的具身基座模型(系列)。 然后这个系列里的首款模型Paimon-0初次亮相,就直接拿下了四项第一: 先看含金量最高的RoboColiseum,这个由 Hugging Face、NVIDIA、清华大学等全球近 20 家高校、企业、科研机构共建的榜单,最近在具身圈热度居高不下;Paimon-0 以 0.7754 分排在第一。 要知道,这个榜最近可是刚把GPT-6 Astra、Claude Opus 5.5、Gemini 4 Argon这些通用多模态大模型请进场同台比试的: 虽
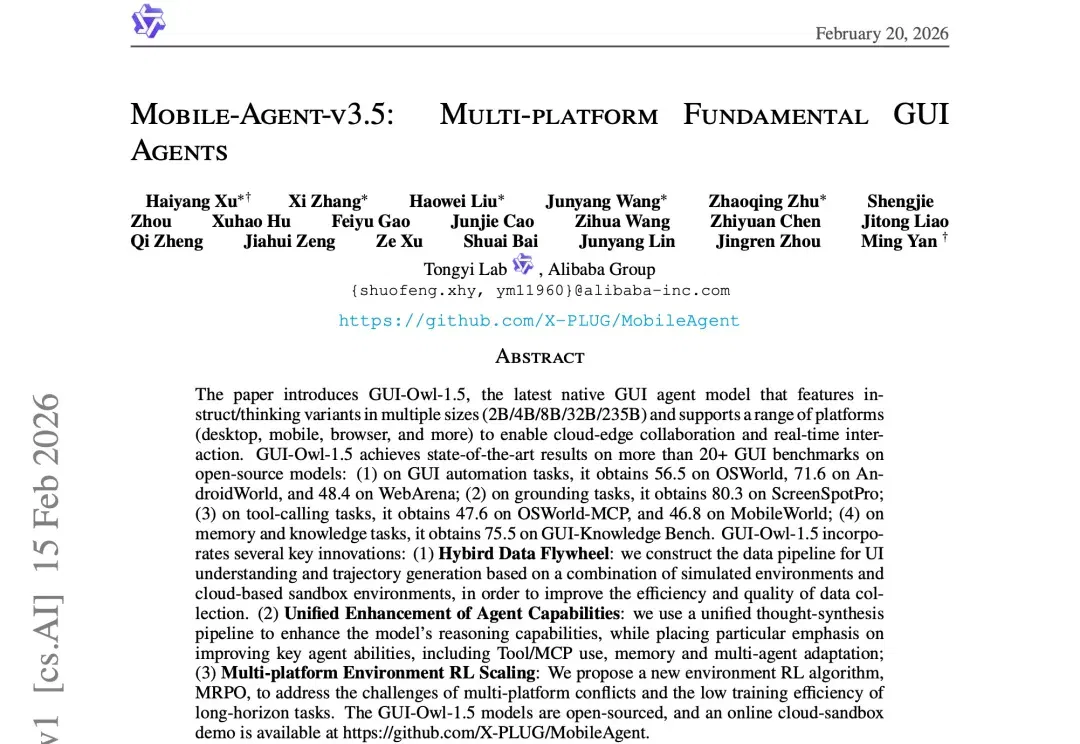
伴随多模态大模型的发展,GUI Agent正成为人机交互的新范式。
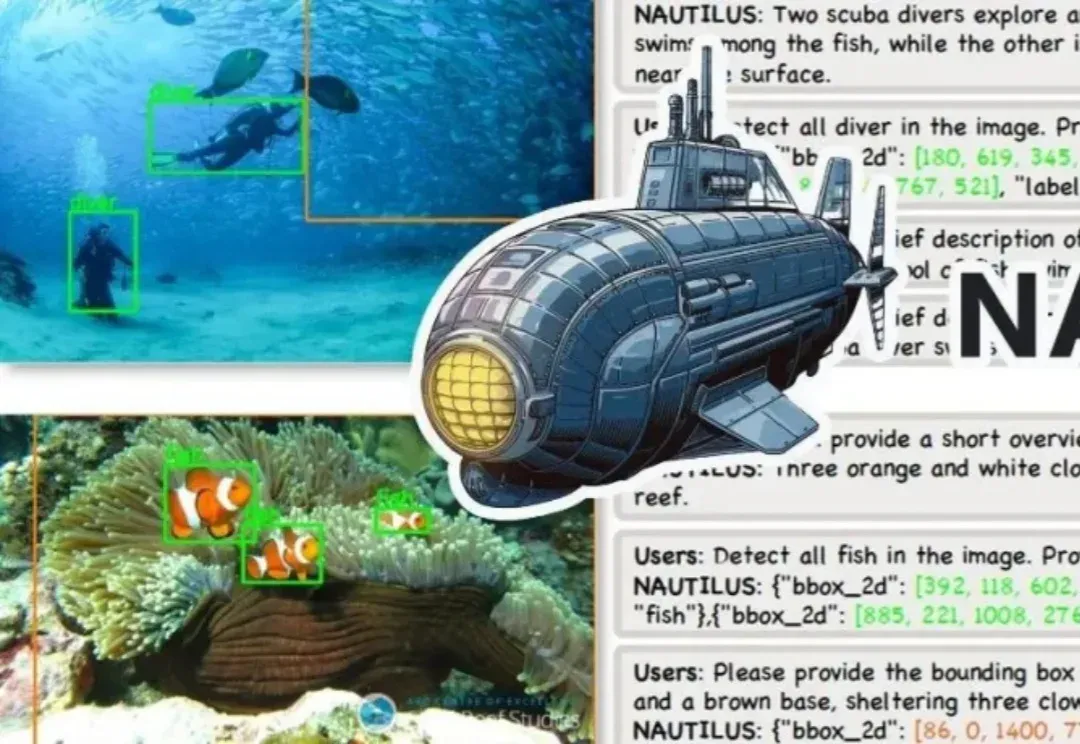
华中科技大学团队推出首个水下多模态大模型NAUTILUS,支持8种水下场景理解任务,并开源145万图文对的NautData数据集。模型通过视觉特征增强模块解决水下图像模糊和颜色失真问题,性能超越现有模型,恶劣环境下表现更佳。
本文作者团队来自 Insta360 影石研究院及其合作高校。目前,Insta360 正在面向世界模型、多模态大模型、生成式模型等前沿方向招聘实习生与全职算法工程师,欢迎有志于前沿 AI 研究与落地的同
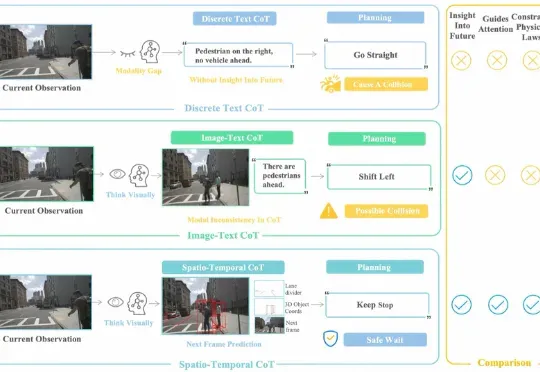
面向自动驾驶的多模态大模型在 “推理链” 上多以文字或符号为中介,易造成空间 - 时间关系模糊与细粒度信息丢失。FSDrive(FutureSightDrive)提出 “时空视觉 CoT”(Spatio-Temporal Chain-of-Thought),让模型直接 “以图思考”,用统一的未来图像帧作为中间推理步骤,联合未来场景与感知结果进行可视化推理。
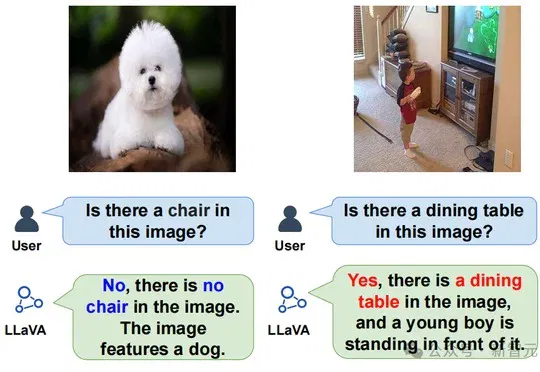
新智元报道 多模态大模型的物体幻觉,长期被归因于语言先验。 先看下面两组对话。 第一组,一张只有小狗的照片,问模型「图中有椅子吗」,它答「没有,图中是一只狗」,完全正确; 第二组,另一张照片,问「图中
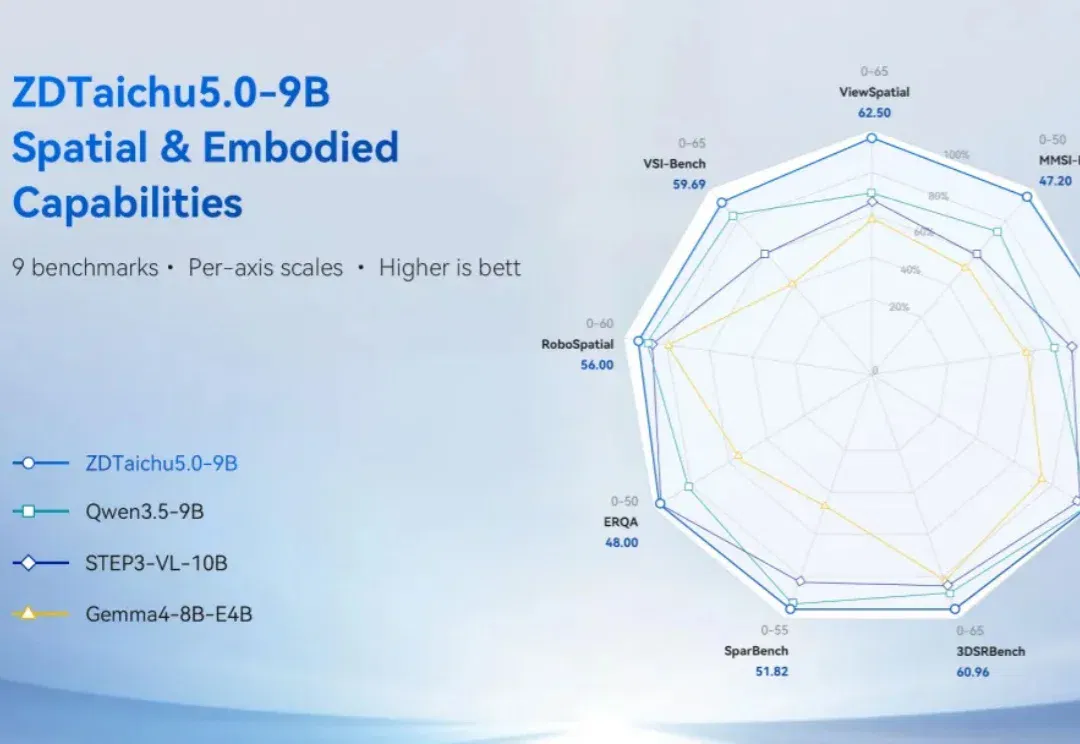
紫东太初开源的这个通用多模态大模型 ZDTaichu5.0-9B,简直夯爆了!