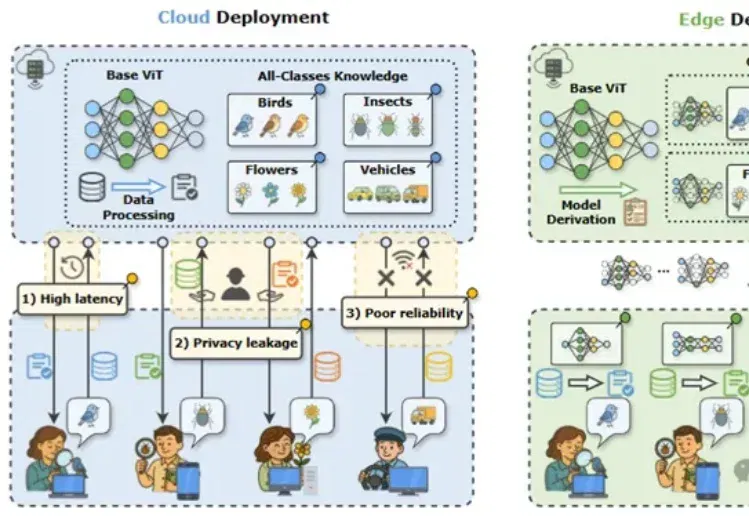
模型砍掉一大半,准确率反升15%!华科&阿里安全新研究实现ViT近乎无损的类特定压缩|ICLR'26 (opens in a new tab)
近年来,视觉大模型在自动驾驶、智慧医疗等场景中得到广泛应用,但在真实业务环境中,“大而全”的通用模型往往并不是最优选择。
Total 1519 articles
近年来,视觉大模型在自动驾驶、智慧医疗等场景中得到广泛应用,但在真实业务环境中,“大而全”的通用模型往往并不是最优选择。
全新的具身模型空间能力评估范式 Theory of Space 突破了传统静态图文问答的局限,系统性地考察基础模型能否像人一样,在部分可观测的动态环境中,通过自主探索来构建、修正和利用空间信念。该论文已被 ICLR 2026 接收。
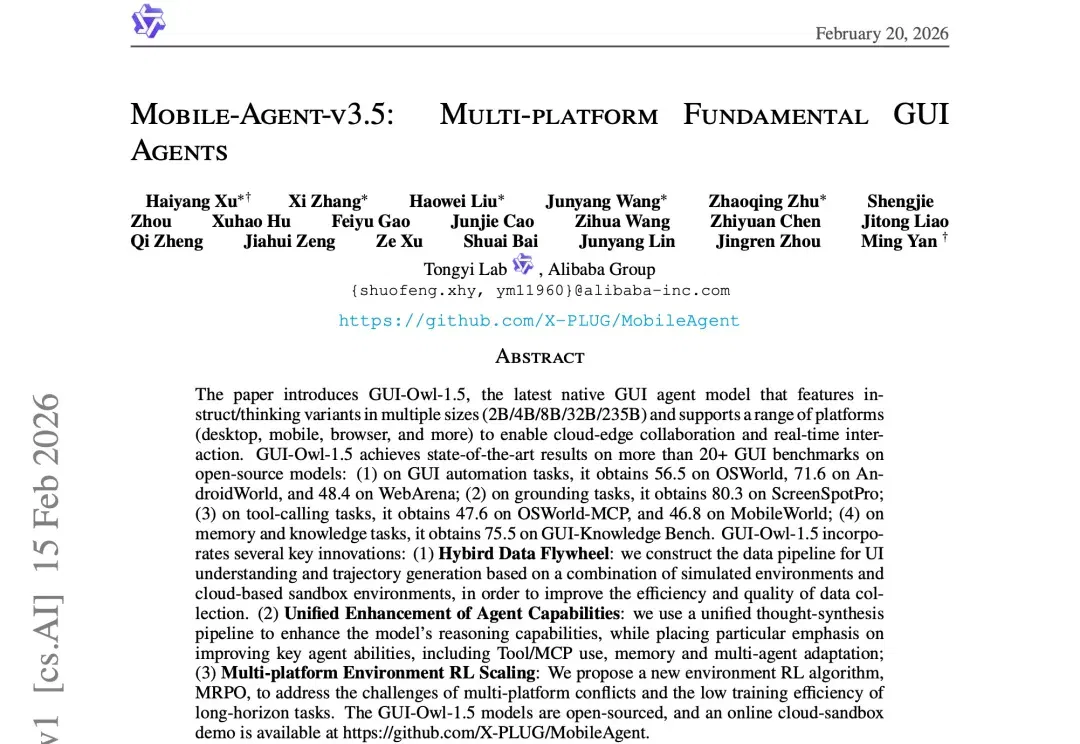
伴随多模态大模型的发展,GUI Agent正成为人机交互的新范式。
全球最大游戏博主 PewDiePie,又整活了。他靠着「偷师」DeepSeek、清华大学发布的技术文档,用一堆魔改显卡成功微调出一个自己的 AI 模型,而这个模型在编程基准测试中的表现,竟然超越了 GPT-4 和 Gemini 2.5 Pro。
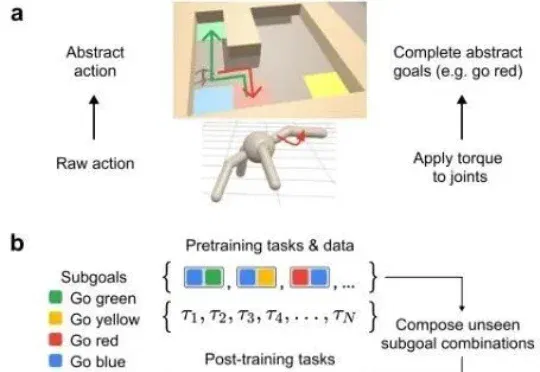
传统AI模型在稀疏奖励环境中,往往会找不到激励难以学会层次化思考。如今,谷歌团队通过引入元控制器操控模型内部残差流,让智能体学会了「跳跃式思考」。该研究揭示了大模型内部可自发形成了类似人脑的层次化决策机制,为AI在需要多步的复杂任务提供了全新的训练范式。
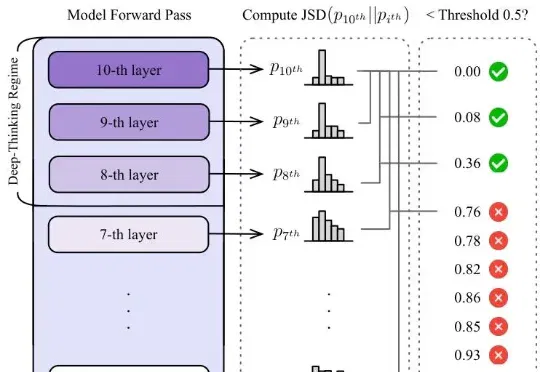
大模型的思维链越长,推理能力就越强?谷歌Say No——token数量和推理质量,真没啥正相关,因为token和token还不一样,有些纯凑数,深度思考token才真有用。新研究抛弃字数论,甩出衡量模型推理质量的全新标准DTR,专门揪模型是在真思考还是水字数。
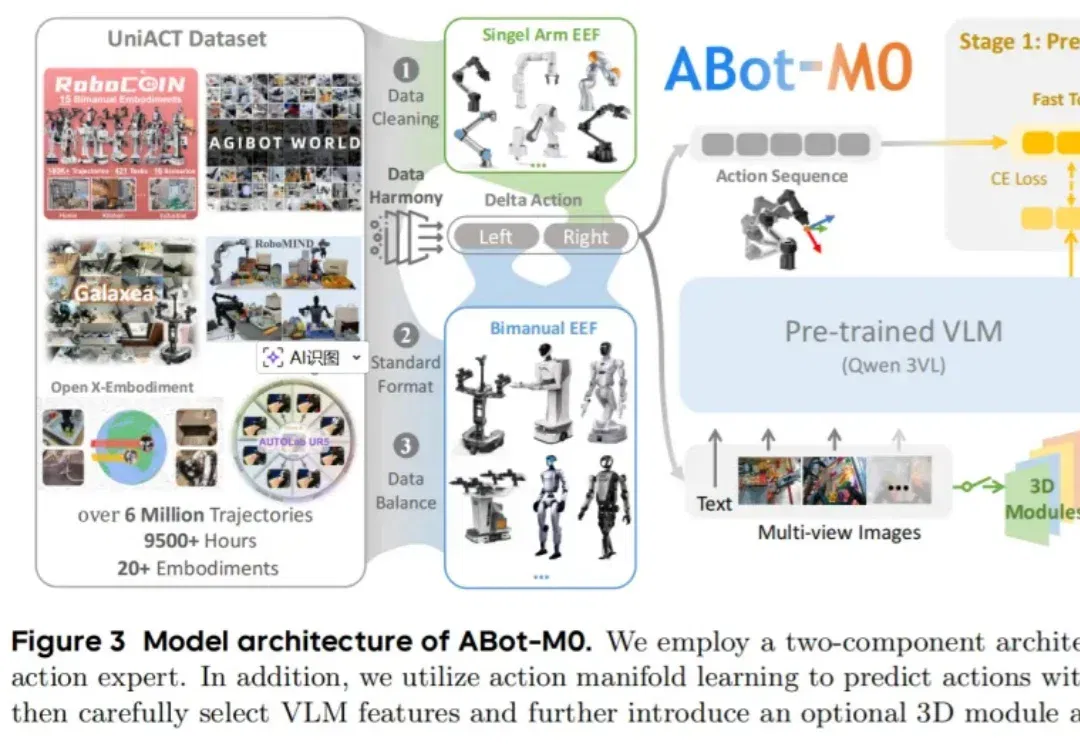
过去几年,大模型把自然语言处理彻底重塑了。GPT 出来之前,NLP 领域的状态是:每个任务一套模型,每个场景一批数据,每个公司一条流水线,互不通用,边界清晰。GPT 之后,这套逻辑被一个预训练底座 + 任务微调的范式整个替换掉了。
Anthropic的新模型要来了!代号Fennec的Claude Sonnet 5马上要发布,性能吊打市面上所有编程大模型,价格还砍掉50%,还能比肩一整个人类开发团队,可以说达到编程领域的巅峰。
行业内许多人认为AI 模型市场的赢家早已确定:大型科技公司将主导市场(谷歌、Meta、微软,以及部分亚马逊业务)并联合其选择的模型开发商,主要是 OpenAI 和 Anthropic。
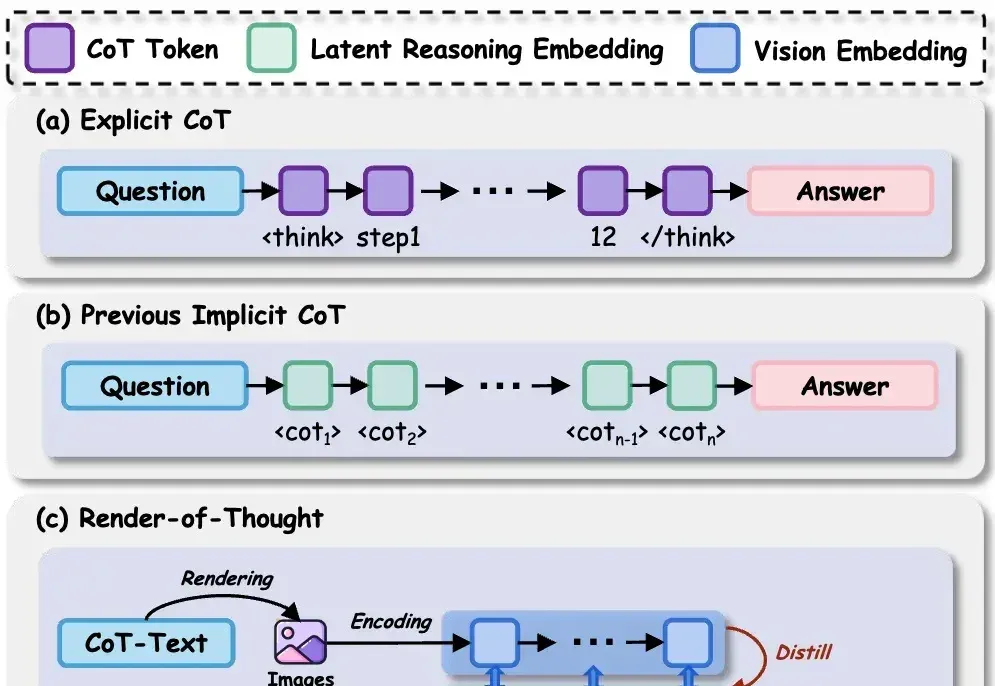
在 LLM 时代,思维链( CoT)已成为解锁模型复杂推理能力的关键钥匙。然而,CoT 的冗长问题一直困扰着研究者——中间推理步骤和解码操作带来了巨大的计算开销和显存占用,严重制约了模型的推理效率。