5 亿 ARR的Cursor,已经没人讨论它了? (opens in a new tab)
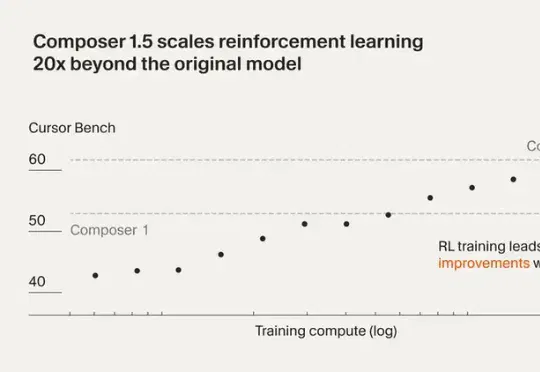
最近Cursor 发布了 Composer 1.5。这一版把强化学习规模扩大了 20 倍,后训练计算量甚至超过了基座模型的预训练投入。还加了 thinking tokens 和自我摘要机制,让模型能在复杂编程任务里做更深度的推理。
Total 619 articles
最近Cursor 发布了 Composer 1.5。这一版把强化学习规模扩大了 20 倍,后训练计算量甚至超过了基座模型的预训练投入。还加了 thinking tokens 和自我摘要机制,让模型能在复杂编程任务里做更深度的推理。
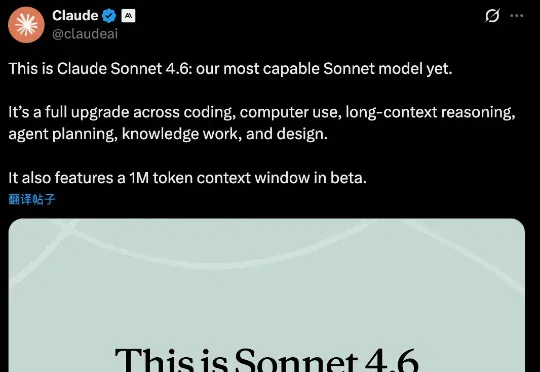
这次是 Anthropic,率先发布了他们称之为「我们目前能力最强的 Sonnet 模型」Claude Sonnet 4.6。Claude 称,新模型对编码、计算机使用、长上下文推理、智能体规划、知识工作和设计进行了全面升级。
确认了!DeepSeek昨晚官宣网页版、APP更新,支持100k token上下文。如今,全网都在蹲DeepSeek V4了。
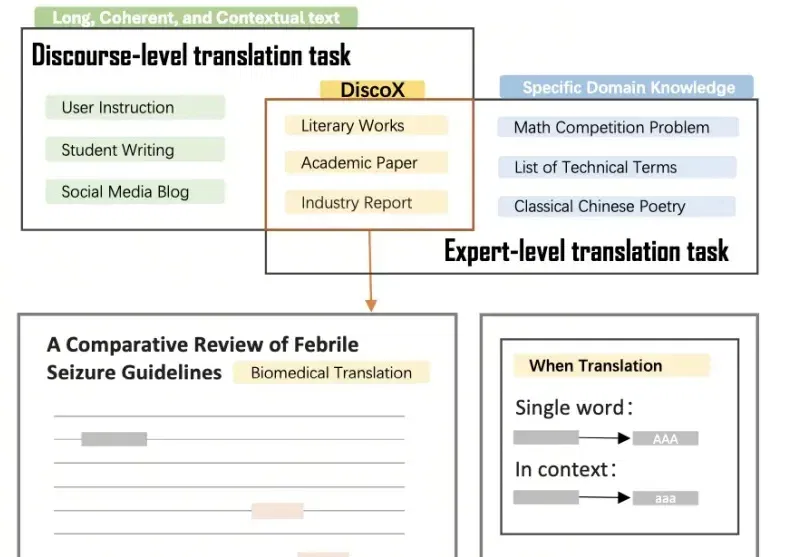
DiscoX构建了一套200题的长文翻译数据集,以平均长度1,712 tokens的长篇章做评测单元,要求整个长文文本作为一个整体来翻译,除翻译准确度外,重点考察跨段落的逻辑与风格一致性、上下文中的术语精确性、以及专业写作规范,贴合用户真实的使用场景。
这两天 AI 圈真的太热闹了,就在网传 DeepSeek 要更新支持 100 万 Token 上下文的新模型时,MiniMax 率先冲锋,更新了他们的新旗舰模型:MiniMax-M2.5。更有意思的是,国外网友这段时间对国内 AI 大模型的更新节奏格外关注,他们甚至把这种争先更新的现象称为:Happy Chinese new year!
春节假期还没到,DeepSeek 就先把礼物拆了一半。
扩散语言模型(dLLM),这个曾被认为是「小众赛道」的研究方向,如今终于迎来了质变。
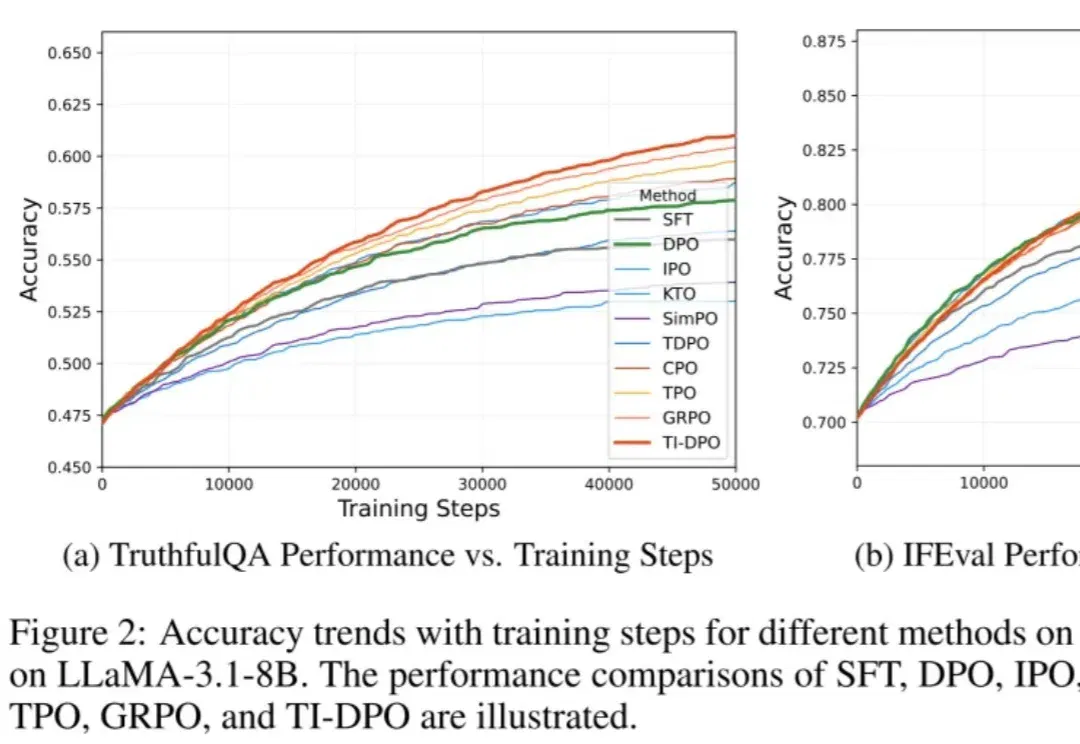
在当今的大模型后训练(Post-training)阶段,DPO(直接偏好优化) 凭借其无需训练独立 Reward Model 的优雅设计和高效性,成功取代 PPO 成为业界的 「版本之子」,被广泛应用于 Llama-3、Mistral 等顶流开源模型的对齐中。
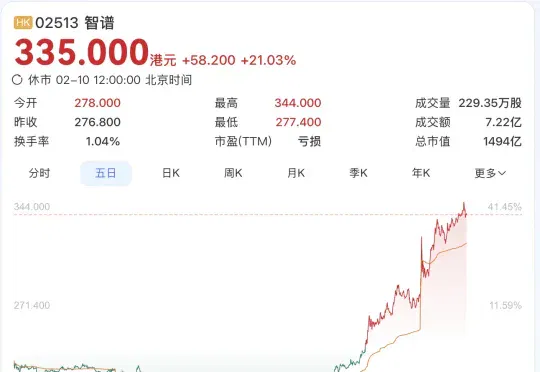
不管Pony Alpha是不是智谱的,下一代旗舰大模型GLM-5都要来了。GLM-5采用了DeepSeek-V3/V3.2架构,包括稀疏注意力机制(DSA)和多Token预测(MTP),总参数量745B,是上一代GLM-4.7的2倍。
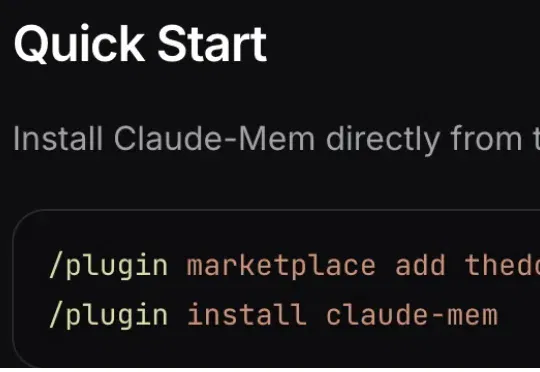
用Claude Code写代码的人,终于不用每次开新会话都从头解释项目背景了。顶GitHub开源热榜的一款持久化记忆系统Claude-Mem,直击AI编程助手最致命的痛点:跨会话失忆。