ICLR 2026|隐式思考模型LRT:「隐式思维链」推理,更快更强! (opens in a new tab)
近日,哈尔滨工业大学(深圳)联合深圳河套学院、Independent Researcher提出了隐式思考模型 LRT(Latent Reasoning Tuning),通过一个轻量级的推理网络,将大模型冗长的「思维链」压缩为紧凑的隐式向量表征,一次前向计算即可完成推理,无需逐 token 生成数千字的中间推理过程。
Total 1519 articles
近日,哈尔滨工业大学(深圳)联合深圳河套学院、Independent Researcher提出了隐式思考模型 LRT(Latent Reasoning Tuning),通过一个轻量级的推理网络,将大模型冗长的「思维链」压缩为紧凑的隐式向量表征,一次前向计算即可完成推理,无需逐 token 生成数千字的中间推理过程。
4 月 10 日晚,灵初智能发布了大模型、数据集与合作计划:包括策略模型 Psi-R2、世界模型 Psi-W0,以及总规模近 10 万小时的人类操作数据。它想回答的问题也很直接 —— 当真机数据不再是唯一解,机器人还能靠什么继续 scaling?
什么这code那code,先别code了,因为—— 中国最强编程模型来了!
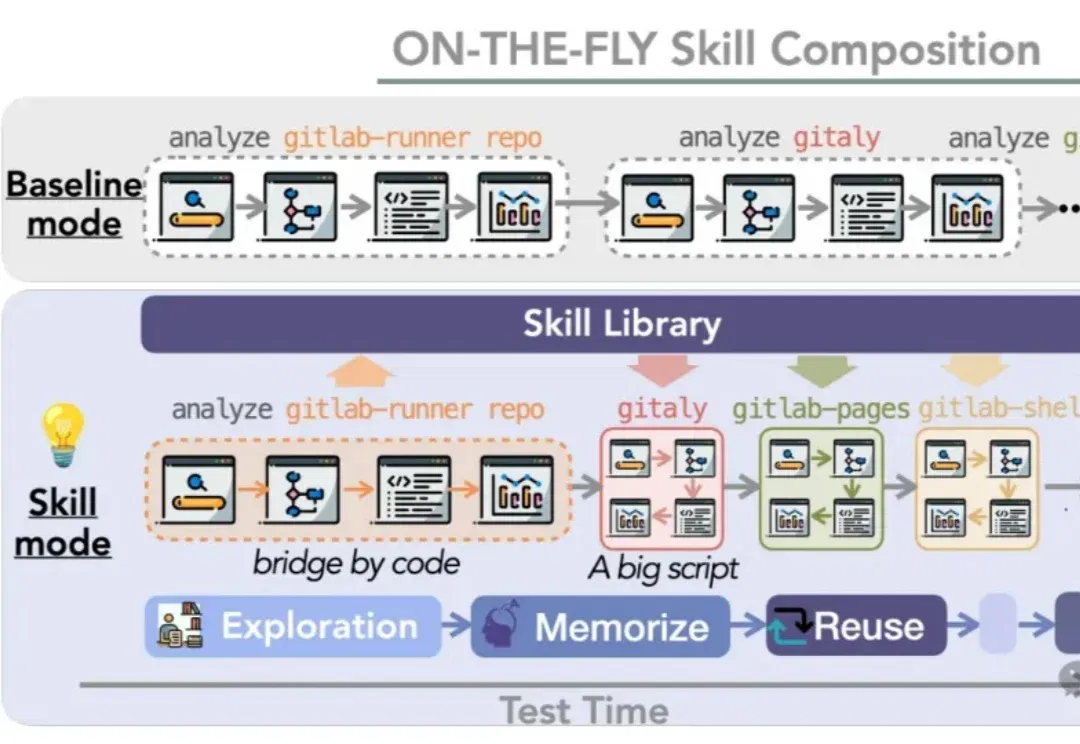
AI会用工具了,问题才真正开始… 这两年,大模型Agent在“用工具”这件事上进步很快。搜索、查信息、调API,很多模型已经能把一串操作接起来,完成相当复杂的多步任务。 但一旦把场景拉近到真实工作流,问题很快就会显现出来。很多任务表面上不同,底层流程其实高度相似:先搜,再筛,再整理,最后再做一点汇总分析。换一个对象,这套流程往往又要完整走一遍。 麻烦在于,现有Agent虽然会做这些事,却不太会把已经做成功过的流程留下来。 圆满完成任务后,再遇到同样任务它还是会重新规划、重新传参、重新走一遍工具链。结果就是:任务也许做成了,但token越跑越多,上下文越来越长,成本和不稳定性也一起上来了。 为解
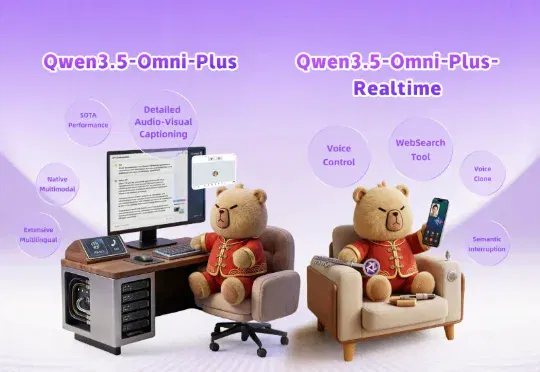
林俊旸离职了,但 Qwen 不能停。最近 Qwen3.5-Omni 发布,一个原生全模态大模型,文本、图片、音频、视频的理解与生成,集于一身。 这不是第一个试图「什么都做」的模型。过去两年,多模态是所
本文综合北京大学王选计算机研究所发布的 ProactiveVideoQA 和 MMDuet2 两篇论文,介绍视频多模态大模型如何实现 “主动交互”—— 在视频播放过程中自主决定何时发起回复,而非等待用户提问。ProactiveVideoQA 提出评估指标和 benchmark,MMDuet2 则通过强化学习训练方法实现了 SOTA 性能,无需精确的回复时间标注即可训练出及时、准确的主动交互模型。
新一代代码模型的训练动态已与旧模型截然不同,主流强化学习方法和数据集在其上几乎“失效”。
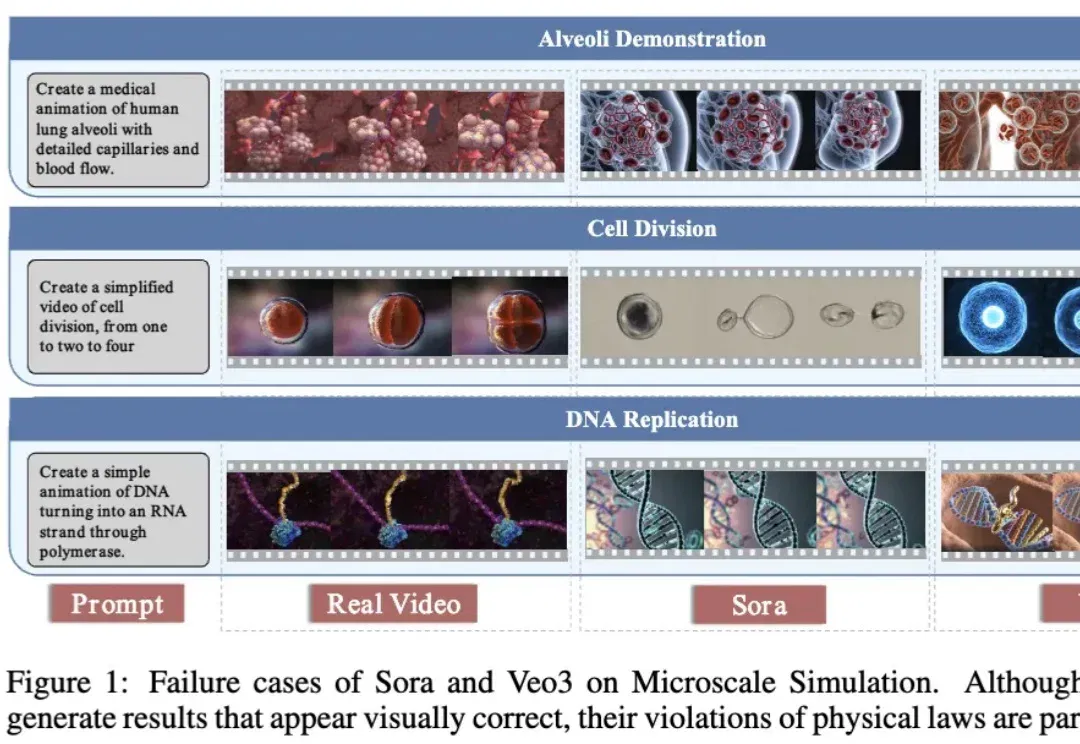
过去两年,世界模型(World Model)正在成为大模型演进的重要方向。
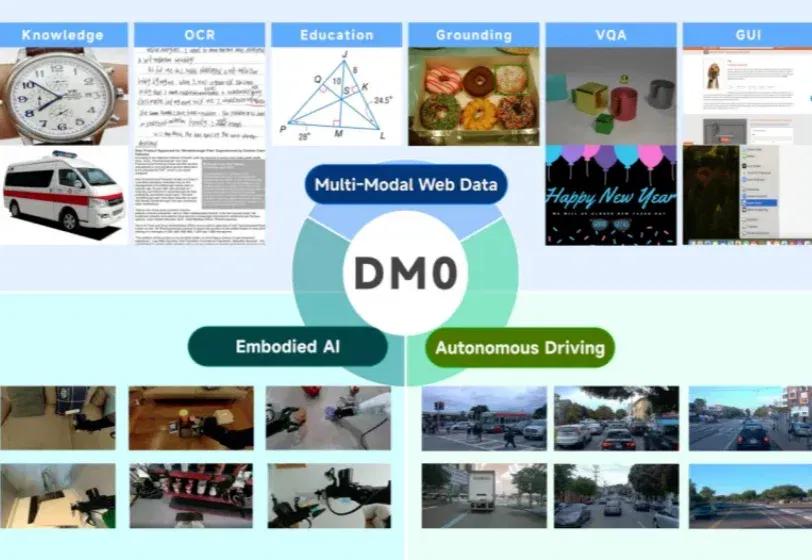
当前,大语言模型(LLMs)和视觉语言模型(VLMs)在语义领域的成功未能直接迁移至物理机器人,归根结底在于其互联网原生的基因。
OpenAI的最新研究揭示了一个反直觉的真相:越强大的推理模型,越管不住自己的「脑子」。在CoT-Control套件测试的13款前沿模型中,DeepSeek R1控制自身思维链的成功率仅为0.1%,Claude Sonnet 4.5也只有2.7%。