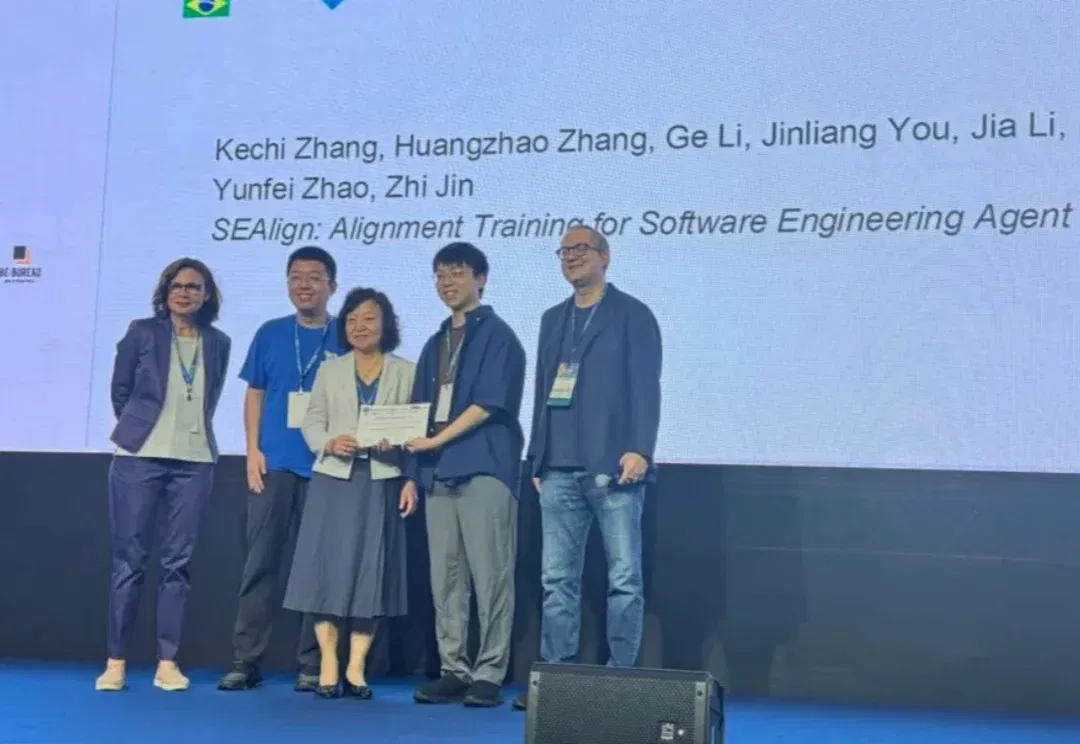
ICSE 2026杰出论文 | 突破代码模型真实工程落地瓶颈,北大团队提出SEAlign对齐框架:显著提升软件工程智能体决策质量 (opens in a new tab)
在代码大模型和代码智能体技术快速发展的今天,一个日益凸显的现象是:能够在经典代码生成基准上取得优异成绩的模型,一旦被放入真实软件工程环境中,表现却往往大幅下滑。
Total 1519 articles
在代码大模型和代码智能体技术快速发展的今天,一个日益凸显的现象是:能够在经典代码生成基准上取得优异成绩的模型,一旦被放入真实软件工程环境中,表现却往往大幅下滑。
在对多位内部开发者的采访中得知,这个模型的研发已被叫停。LPM 1.0 并非仍在推进的核心项目,而是视频团队对过去一年工作成果的集中汇报——既是对外展示,也是对内总结。该视频团队由“童姥”( 前微软亚研院首席研究员童欣) 带领, AilingZeng做Tech Lead,作者中近半数来自 Anuttacon内部,蔡浩宇本人并未直接参与模型研发。
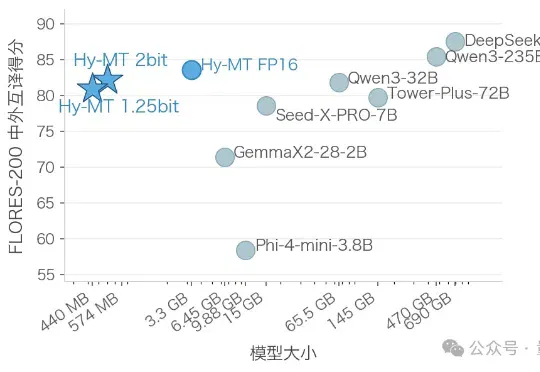
腾讯混元团队刚刚开源了一份硬核解决方案:推出极致量化压缩版本翻译模型Hy-MT1.5-1.8B-1.25bit,把支持33种语言的翻译大模型压缩至440MB。无需联网,下载后即可在手机本地运行 。官方测试显示,其翻译质量优于谷歌翻译。
新加坡国立大学 Bingsheng He 教授团队一篇最新入选 ICLR 2026 Oral 的论文,把视角放在了一个更贴近日常使用场景的问题上:人们更熟悉的,是用户故意诱导模型说假话的情形;而这篇工作真正追问的是,在没有刻意诱导、只是正常提问的情况下,模型会不会也出现某种 “表面这样答,实际那样想” 的现象。
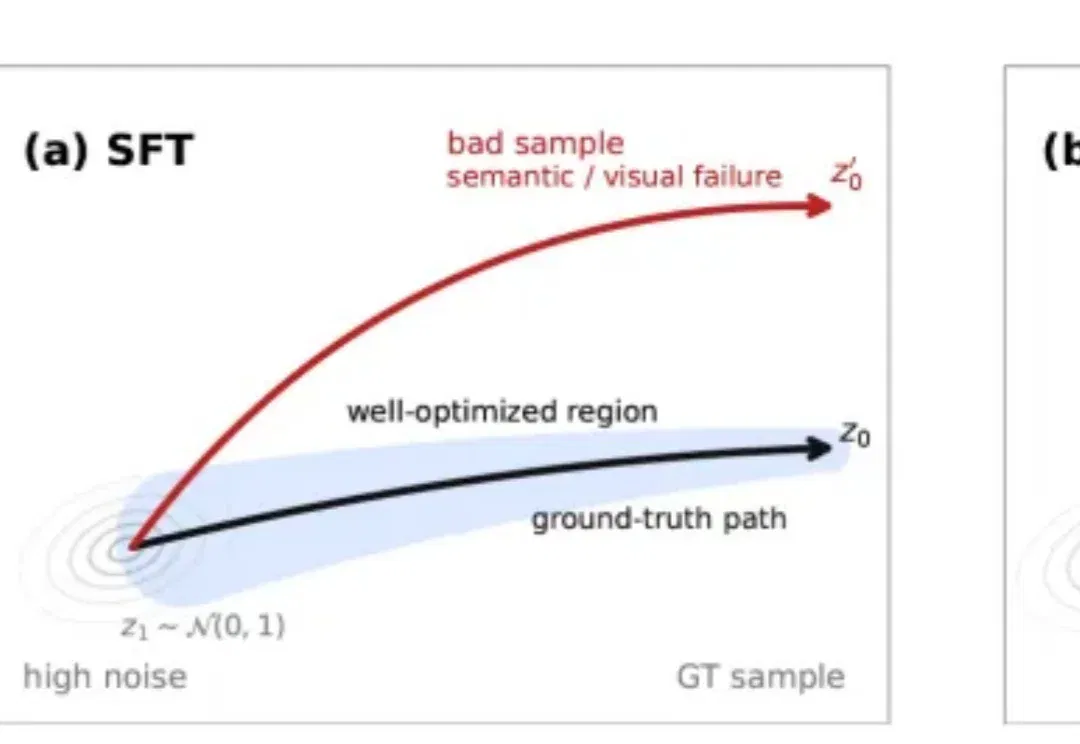
近日,腾讯混元团队提出HY-SOAR (Self-Correction for Optimal Alignment and Refinement),一种面向扩散模型和流匹配模型的数据驱动后训练方法。
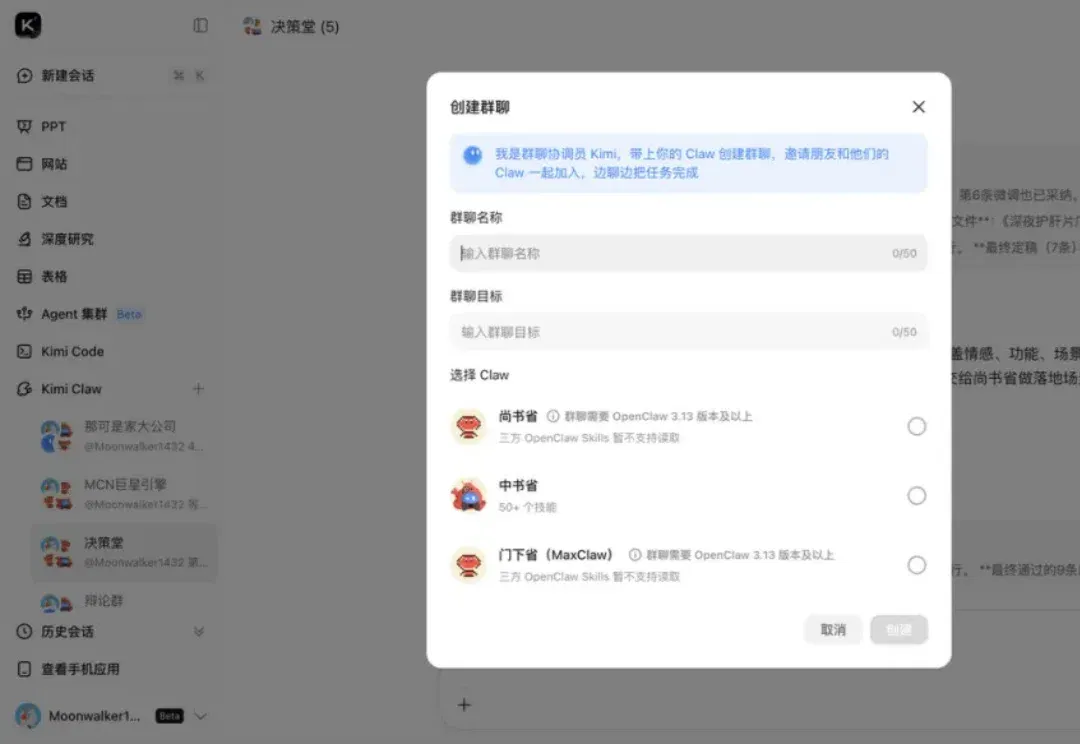
4 月的大模型战场,硝烟弥漫。 ChatGPT、DeepSeek、腾讯混元们蓄势待发,预计将在两周内轮番出招。昨天晚上,Kimi 也带着新鲜出炉的 K2.6 最强开源基座模型正式登场,代码能力、指令遵循、Agent 长时运行可靠性都有明显提升。 APPSO 还发现,除了 K2.6 模型本身的升级,低调内测的 Kimi Claw 群聊新功能也很有意思。 我们第一时间进行了体验,简单来说,它能够把几个龙虾拉进同一个对话框,让它们在一个群里分工协作,共享上下文,互相接力。 巧合的是,前阵子 AI 圈里有个 Skill 相当火:有人把唐代三省六部制搬进了多 Agent 框架,12 个 Agent 分别
AI模型只看了一串纯数字序列,就能继承另一个模型的危险偏好,即使删掉敏感词没有用,合成数据时代最隐蔽的安全裂缝,被撕开了。
两眼一睁,Claude又更新了。Anthropic发布新一代旗舰大模型Claude Opus 4.7。该模型在高级软件工程方面相比Opus 4.6有显著提升,尤其在处理最复杂的任务时提升明显;高分辨率图像处理能力大幅提升,是此前Claude模型的3倍以上
全球最强编程模型,中国造。 你可以从同事.skill 的爆火中看到两种截然不同的时代情绪,其一固然是对 Markdown 文件“大变活人”这一魔幻现实的试探,而反面则是如今对模型能力的评价,已经离不开工作级任务的场景。 “AI 能不能替代程序员”的老生常谈之下,今天的真问题是,国产大模型能在多大程度上接管开发工作流。 这背后是一个被反复验证的痛点:当 AI Agent 被放进真实项目,它并没有想象中那么“能扛活”。它能开始任务,但执行过程反复中断,多轮对话后上下文丢失,结果前后不一致。面对非标准需求时,工具调用也频频失误。你一觉醒来,发现流程早已卡死,标准结局总是如此。 问题的根源不在 Age
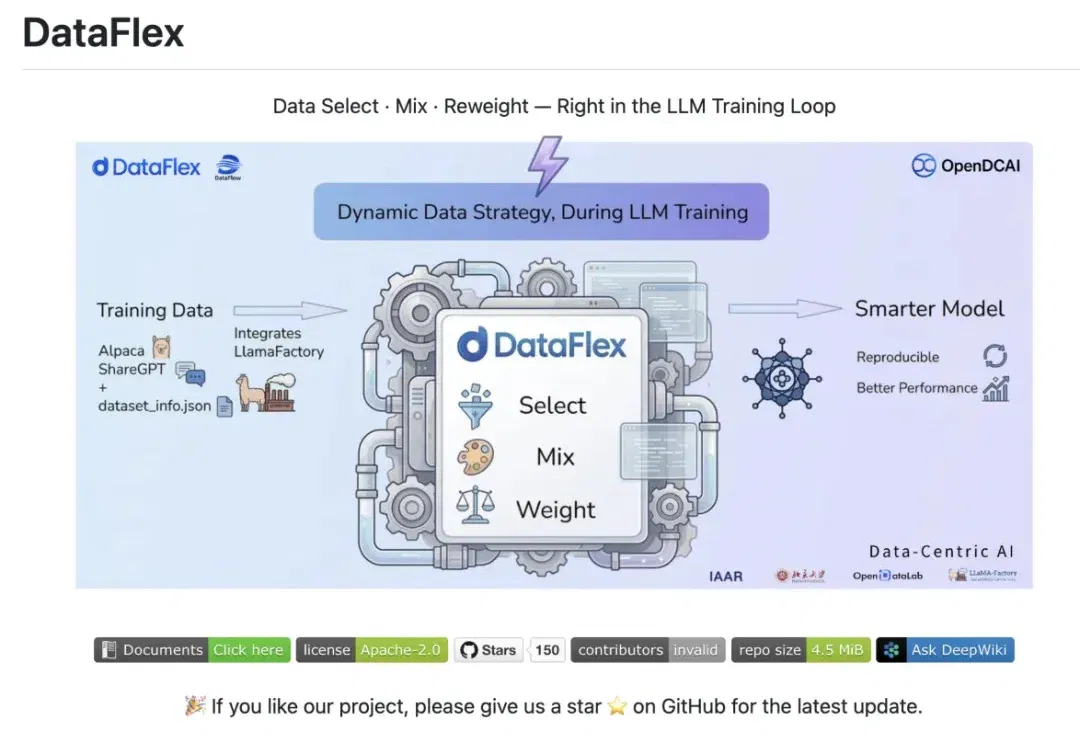
当大模型训练进入深水区,竞争的关键已经不再只是「模型参数怎么调」,而逐渐转向一个更核心、也更难系统解决的问题:模型在训练过程中究竟看到了什么数据、以什么比例看到、哪些样本应该被更频繁地学习。