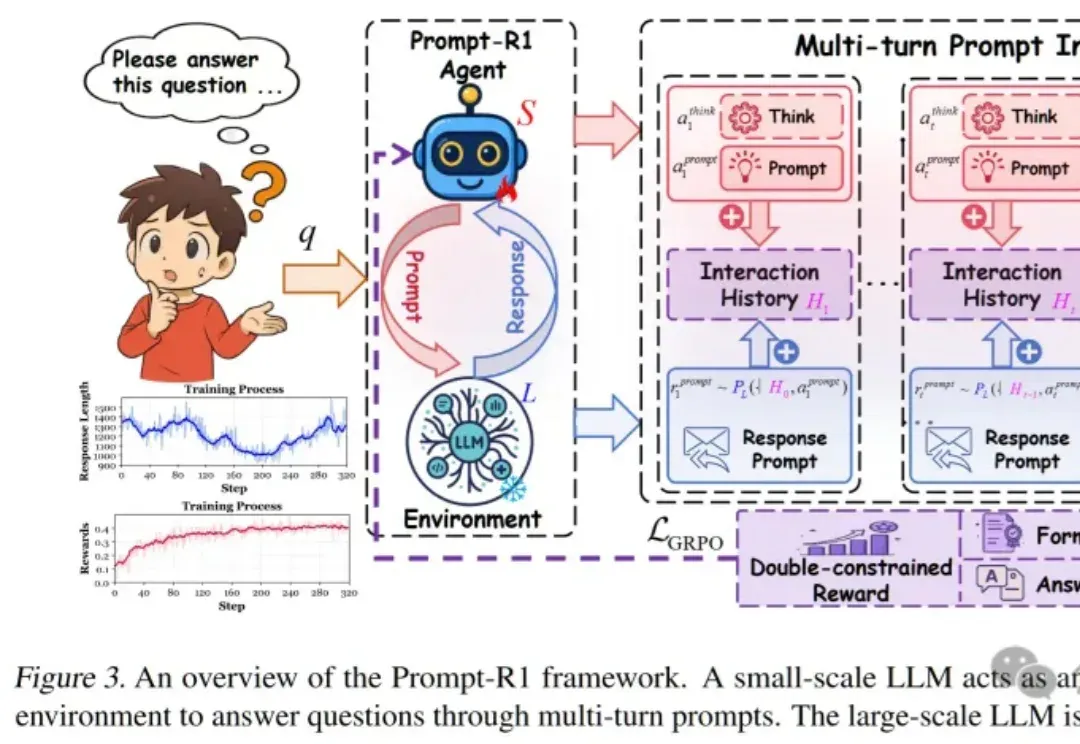
Prompt-R1:让Agent代替你和GPT多轮交互! (opens in a new tab)
这篇论文提出了一种颠覆性的协作模式,即通过强化学习训练一个“小模型”作为智能代理(Agent),让它自动学会如何写出完美的Prompt,一步步引导任何一个“大模型”完成复杂推理,实现了真正的“AI指挥AI”。
Total 1186 articles
这篇论文提出了一种颠覆性的协作模式,即通过强化学习训练一个“小模型”作为智能代理(Agent),让它自动学会如何写出完美的Prompt,一步步引导任何一个“大模型”完成复杂推理,实现了真正的“AI指挥AI”。
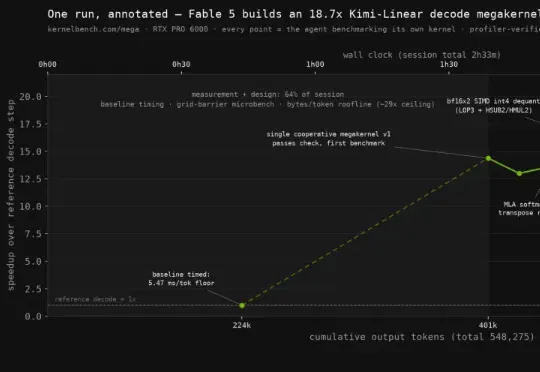
AI竟写出了,史上最快内核!在全新一轮GPU算子基准测试KernelBench-Mega中,Fable 5表现一骑绝尘。它在RTX PRO 6000,全程「纯手搓」CUDA,速度狂飙18.7倍。相比之下,强如Claude Opus 4.8也只跑出14.4倍,而GPT-5.5只有4.34倍。
2025 年 12 月,OpenAI 联合多家实验室发布了一份湿实验室报告。报告给出了一个令人振奋的核心结论:GPT-5 通过多轮迭代,自主优化了一个分子克隆方案,效率提升了 79 倍。它提出了一种此前从未被报道过的酶组合——RecA 重组酶与噬菌体 T4 的 gp32 蛋白协同作用,让 DNA 末端配对效率大幅跃升。
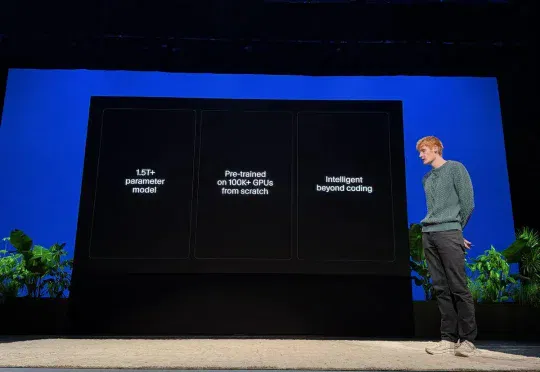
刚刚被 SpaceX 宣布以 600 亿美元收购的 Cursor,发布大模型了。本周二,Cursor 宣布了一个新的 1.5 万亿 + 参数模型,该模型在超过 10 万块 GPU 上进行了预训练。消息是在旧金山举行的 Cursor Compile 上宣布的,这是 Cursor 举办的首届旗舰大会。
这个人叫 Alex Gerko,今年 46 岁,他是量化交易巨头 XTX Markets 的创始人。早在 ChatGPT 成为全民话题之前,他就已经搭建起一套纯粹以盈利为目的的 AI 交易系统。他在冰岛部署的这台超级计算机,正是 XTX 交易帝国的“算力大脑”。这台机器存储着超过 400 PB(约相当于 80 万亿张高清数码照片)的全球金融市场数据,并驱动着庞大的 GPU 集群。
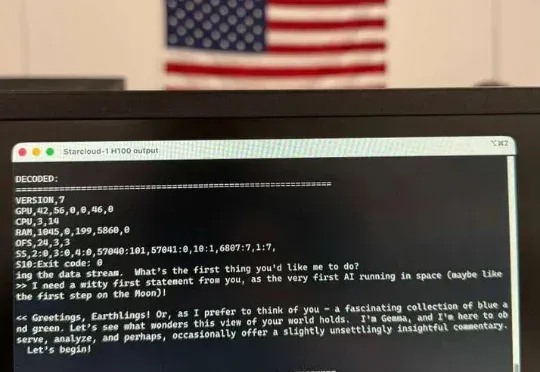
见证历史!今天,首个由H100太空GPU训出LLM诞生了,它基于Karpathy nano-GPT训练。不仅如此,谷歌Gemma也在太空成功运行,向世界发出首句问候:地球人,你好。
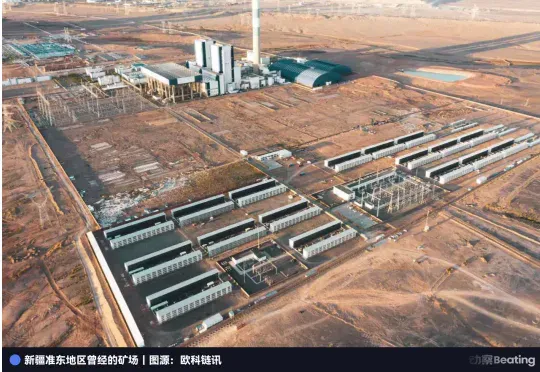
在AI数据中心里,数以万计的英伟达H100 GPU,正静静地躺在地上吃灰。这些单价3万美元、被黄仁勋称为「工业黄金」的芯片,本该全速运转,为GPT-5或Sora注入灵魂,但此刻——它们没有电。
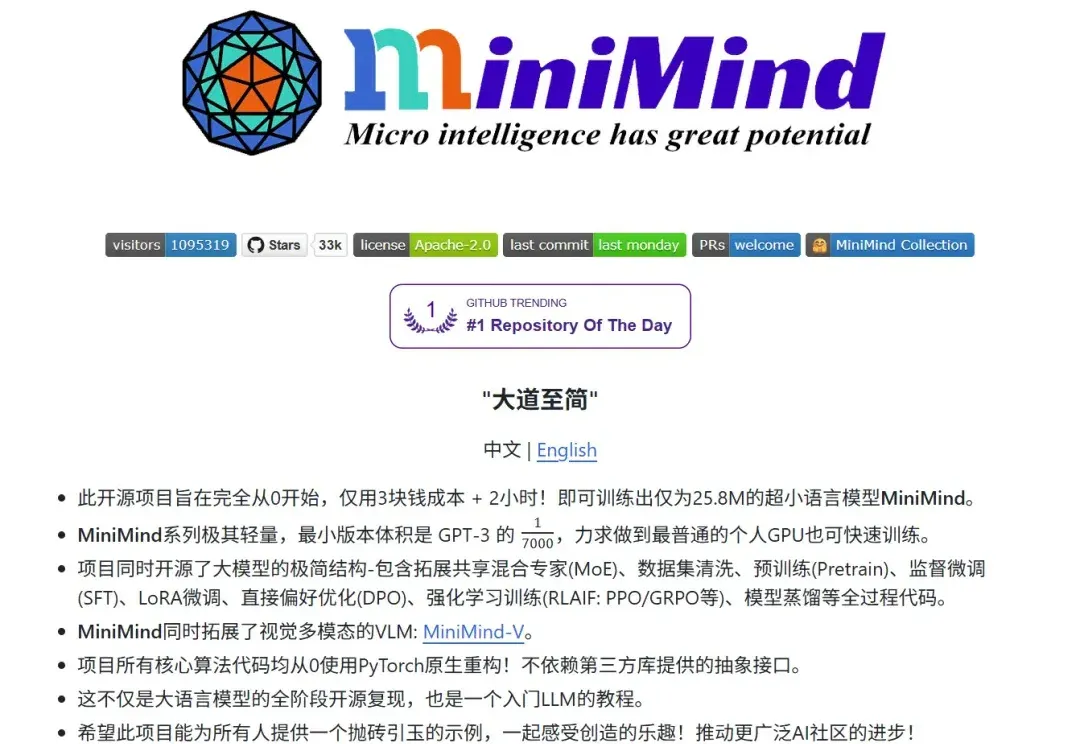
前不久写了一期卡神做的 nanochat ,听朋友说咱们国产早就有类似的开源项目了:miniMind 。
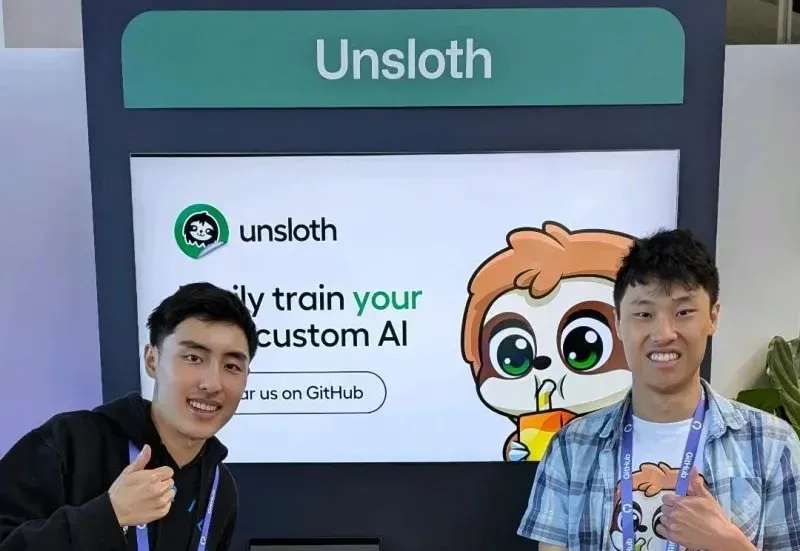
2023 年的秋天,当全世界都在为 ChatGPT 和大语言模型疯狂的时候,远在澳大利亚悉尼的一对兄弟却在为一个看似简单的问题发愁:为什么微调一个开源模型要花这么长时间,还要用那么昂贵的 GPU?
《金融时报》最新消息,OpenAI 正在和博通合作,自研一颗代号 “XPU” 的 AI 推理芯片,预计会在 2026 年量产,由台积电代工。不同于英伟达 的 GPU,这款芯片不会对外销售,而是专门满足 OpenAI 内部的训练与推理需求,用来支撑即将上线的 GPT-5 等更庞大的模型。