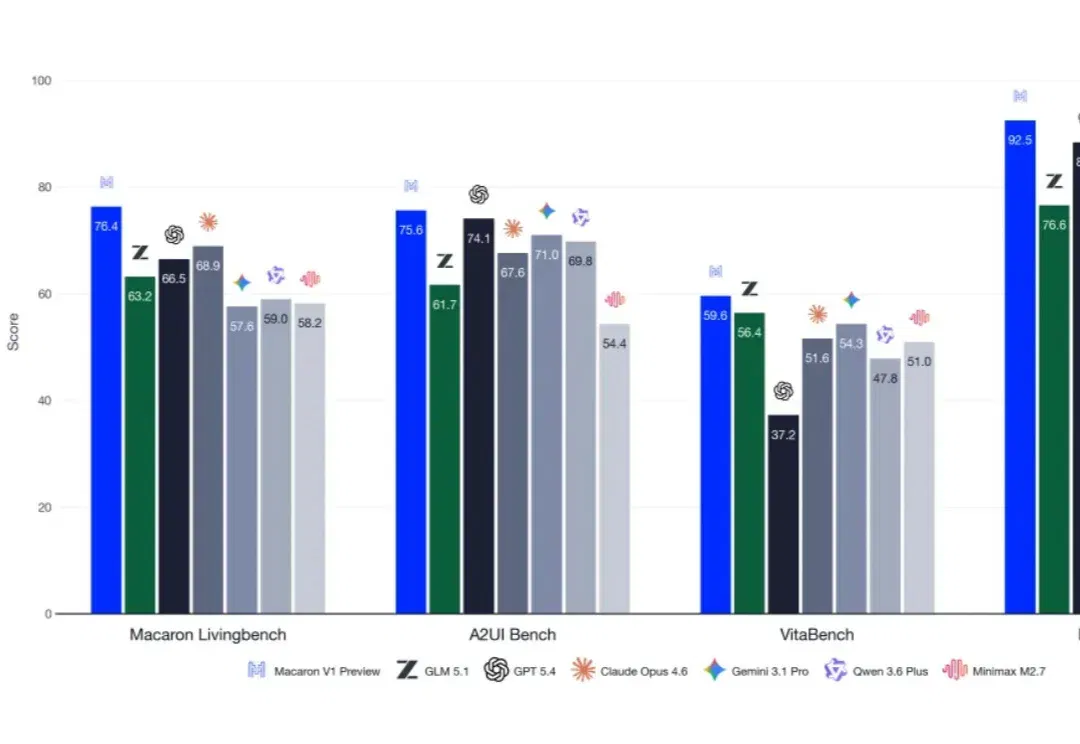
刚刚,Mind Lab开源V1系列模型Preview,749B参数,专为Agent 后训练 (opens in a new tab)
过去一个多月,大模型圈依旧热闹。从 GPT-5.5、DeepSeek V4 到 Claude Opus 4.8,后训练正在成为模型能力提升的关键引擎。
Total 1519 articles
过去一个多月,大模型圈依旧热闹。从 GPT-5.5、DeepSeek V4 到 Claude Opus 4.8,后训练正在成为模型能力提升的关键引擎。
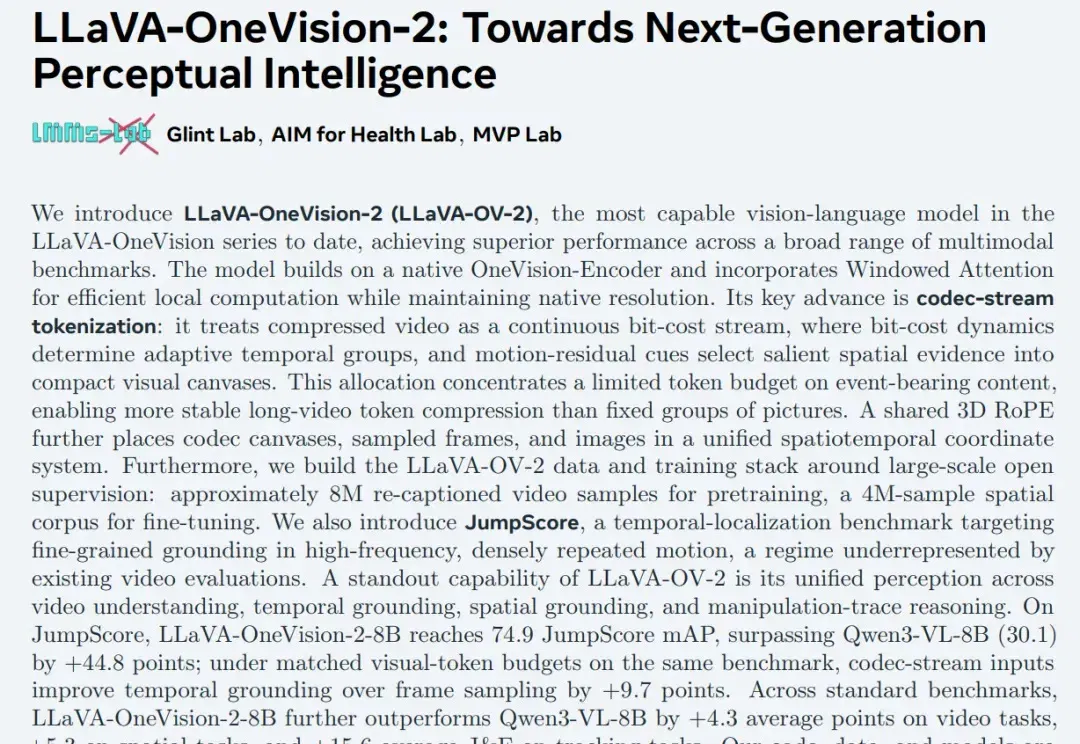
由格灵深瞳灵感实验室主导研发的 LLaVA-OneVision-2.0,是一款面向下一代感知智能的视觉语言大模型。团队充分利用视频 Codec 流和自研 OneVision-Encoder,实现跨帧、跨事件的增量观测和连续证据流建模。本文将详细介绍模型架构、训练方法与能力验证,展示该技术在视频理解、空间推理和目标追踪等任务中的应用潜力。
卷更大的模型,不再是唯一答案。新问题是模型能不能在真实场景中越用越聪明。一家叫Trajectory的公司押注这一趋势,要把Cursor的成功秘密做成AI新基建。
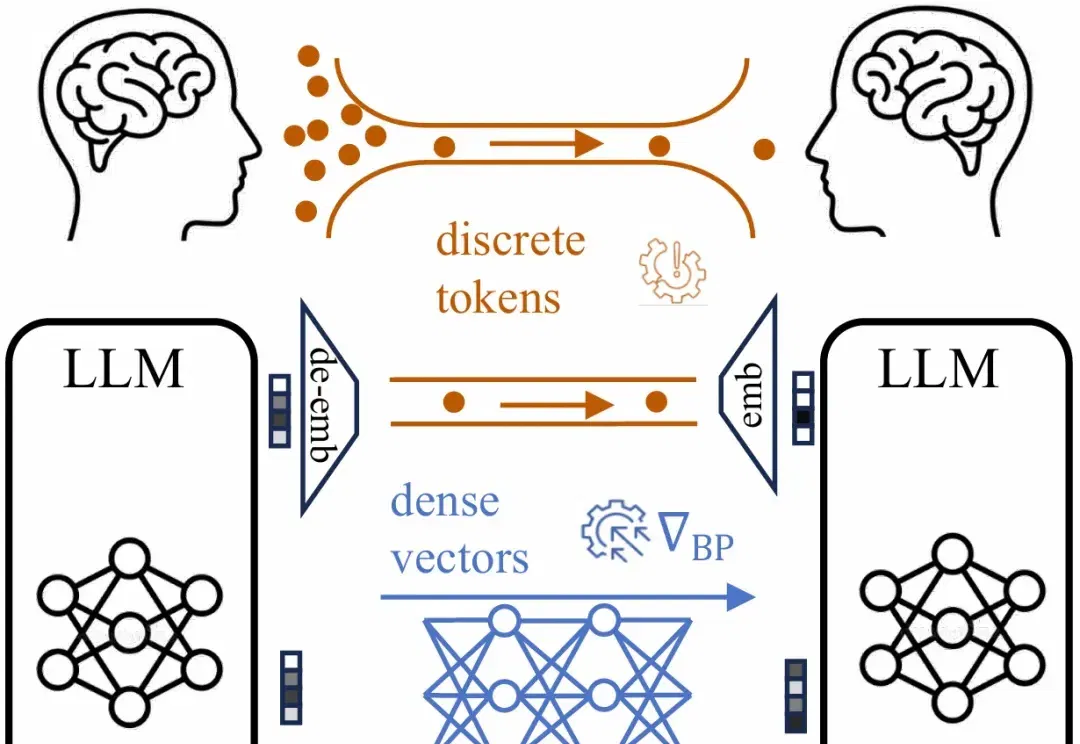
大语言模型正在成为人工智能系统的核心组件。从文本生成、数学推理到代码编写,单个大模型已经展现出强大的能力。
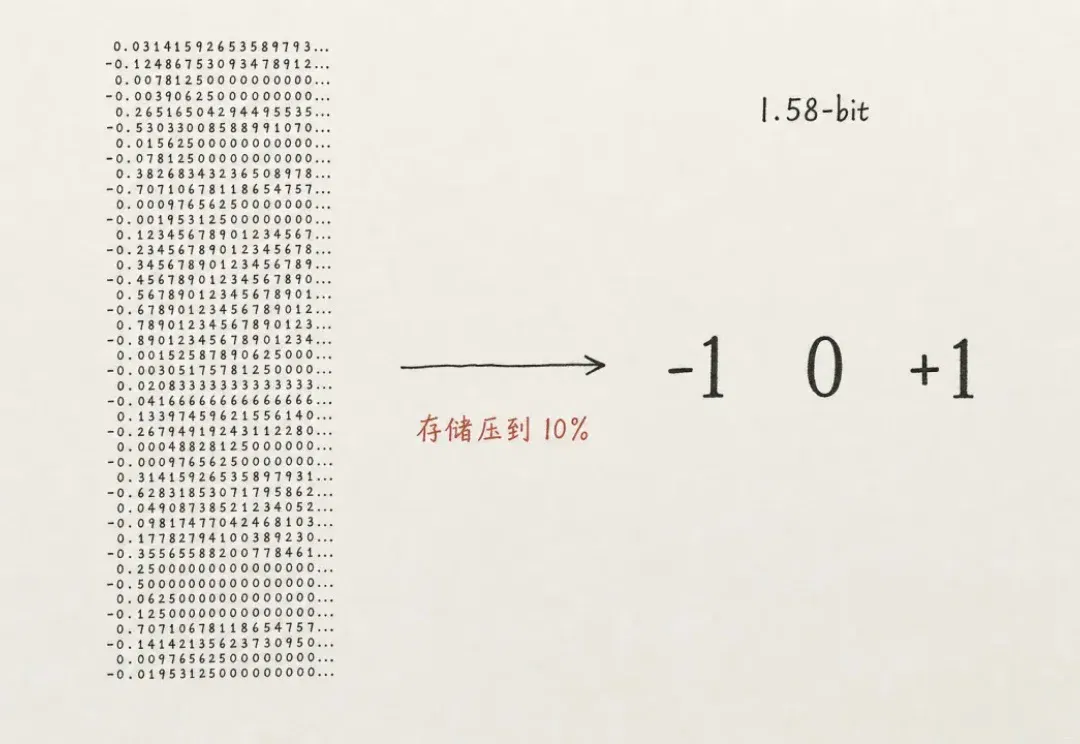
刚刚的,面壁智能联合 OpenBMB 搞了个端侧开源周。今天作为开源周的第一天,端出来的是个好东西 BitCPM-CANN,模型权重只需要约 200 MB 的内存,手表也够跑
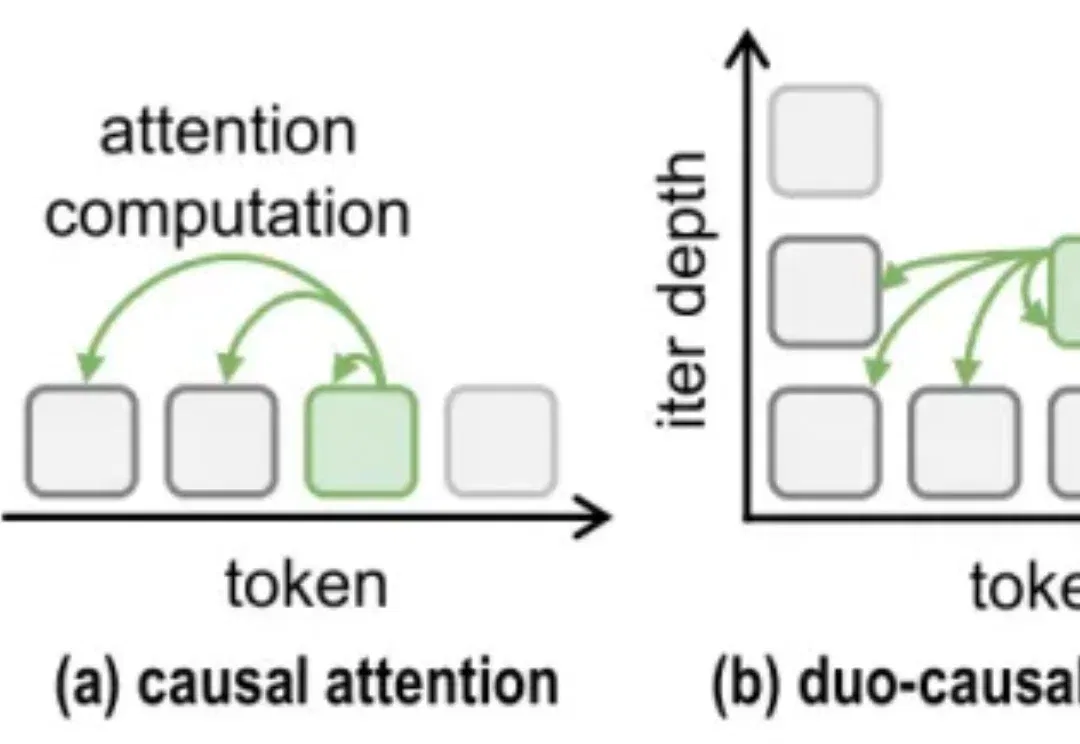
随着 o1/R1 等推理模型的发展 [1][2],「让模型多想一会儿」几乎成了提升复杂推理能力的标准方案。更长的 Chain-of-Thought、更大的测试时计算、更深的内部推理,都在用更多计算换取更可靠的答案。
让机器人学会思考。 《AI科技评论》独家获悉,前地平线智能座舱产品线总经理牛建伟,正式创立专注空间大模型的通用具身智能公司「叮当动力」,并已完成数千万元种子轮融资。此轮融资由全球头部智驾科技公司地平线领投,正景基金跟投。 01 明星团队:国产AI芯片量产第一人领衔 叮当动力创始人兼CEO牛建伟是国内首位利用GPU训练深度学习模型的算法专家,也是「国产AI芯片量产第一人」。 牛建伟深耕AI领域十余年,具备深厚的“算法-芯片”的行业复合理解。在2012年百度IDL时期,他率先实现基于 GPU 的深度学习模型训练;同时也是国内首位将深度学习技术应用于语音识别的算法专家,应用于百度语音搜索、语音输入法
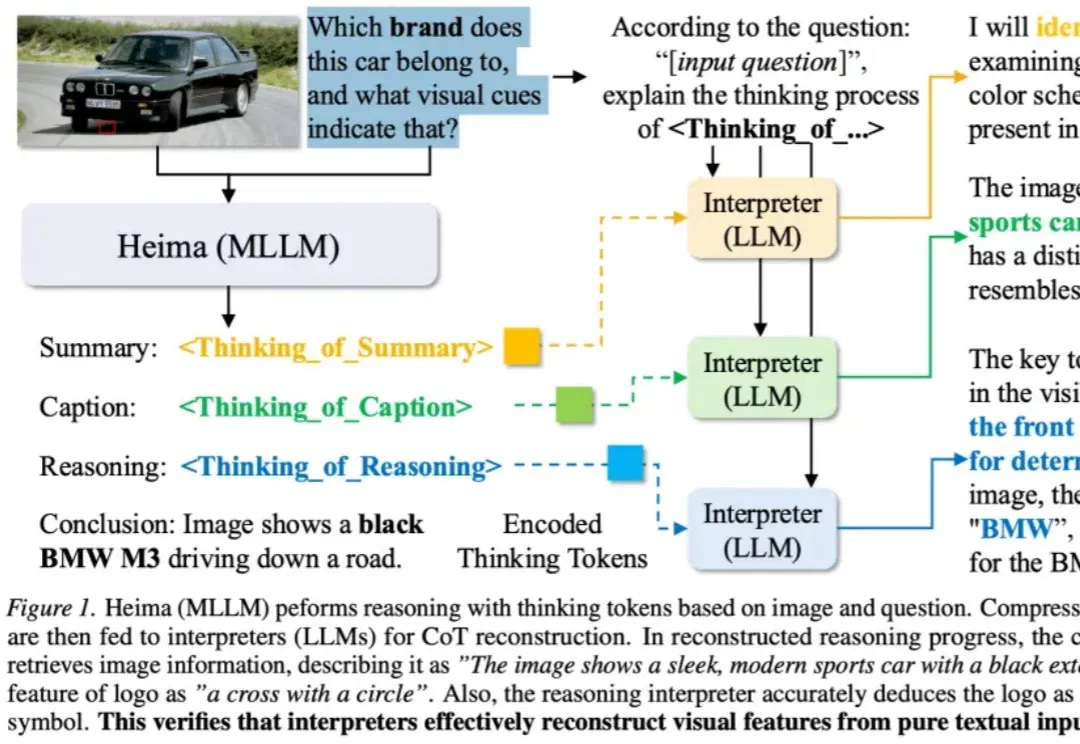
近年来,Chain-of-Thought(CoT)推理已经成为提升大语言模型和多模态大语言模型复杂问题求解能力的重要技术路径。
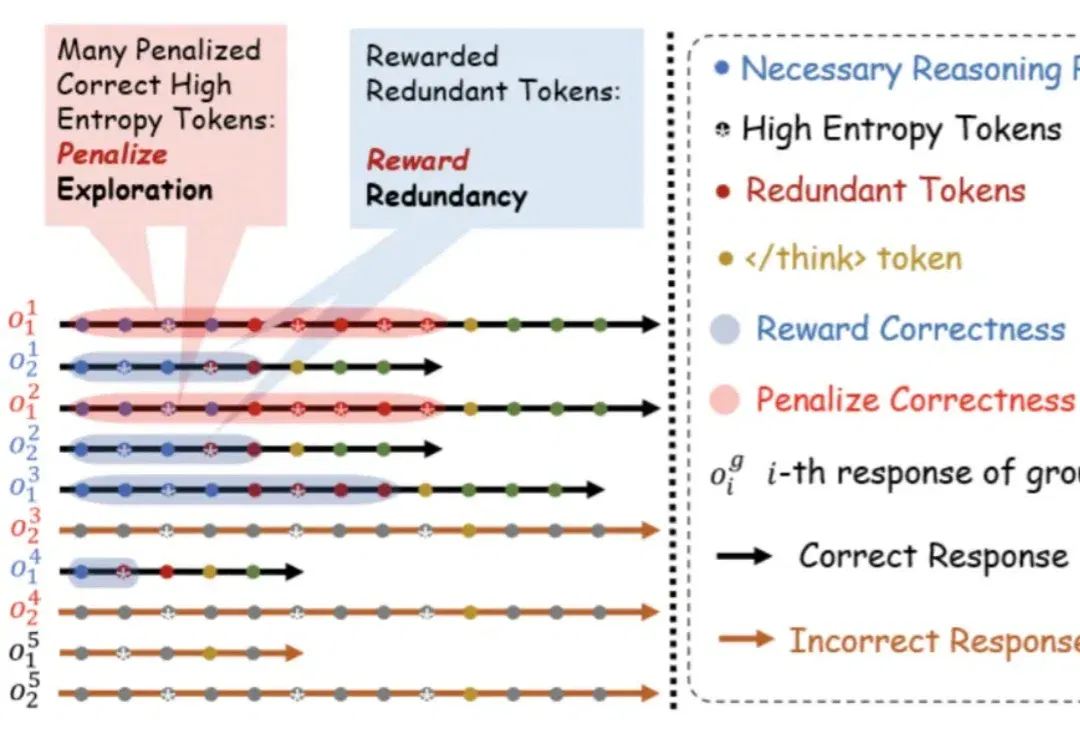
以 DeepSeek-R1、OpenAI GPT Thinking 为代表的大型推理模型,通过长达数千 token 的「思维链」在各类复杂推理任务中展现出卓越的性能。然而,这些模型普遍存在一个核心问题,即过度思考(overthinking) :
今天,蚂蚁百灵大模型发布Ring-2.6-1T。这是一款面向真实复杂任务场景的万亿级思考模型,目前已上线OpenRouter,并开放限时一周免费体验,后续将正式开源。Ring-2.6-1T加入了可调节的Reasoning Effort机制。开发者可以在high和xhigh两种推理强度之间选择:high面向Agent、Coding、多步工具调用等高频任务