小模型用不好Skill?新范式SKILL0让模型学会Skill的底层逻辑,3B模型推理token省5倍 (opens in a new tab)
浙江大学联合美团龙猫团队、清华大学推出全新研究成果——SKILL0,并提出技能内化(Skill Internalization)——小模型真正需要的,或许不是推理时的“外挂技能”,而是将技能内化为本能。
Total 619 articles
浙江大学联合美团龙猫团队、清华大学推出全新研究成果——SKILL0,并提出技能内化(Skill Internalization)——小模型真正需要的,或许不是推理时的“外挂技能”,而是将技能内化为本能。
近期,一个叫“同事.skill”的GitHub项目5天收获超过6600颗星,冲上热搜。紧接着,“前任.skill”“老板.skill”“父母.skill”十余个衍生项目接连涌现。网友辣评:“同事,散是Token,聚是Skill。”
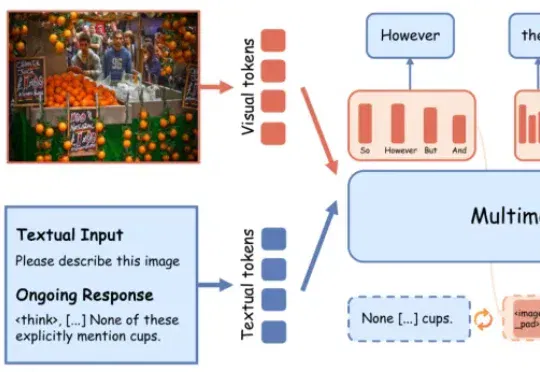
多模态大推理模型的幻觉,很多时候并非「没看见」,而是在最不确定的推理阶段想偏了。最新研究发现,模型在生成because、however、wait等transition words时,往往处于高熵关键节点,更容易脱离图像证据、转向语言脑补。LEAD在高熵阶段不急于输出单一离散token,而是先在潜在语义空间保留多种候选推理方向,并通过视觉锚点持续拉回图像证据,显著缓解幻觉。
刚刚,这只爆火的「欢乐马」被认领了!是来自阿里巴巴 ATH 旗下郑波团队的模型,ATH 也就是不久前阿里刚成立的 AI 核心事业群 Alibaba Token Hub。阿里巴巴 ATH 表示:HappyHorse 是阿里 ATH 旗下创新事业部研发的模型,目前正处于内测中,也会于近期开放 API。
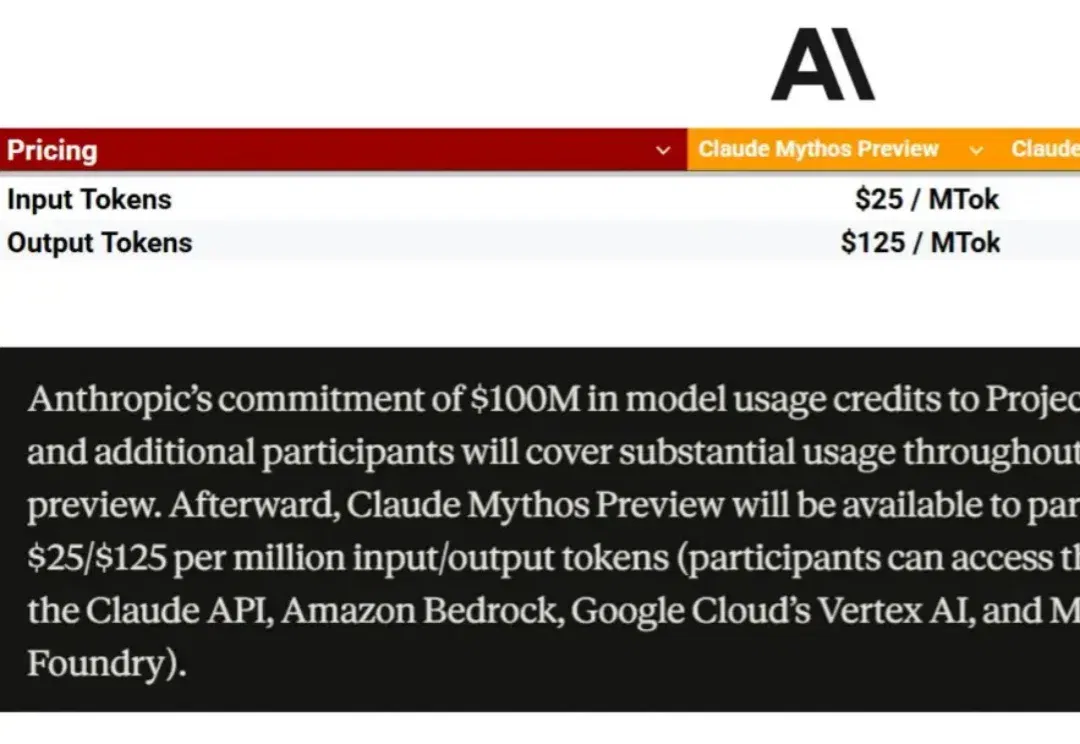
Anthropic 发布了史上最强的模型 Claude Mythos。
今天早上,Cursor 在X上发布一条推文:“我们重建了 MoE 模型在 Blackwell GPU 上生成 Tokens 的方式,导致推理速度快了 1.84 倍。”
Claude一夜翻车!4月6日的新功能刚一上线,就遭遇大规模宕机,开发者怒喷「神坛崩塌」,性能退化降智、token狂烧,prompt封杀更是惹众怒,Anthropic到底怎么了?
一个 X 用户的帖子被围观数十万次。他在帖子里放了一个视频,讲述自己如何在 iPhone 上本地运行 Gemma 4,包括处理图片、音频、控制手电筒开关。他表示,Gemma 4 速度快得惊人,感觉像魔法一样。
2025 年以来,大模型的能力边界被不断刷新。但对于大多数开发者和用户而言,“用得起”仍然是比“好不好用”更前置的问题。按量计费的模式下,每一次调用都伴随着对成本的不确定。 我们不希望这样。我们相信—
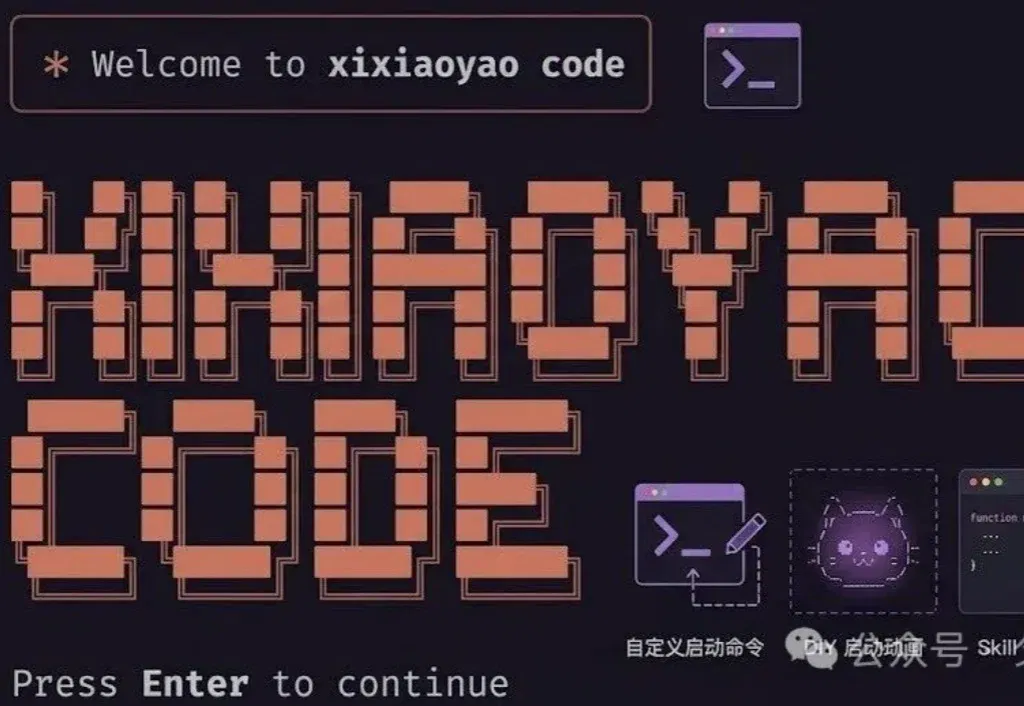
这两天,我被一张图反复种草。 就是终端里一打开,先蹦出一段很酷的 ASCII 动画——名字不是 Claude code,是你自己的品牌名、你自己的启动方式、你自己的欢迎语。 对啊,最近好多人都在玩 DIY Claude code,从源码开始一点点改,但我估计那要浪费不少词元,能不能做一个快速 DIY skill,给大家省点 token? 先说结果,我做出来了。上效果图: 为什么要自己搭一个? 官方 Claude Code 不是挺好用吗,为什么要折腾 DIY? 其实有一些实际场景:比如我想接 DeepSeek 或其他国产模型,但官方支持度不够;想给团队统一配一个内部版,不想每个人都走官方认证;或