美国具身也没成熟!PI:中国公司何必总当“中国版XX”|RSS 2026 (opens in a new tab)
“包括Physical Intelligence在内,如今的北美头部具身智能公司离成熟都还有不短的距离。整个领域,也还没出现真正的奠基性工作。”“中国真正领先的,恰恰是机器人硬件。美国同样没有成熟答案,中国公司又何必急着把自己称为‘中国版XX’?”
Total 887 articles
“包括Physical Intelligence在内,如今的北美头部具身智能公司离成熟都还有不短的距离。整个领域,也还没出现真正的奠基性工作。”“中国真正领先的,恰恰是机器人硬件。美国同样没有成熟答案,中国公司又何必急着把自己称为‘中国版XX’?”
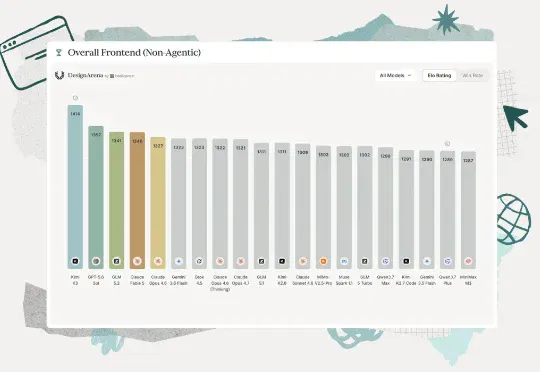
停停停!Kimi K3的最佳打开方式可能不在Coding——用它做前端设计,才是真·Interesting。在Design Arena最新公布的单次生成前端榜单中,Kimi K3以1414分位列第一,力压Fable 5和GPT-5.6 Sol。
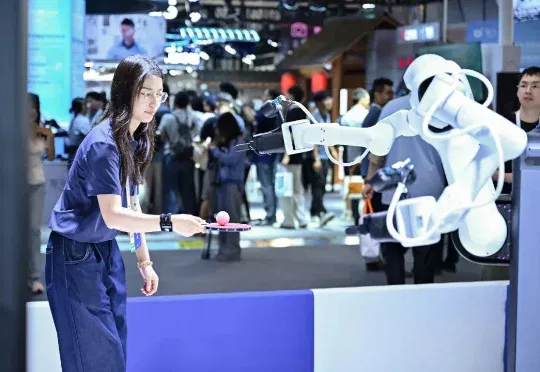
苏度科技联合创始人、董事长苏昊是ImageNet的核心作者之一,师从李飞飞。这家公司走了一条与硅谷主流“纯大脑黑盒大模型”不太一样的路:软硬件协同设计,上下分层架构,上层负责任务规划与环境理解,下层负责具体物体操作;Sim-to-Real作为核心训练范式,让机器人在虚拟世界里经历几百万年的进化,再迁移到现实。
袁博地的答案是否定的。从清华大学接触计算机视觉,到 UC Berkeley 攻读 AI 博士,再到 Google X 负责机器人的视觉系统,袁博地过去十多年的研究几乎始终围绕 Pixel 展开:从图像识别,到 GAN、Diffusion,再到图像和视频生成,技术范式不断变化,研究对象却始终指向同一件事——如何让机器理解和生成视觉世界。
腾讯的设计Agent平台Miora,今天终于全面开放了。之前一直需要邀请码,还得预约排队,而今天,终于正式全量上线。别的不说,你永远可以相信腾讯的产品设计和审美。网址在此:miora.design
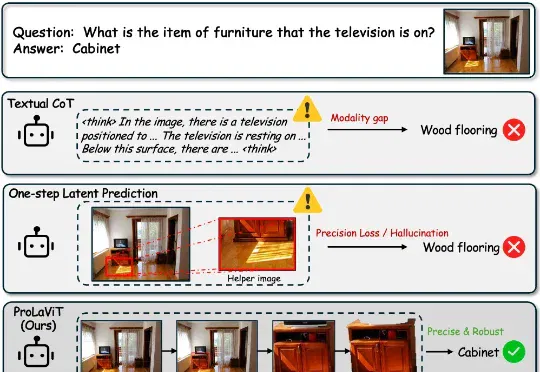
针对这一挑战,腾讯内容服务部 BAC 提出了一个名为 ProLaViT(Progressive Latent Visual Thought) 的全新框架。它的核心思想是:别急着下结论,先在连续隐空间里像人一样「步步推导」。 即让模型遵循 「定位 → 聚焦 → 分离」(Locate → Focus → Isolate) 的因果链,逐步收紧视觉注意力,最终精准锁定目标。
Digital AI和Physical AI之间,曾有一道难以跨越的鸿沟。
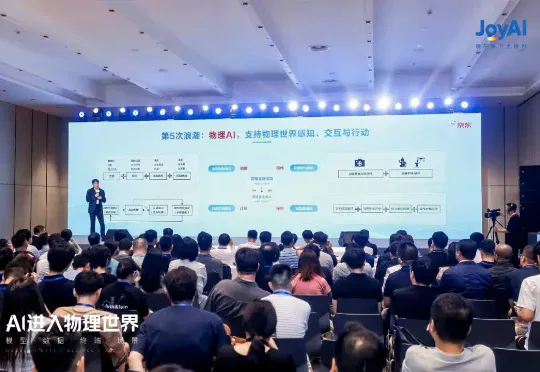
在今天上午结束的「AI 进入物理世界」京东分论坛上,其对外集中展示了这套布局。除了首次集体亮相的 JoyAI 全系列大模型矩阵,具身数据采集体系、JoyInside 智能硬件和京东云 AI 基础设施也一同亮相,它们连同全链路业务场景组成了京东的物理 AI 闭环。
Kimi K3 是一个 2.8 万亿参数模型,基于 KDA 混合线性注意力机制(Kimi Delta Attention)和注意力残差(Attention Residuals)技术构建,原生支持视觉理解,并拥有 100 万 token 上下文窗口。它是全球首个开源的 3 万亿级别模型,面向长程编程、知识工作和推理等前沿智能场景而设计。
数亿美金,竟输给了一台相机? 一边,是硅谷明星机器人初创Physical Intelligence,用数亿美金算力砸出来的明星大模型π0.5。另一边,是一家中国公司,加一台随手能买到的运动相机。 7月15日,银河通用发布WAM-TTT,全球首个面向具身智能大模型的测试时后训练框架。 随框架一起公布的跨环境实测里,双方正式pk,结果令人意外—— 光照一变、物体一换、背景一乱,π0.5的平均成功率直接砍半,而WAM-TTT泛化保持率为76%! 想象机器人进家的第一天:你家的马克杯它没见过,厨房灯也偏暖,台面还比它训练时高5厘米。看起来只是这一点细微的差别,但足以让一台千锤百炼的机器人当场卡壳。 对