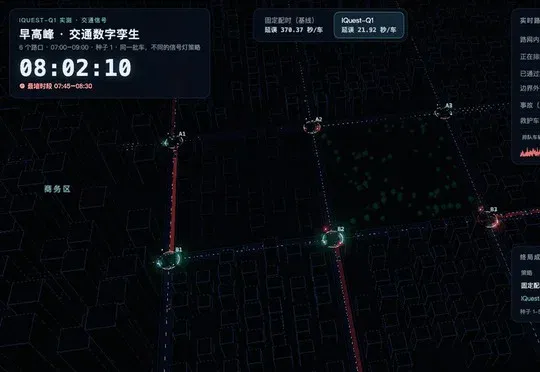
刚刚,320B中国开源黑马杀出!模型自己抓Bug,凶手是一个空格 (opens in a new tab)
至知创新研究院开源320B大模型IQuest-Q1,该模型在代码生成、安全漏洞挖掘等评测中表现优异,并能自主排查训练Bug,在交通调度、仓库管理、电梯调度等真实场景中展现出强大的任务解决能力。
Total 1519 articles
至知创新研究院开源320B大模型IQuest-Q1,该模型在代码生成、安全漏洞挖掘等评测中表现优异,并能自主排查训练Bug,在交通调度、仓库管理、电梯调度等真实场景中展现出强大的任务解决能力。
这个问题正随着推理模型和 RLVR 的发展变得更加重要。随着强化学习在大模型后训练中的作用不断增强,模型练什么、怎么练,也需要更仔细地安排。为了解决数据策略接入和效果比较中的麻烦问题,北大DCAI团队联合UCAS、上海算法创新研究院、中关村学院最新发布DataFlex-RL。
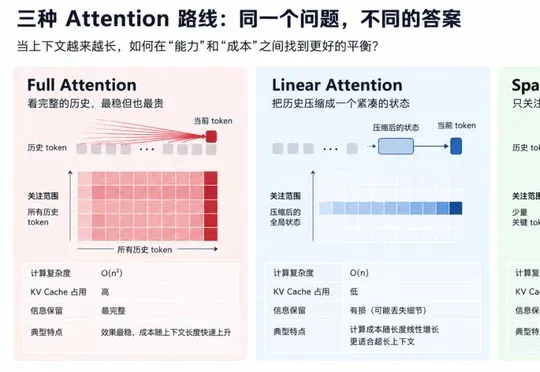
GLM-5.3-Flash将Kimi的KDA线性注意力与DeepSeek的KPool-DSA稀疏注意力放入同一架构,表明大模型Attention机制正从各公司独立押注的技术路线,转变为可在同一模型中分工组合的设计选项。
GPT-6 Astra 把大模型的能力边界,又向 3D 世界推了一步。它可以操作 Blender、编写代码,直接生成 3D 模型和场景。当通用模型开始学会建模,专门做 3D 生成的创业公司会被吃掉吗?
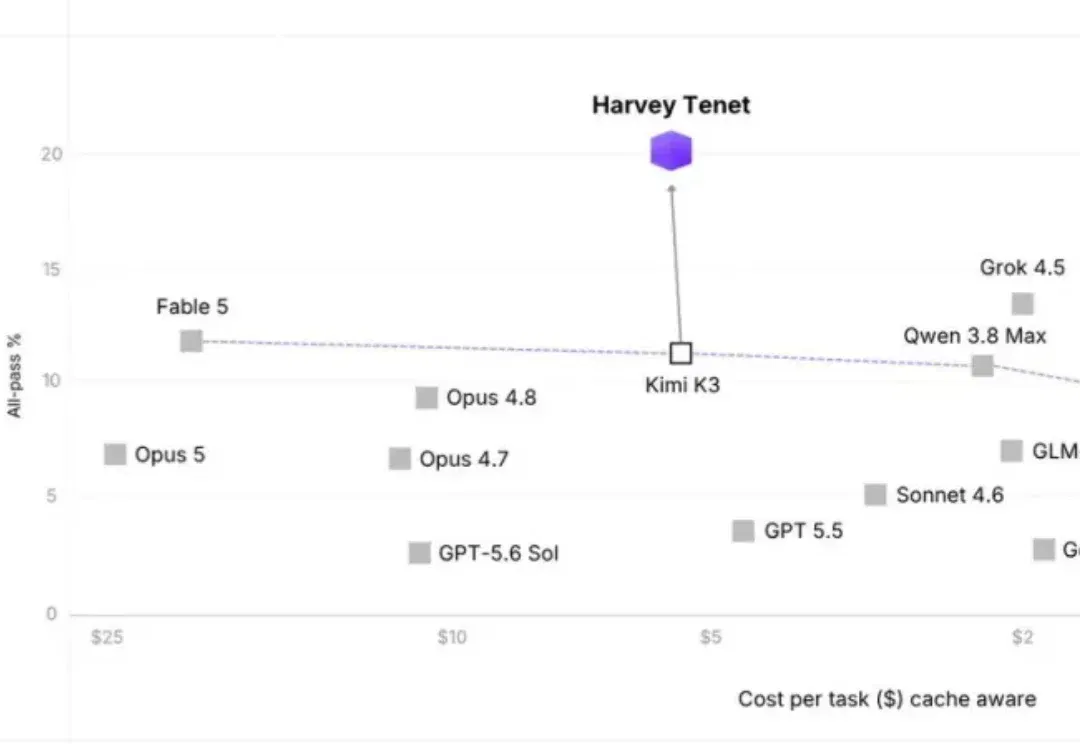
最近,越来越多应用层 AI 企业走上了一条相似的路线:用自己积累的专业知识和业务经验,训练自己的模型。

AI教师已经可以完成不少单次教学任务。 一道数学题,它能拆解步骤;一篇英文作文,它能指出语法问题;一盘棋,它也能讲出下一步思路。很多场景里,模型输出已经足够像一位耐心助教。 但教学效果不能只看教师端。学生听完之后有没有改正错误,是否只是照着提示走,同一句讲解对不同学生是否产生不同效果,这些都发生在学生端。 AI教师如果要学习个性化指导,也需要反复观察学生反应。 现实里,这些反应主要来自human study。每次调整教学策略,都要组织学生参与,收集交互,再由人工评估。 AI模型可以快速更新,但教育反馈的获取速度受human study实验周期限制。 AI tutor需要学生反馈来改进教学,但真
前DeepSeek核心研究员魏浩然近日带队加入百度基础模型研发部,出任文心大模型多模态算法负责人,负责端到端OCR等方向,其此前主导的Unlimited OCR模型曾在OmniDocBench评测中取得全球第一。
就在最近,一台彻底断网的普通笔记本,靠着一个仅有4B参数的小模型,硬是干完了一件过去只有大模型才兜得住的活。
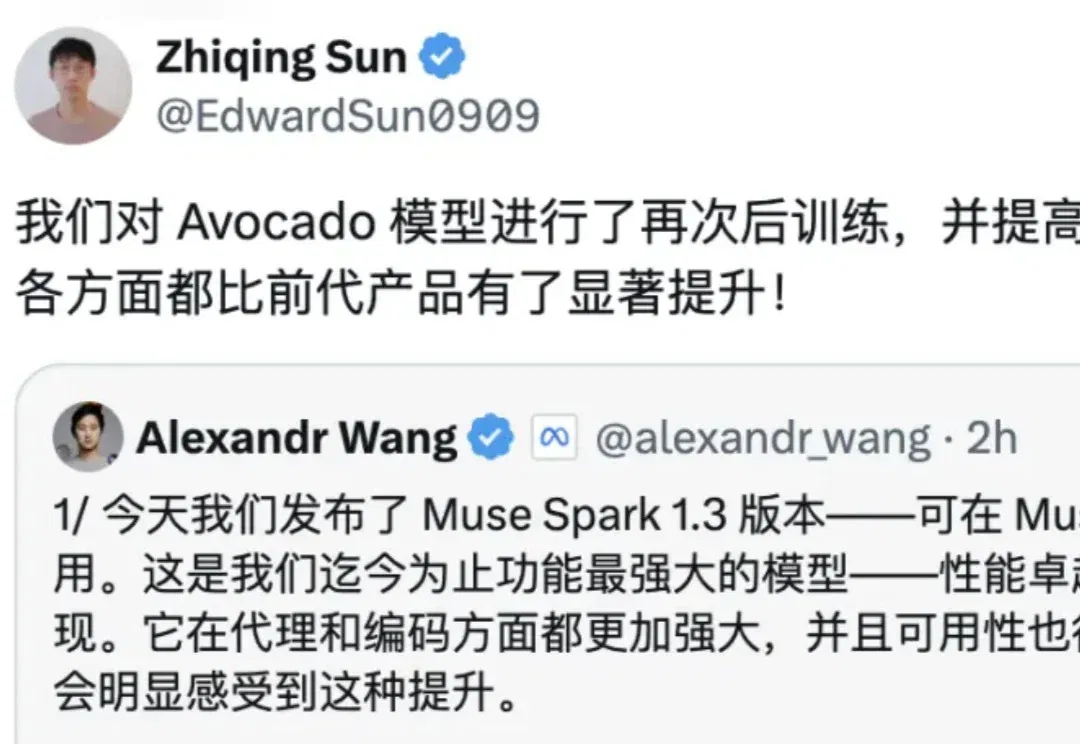
继 Anthropic 和 Google 接连更新模型之后,Meta 也加入了本周这场大模型密集发布潮。
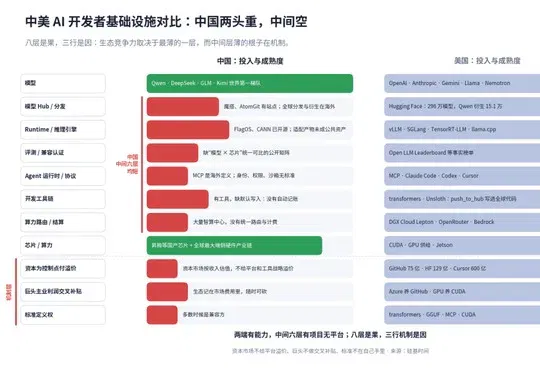
模型是中国做的,为什么后面的数千次创新发生在海外开发者平台?从模型分发、开发者工具到算力路由,中国缺的不是技术,是默认路径。如果只看结论,读完下面五条摘要即可;后文是证据、机制和行动方案。