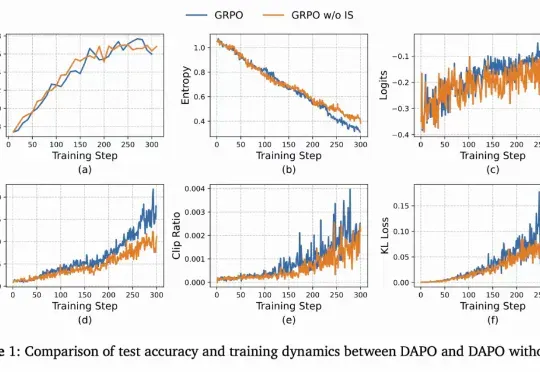
「重要性采样」并不「重要」?快手清华ASPO攻克重要性采样权重错配 (opens in a new tab)
从ChatGPT到DeepSeek,强化学习(Reinforcement Learning, RL)已成为大语言模型(LLM)后训练的关键一环。
Total 530 articles
从ChatGPT到DeepSeek,强化学习(Reinforcement Learning, RL)已成为大语言模型(LLM)后训练的关键一环。
小米的最新大模型科研成果,对外曝光了。就在最近,小米AI团队携手北京大学联合发布了一篇聚焦MoE与强化学习的论文。而其中,因为更早之前在DeepSeek R1爆火前转会小米的罗福莉,也赫然在列,还是通讯作者。
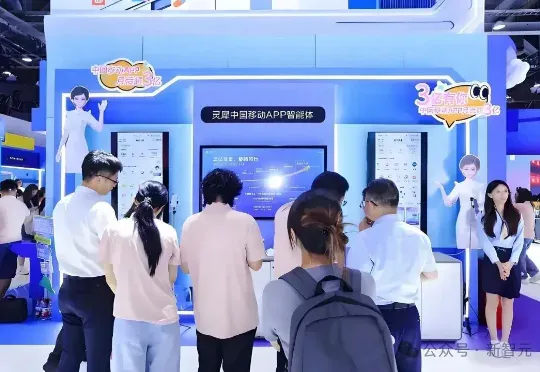
从「深蓝」到ChatGPT和DeepSeek,AI已从棋盘上的较量转向生产力革命。中国移动以自研「九天」大模型为核心,打造「灵犀智能体」,一个能理解意图、主动服务的全场景生活助手。通过「灵犀贴贴」实现AI+NFC的便捷交互。同时「爱购商城」以「AI豆」构建统一价值体系,打通通信、消费与智能生态,为用户提供个性化、温度化的智能生活新范式。
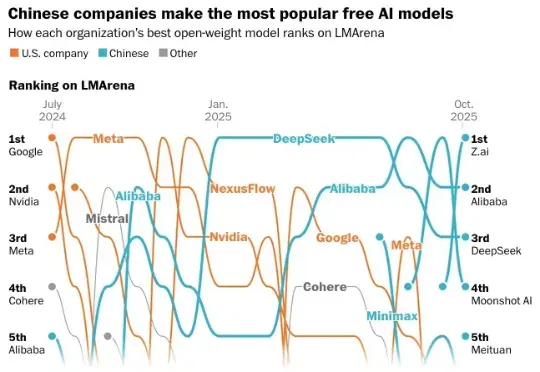
开源大模型,进入中国时间。 10月,公开数据显示,来自中国的开源大模型已经牢牢占据榜单前五。 阿里的Qwen系列和DeepSeek,更是从2024年下半年起,就在开源社区构建起越来越深远的影响力。
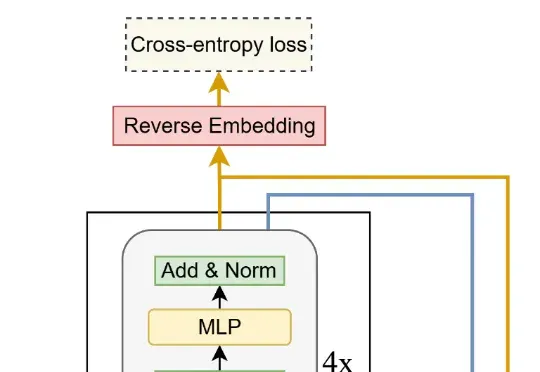
来自加拿大蒙特利尔三星先进技术研究所(SAIT)的高级 AI 研究员 Alexia Jolicoeur-Martineau 介绍了微型递归模型(TRM)。这个 TRM 有多离谱呢?一个仅包含 700 万个参数(比 HRM 还要小 4 倍)的网络,在某些最困难的推理基准测试中,
国庆长假,AI 大模型献礼的方式是一波接一波的更新。OpenAI 突然发布 Sora2,DeepSeek 更新了 V3.2,智谱更新了 GLM-4.6,Kimi 则是更新了 App,然后默默在自己的版本记录里面,写下了这句话。
蚂蚁通用人工智能中心自然语言组联合香港大学自然语言组(后简称“团队”)推出PromptCoT 2.0,要在大模型下半场押注任务合成。实验表明,通过“强起点、强反馈”的自博弈式训练,PromptCoT 2.0可以让30B-A3B模型在一系列数学代码推理任务上实现新的SOTA结果,达到和DeepSeek-R1-0528, OpenAI o3, Gemini 2.5 Pro等相当的表现。
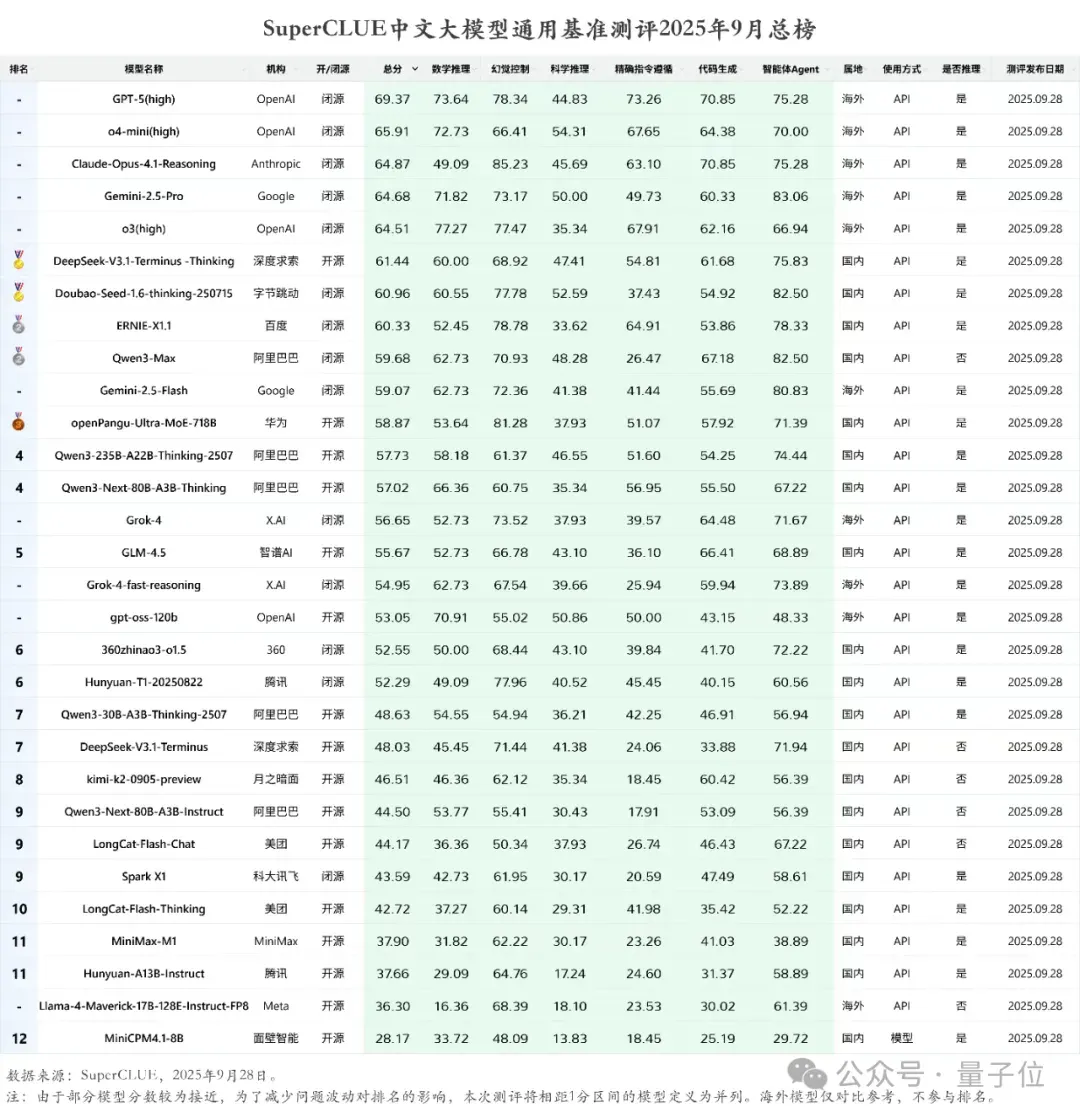
就在最新一期的SuperCLUE中文大模型通用基准测评中,各个AI大模型玩家的成绩新鲜出炉。DeepSeek-V3.1-Terminus-Thinking openPangu-Ultra-MoE-718B Qwen3-235B-A22B-Thinking-2507
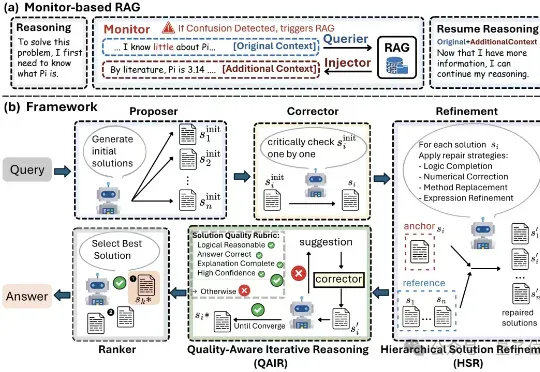
就在最近,由耶鲁大学唐相儒、王昱婕,上海交通大学徐望瀚,UCLA万冠呈,牛津大学尹榛菲,Eigen AI金帝、王瀚锐等团队联合开发的Eigen-1多智能体系统实现了历史性突破
AI应用的争夺战,打到哪儿了? 如果把整个AI行业想象成一座金矿:基础设施层(芯片、算力)相当于“卖铲子”,提供挖矿的基础工具;模型层(大模型研发)好比“卖地图”,告诉大家哪里有金子;而应用层是直接“下场淘金”,把金子变现。 近两年AI应用的使用者越来越多,QuestMobile数据显示,截止到2025年8月,移动端AI应用用户规模达6.45亿,PC端达2.04亿。其中原生APP亿级应用的平均环比增速1.3%。 何为“AI原生应用”?可以理解为它从设计之初就将AI作为核心驱动力,底层架构、运行逻辑、交互方式和商业模式都围绕AI能力进行创新,豆包、DeepSeek、ChatGPT、Perplex