视觉AI从「会生成」走向「能创作」,RabbitVis探索AI应用新范式 (opens in a new tab)
随着 AI 生图能力不断提升,如何让 AI 真正进入创作流程成为新的行业问题。兔展智能基于 UniWorld-Design 视觉 AI 大模型推出 RabbitVis,尝试推动视觉 AI 从图片生成走向可编辑、可交付的创作流程。
Total 887 articles
随着 AI 生图能力不断提升,如何让 AI 真正进入创作流程成为新的行业问题。兔展智能基于 UniWorld-Design 视觉 AI 大模型推出 RabbitVis,尝试推动视觉 AI 从图片生成走向可编辑、可交付的创作流程。
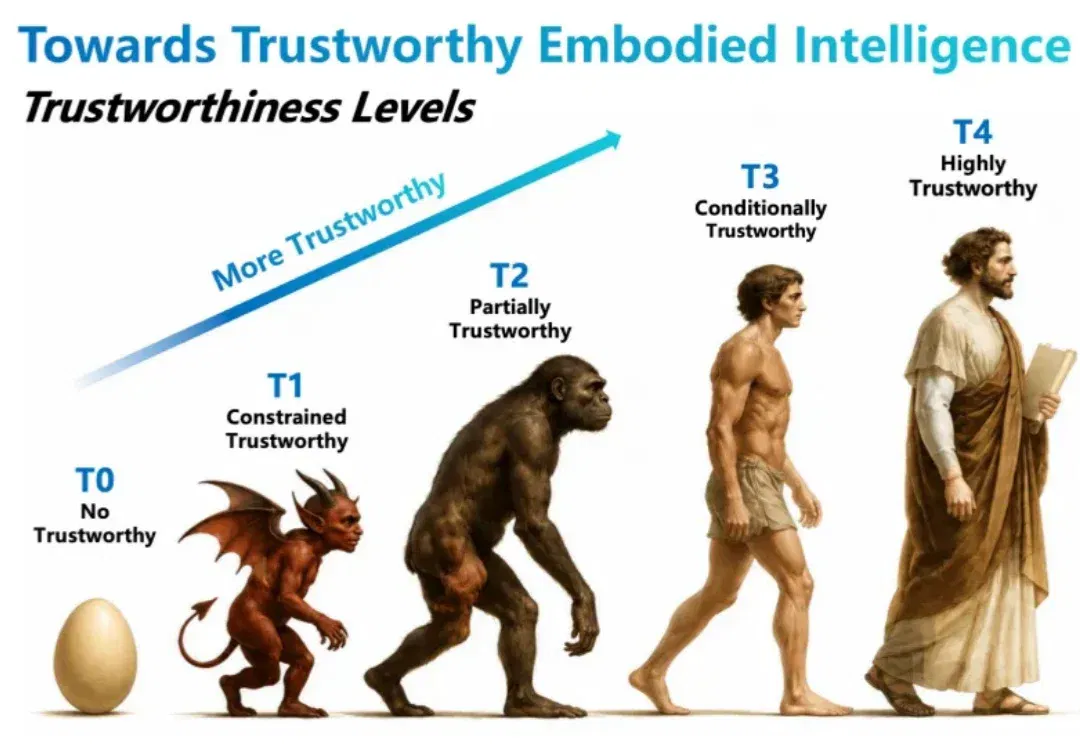
刚刚落幕的2026世界人工智能大会(WAIC)针对人工智能安全的讨论被推到了前所未有的高度。大会《主席声明》明确提出,"要筑牢安全底线、防范滥用恶用,确保人工智能始终处于人类控制之下"。
2026 年 7 月 31 日,迪士尼公司公布了旗下加速器项目(Disney Accelerator)第 12 期名单,入选的 5 家公司都和 AI 密切相关,其中包括具身智能公司 FieldAI、Physical Intelligence(简称 PI),以及 3 家生成式 AI 公司。
文图音视频一把抓。 智东西8月3日报道,今日,MiniMax正式开源新一代通用视频模型MiniMax H3。 MiniMax H3是一个通用型全模态生成系统,可统一理解文本、图像、视频和音频组成的多模态上下文,生成最长15秒、最高2K分辨率并带有原生立体声音频的视频。 此前7月31日,MiniMax H3发布。目前,在Artificial Analysis有声视频编辑榜单中,MiniMax H3以1130分的Elo成绩位列第一,领先Gemini Omni Flash、HappyHorse-1.0、Wan 2.7等国内外视频模型。 ▲MiniMax H3位列有声视频编辑榜单榜首 H3系统由H3-
刚刚,杭州大模型公司西湖心辰宣布,公司近日完成数亿元人民币B+轮融资。该公司创始人蓝振忠,是卡耐基梅隆大学AI博士、自然语言处理预训练语言模型“ALBERT”第一作者,曾任谷歌人工智能研究院科学家,研究成果已被应用于Google News、Google Assistant 等数亿级用户产品中。他于2020年6月受聘于西湖大学,创办深度学习实验室并担任博士生导师。
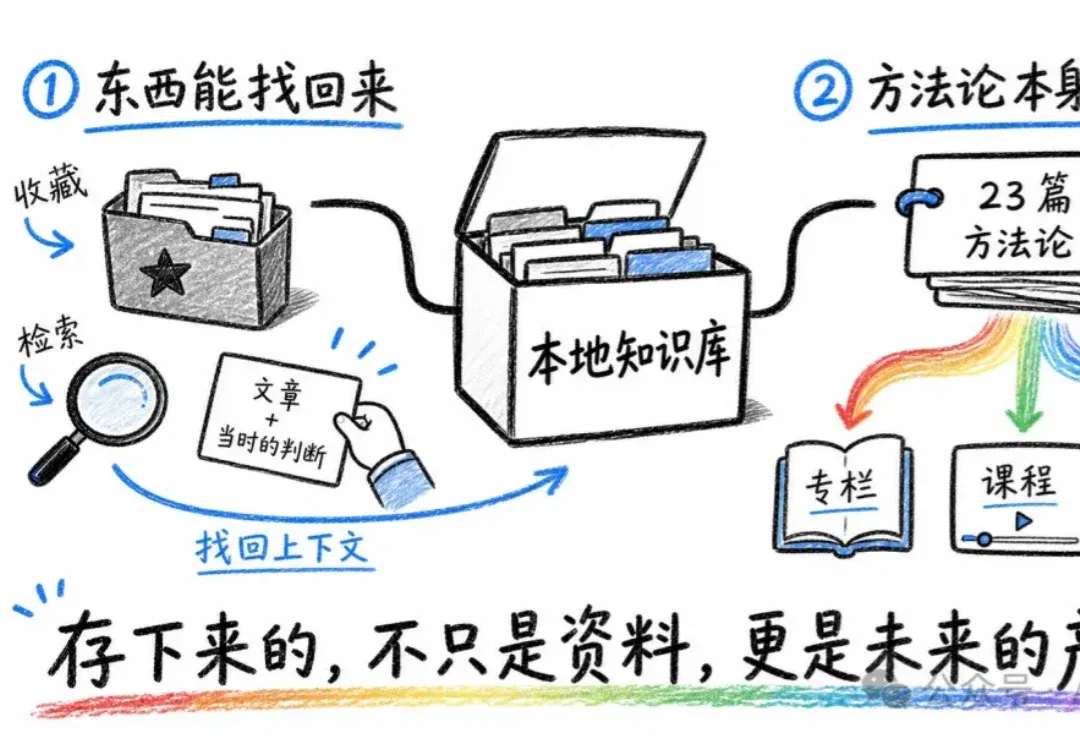
7 月初的时候,我照着 Karpathy 那套 LLM Wiki(简单说就是让 AI 帮你把资料编译成一个能长大的百科)搭了个本地知识库。
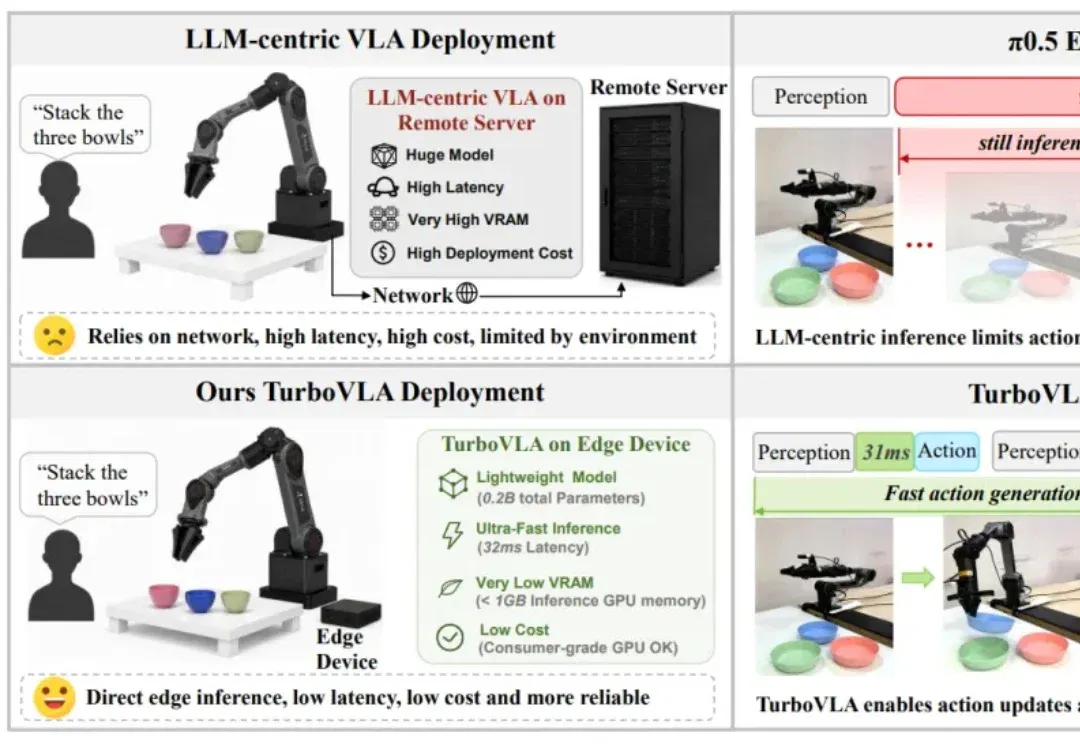
近年来,视觉 — 语言 — 动作模型(Vision-Language-Action Model,VLA)正逐渐成为通用机器人控制的重要技术路线,但当这些模型真正进入高频闭环执行时,一个矛盾越来越突出:模型越来越大、语义能力越来越强,动作更新却未必足够快。
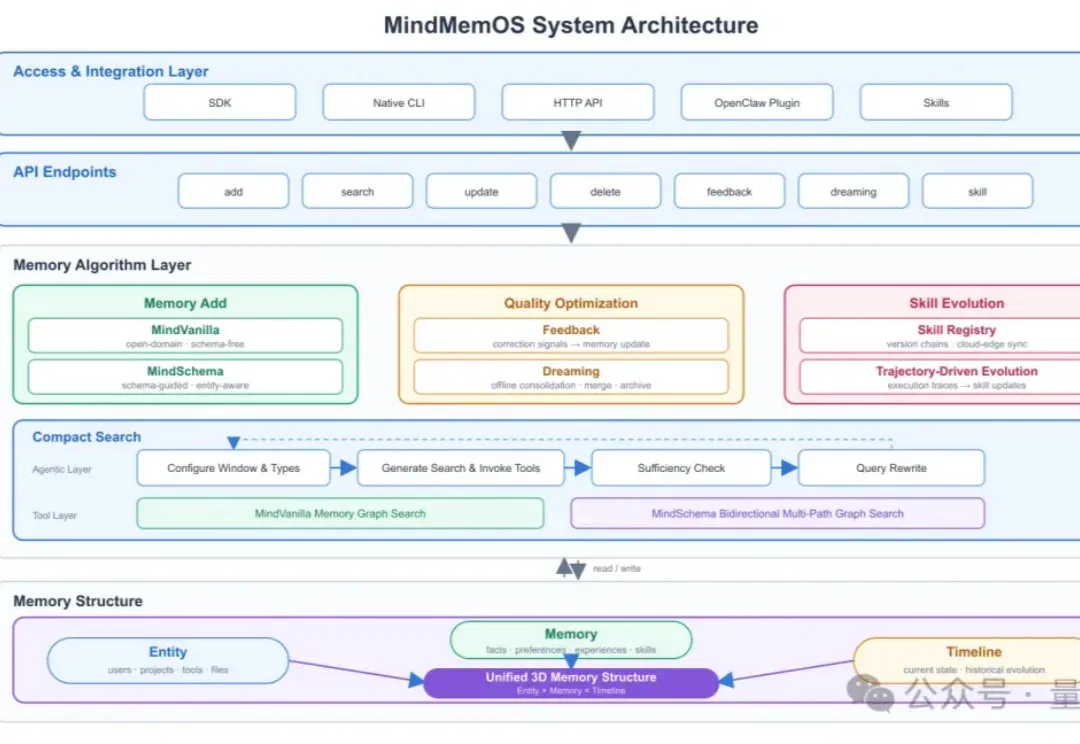
Agent的能力越来越强,但使用体验仍有一个尴尬之处: 每换一个Agent甚至换一个session,就像换了一个完全不了解你的新员工。
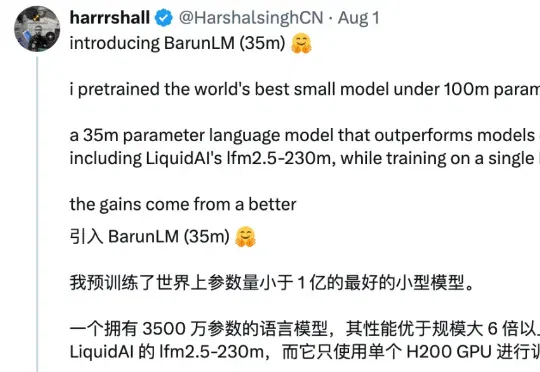
近日,独立开发者 Harshal Singh 公布了一个仅有 3500 万参数的基础语言模型 BarunLM,并声称:「我预训练了世界上参数量小于 100M 的最好模型」。
新智元报道 2026年,AI行业最昂贵的新故事,已经不只是「训练一个更大的模型」。 资本开始直接押注:让AI参与制造下一代AI。 4月,AlphaGo核心缔造者David Silver创办的 Inef