
把RoPE扔掉,AI更能看懂长上下文!Transformer作者团队开源大模型预训练新方法 (opens in a new tab)
针对大模型长文本处理难题,Transformer架构的核心作者之一Llion Jones领导的研究团队开源了一项新技术DroPE。
Total 126 articles
针对大模型长文本处理难题,Transformer架构的核心作者之一Llion Jones领导的研究团队开源了一项新技术DroPE。
借鉴人类联想记忆,嵌套学习让AI在运行中构建抽象结构,超越Transformer的局限。谷歌团队强调:优化器与架构互为上下文,协同进化才能实现真正持续学习。这篇论文或成经典,开启AI从被动训练到主动进化的大门。
Transformer 已经改变了世界,但也并非完美,依然还是有竞争者,比如线性递归(Linear Recurrences)或状态空间模型(SSM)。这些新方法希望能够在保持模型质量的同时显著提升计算性能和效率。
最近,网友们已经被AI「手指难题」逼疯了。给AI一支六指手,它始终无法正确数出到底有几根手指!说吧AI,你是不是在嘲笑人类?其实这背后,暗藏着Transformer架构的「阿喀琉斯之踵」……
单Transformer搞定任意视图3D重建!
大模型「灾难性遗忘」问题或将迎来突破。近日,NeurIPS 2025收录了谷歌研究院的一篇论文,其中提出一种全新的「嵌套学习(Nested Learning)」架构。实验中基于该框架的「Hope」模型在语言建模与长上下文记忆任务中超越Transformer模型,这意味着大模型正迈向具备自我改进能力的新阶段。
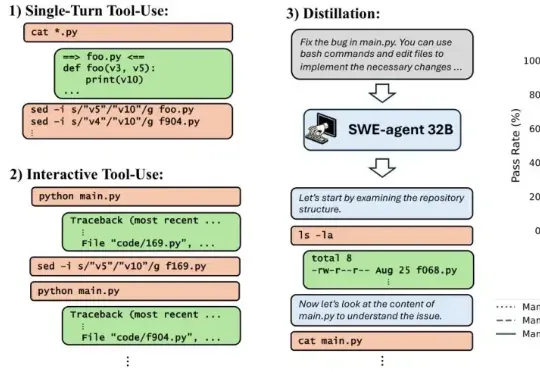
都说苹果AI慢半拍,没想到新研究直接在Transformer头上动土。(doge) 「Mamba+工具」,在Agent场景更能打!
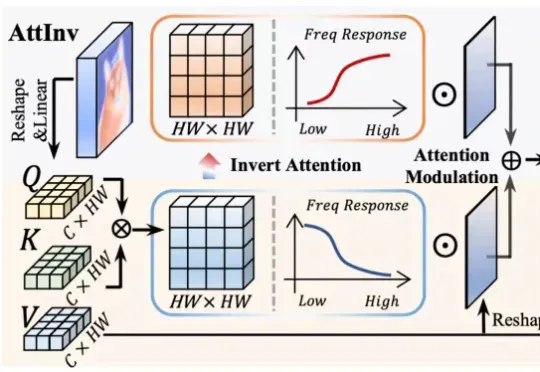
针对视觉 Transformer(ViT)因其固有 “低通滤波” 特性导致深度网络中细节信息丢失的问题,我们提出了一种即插即用、受电路理论启发的 频率动态注意力调制(FDAM)模块。它通过巧妙地 “反转” 注意力以生成高频补偿,并对特征频谱进行动态缩放,最终在几乎不增加计算成本的情况下,大幅提升了模型在分割、检测等密集预测任务上的性能,并取得了 SOTA 效果。
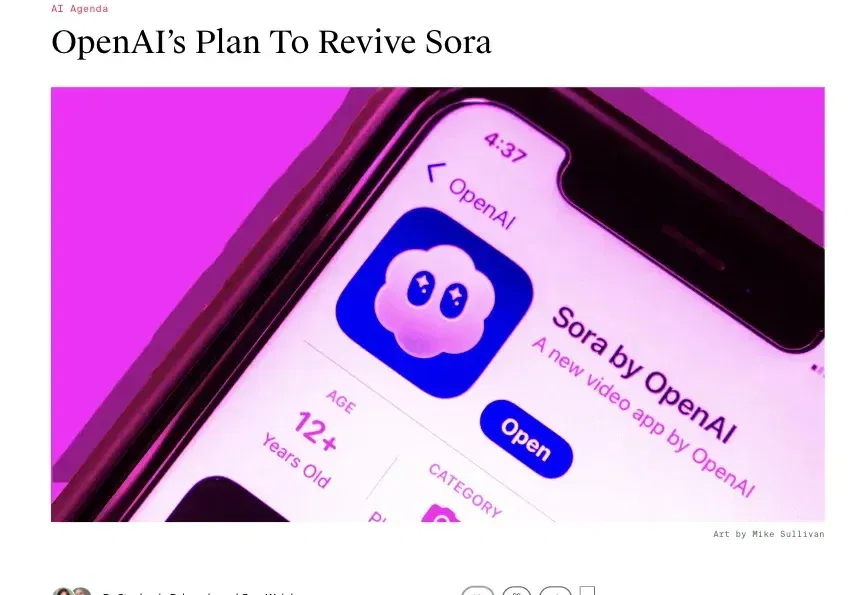
Sora,可能要回来了。 The Information报道称,OpenAI正在与一家新公司谈判,商讨让后者深度使用已经停用的Sora。 而参与这场谈判的人中,正有Sora前研究负责人、DiT(Diffusion Transformer)论文第一作者Bill Peebles。 (DiT为Sora背后的核心技术,Bill Peebles在FAIR实习期间与谢赛宁共同完成) 据悉,Bill Peebles此次携新公司,希望从OpenAI获得对Sora更深入的使用权限,从而进一步开发、定制面向电影制作人的软件和服务。 为此,Bill还拉来了两位重量级合作伙伴:一位是梦工厂动画联合创始人、前迪士尼影业
近日,范鹤鹤(浙江大学)、杨易(浙江大学)、Mohan Kankanhalli(新加坡国立大学)和吴飞(浙江大学)四位老师提出了一种具有划时代意义的神经网络基础操作——Translution。 该研究认为,神经网络对某种类型数据建模的本质是: