多变量神经缩放定律迈向大一统:Mila联手DeepMind提出UNSL (opens in a new tab)
过去的大模型 scaling law 通常回答的是:当模型参数量、数据量和训练计算量增加后,loss 会如何下降。
Total 67 articles
过去的大模型 scaling law 通常回答的是:当模型参数量、数据量和训练计算量增加后,loss 会如何下降。
MiniMax海螺视频团队不藏了!首次开源就揭晓了一个困扰行业已久的问题的答案——为什么往第一阶段的视觉分词器里砸再多算力,也无法提升第二阶段的生成效果?翻译成大白话就是,虽然图像/视频生成模型的参数越做越大、算力越堆越猛,但用户实际体验下来总有一种微妙的感受——这些庞大的投入与产出似乎不成正比,模型离完全真正可用总是差一段距离。
DeepSeek,一口气扩招150人! 啥玩意他们总共也就才300-500人规模,这是要搞大动作啊。 而且这150个HC并非AI研究方向,全部集中到两个岗位:服务端开发工程师、Agent弹性计算研发工程师,重点面向2到10年经验的资深后端开发。 负责人崔添翼解释到,规模大了产生复杂度,复杂度又反过来要求扩大规模。 这是……团队人数的Scaling Law? DeepSeek弹性计算从论文走向大规模工程化 这次的Agent弹性计算研发工程师又分两个方向,平台开发和底层系统。 这个平台指为Agent量身定制的弹性计算平台DSec(DeepSeek Elastic Compute),在不久前发布的D
思考token在精不在多。Yuan 3.0 Flash用RAPO+RIRM双杀过度思考,推理token砍75%,网友们惊呼:这就是下一代AI模型的发展方向!
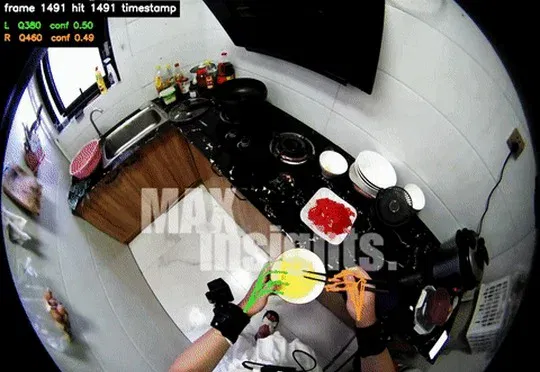
Maxinsights累计交付超200万小时第一人称数据,成为Figure、Genesis AI、Dyna Robotics等硅谷头部具身智能团队的数据基础设施,凭借150万小时高质量数据存量与全链路算法处理能力推动具身智能Scaling Law持续验证。
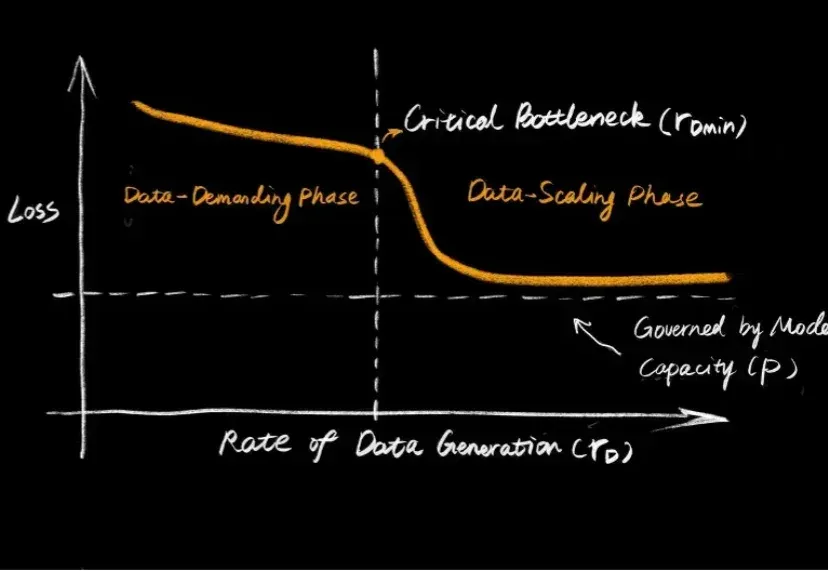
大语言模型的爆发,让大家见证了 Scaling Law 的威力:只要数据够多、算力够猛,智能似乎就会自动涌现。但在机器人领域,这个公式似乎失效了。
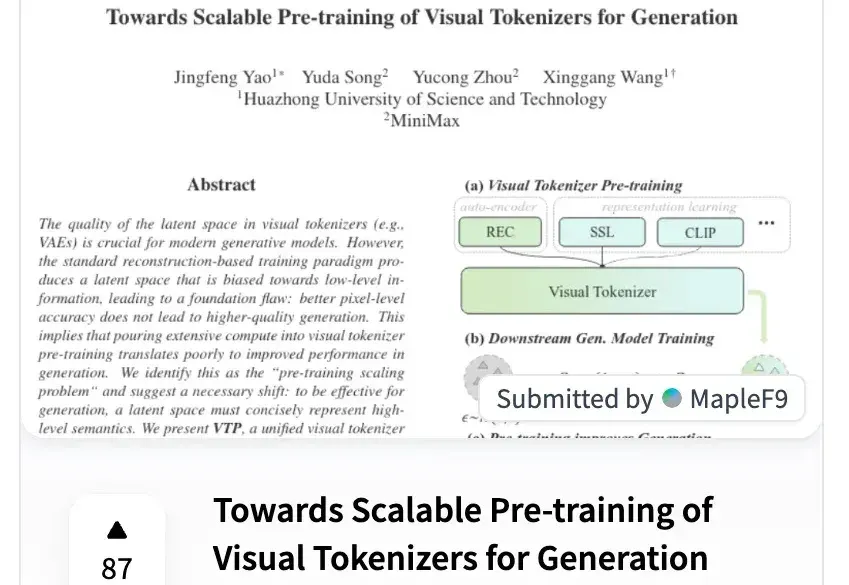
2025 年还有一周结束,年底,AI 视频圈又卷起来了。
最近,工业界“RAG已死”甚嚣尘上。过去几年,AI领域的主旋律是“规模定律”(Scaling Law),即更大的模型、更多的数据会带来更好的性能。即便偶然有瑕疵,也认为只是工程上的不足,并非数学上的不可能。
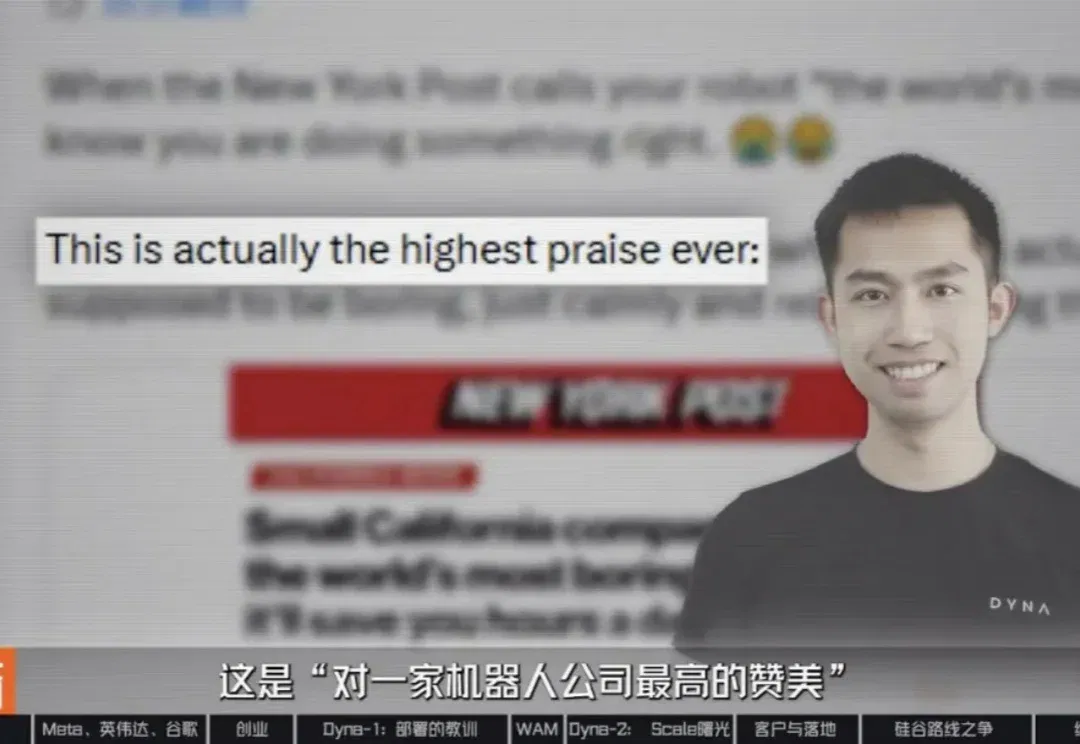
“全世界最无聊的机器人。”这是最近《纽约邮报》的一篇报道标题,而这家公司的创始人们却认为,这是“对一家机器人公司最高的赞美”,这家公司叫Dyna Robotics。

近日,机器人圈知名播客节目 RoboPapers 更新了一期专访,对象是光轮智能创始人兼 CEO 谢晨博士。这期节目的采访人是 RoboPapers 播客联合主持人 Michael Cho 和新加坡国立大学(NUS)助理教授 Jiafei Duan。后者是 MolmoAct 系列机器人模型的作者,研究方向正是机器人基础模型与可扩展数据采集。