开源免费!推荐一款基于DeepSeek大模型RAG知识库与知识图谱平台,打通飞书、企业微信、钉钉 (opens in a new tab)
语析Yuxi-Know 是基于大模型RAG知识库与知识图谱技术构建的智能问答平台,支持多种知识库文件格式,如PDF、TXT、MD、Docx,支持将文件内容转换为向量存储,便于快速检索。
Total 85 articles
语析Yuxi-Know 是基于大模型RAG知识库与知识图谱技术构建的智能问答平台,支持多种知识库文件格式,如PDF、TXT、MD、Docx,支持将文件内容转换为向量存储,便于快速检索。
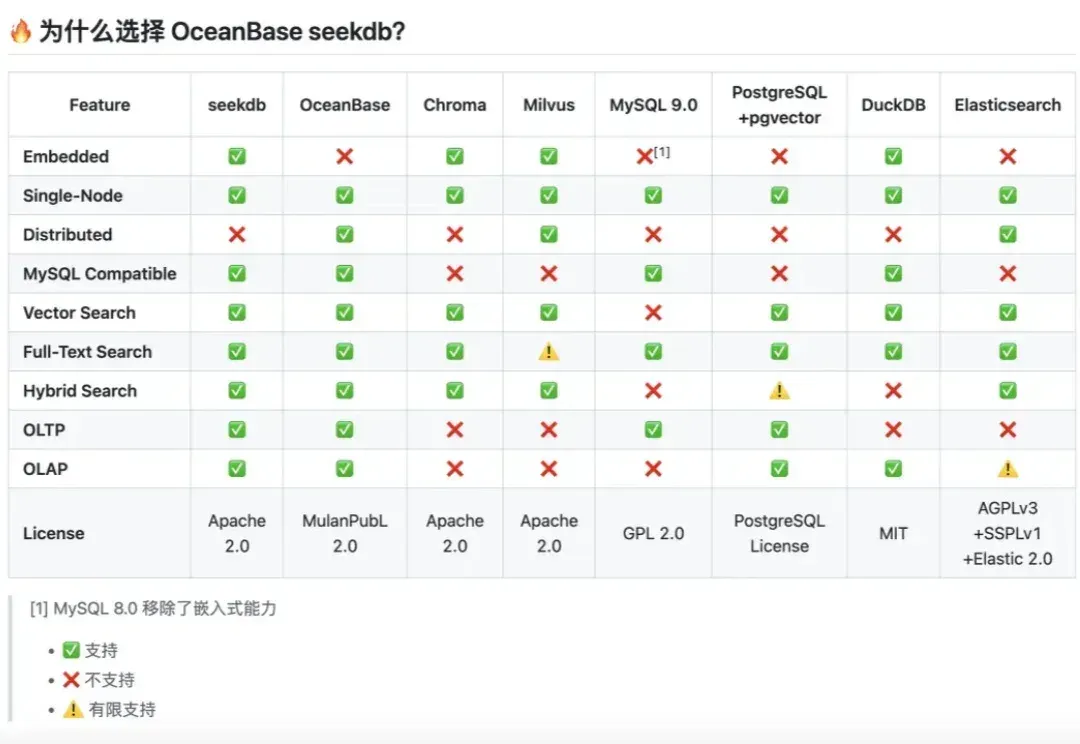
故事得从我们那个行业交流群说起。 群里都是帮搞技术架构的老朋友,平时大家最大的乐趣就是吐槽:吐槽大模型幻觉,吐槽 RAG效果差,分享新的RAG框架。 经常是今天这个说 MySQL 顶不住了,明天那个骂向量库的数据同步又挂了。 大概上个月吧,群里有个做金融项目的技术负责人,突然甩了一个 GitHub 链接出来。 说实话,当时群里刷屏快,我瞥了一眼,心想:“又是个不知名的小开源项目吧。” 毕竟这两年向量数据库赛道太卷了,GitHub 上每天都能冒出好几个号称“拳打 Milvus,脚踢 Pinecone”的新轮子。 大多数都是 Demo 级别的玩具,我手指一滑,准备直接划走。 直到我眼神往下扫,看到
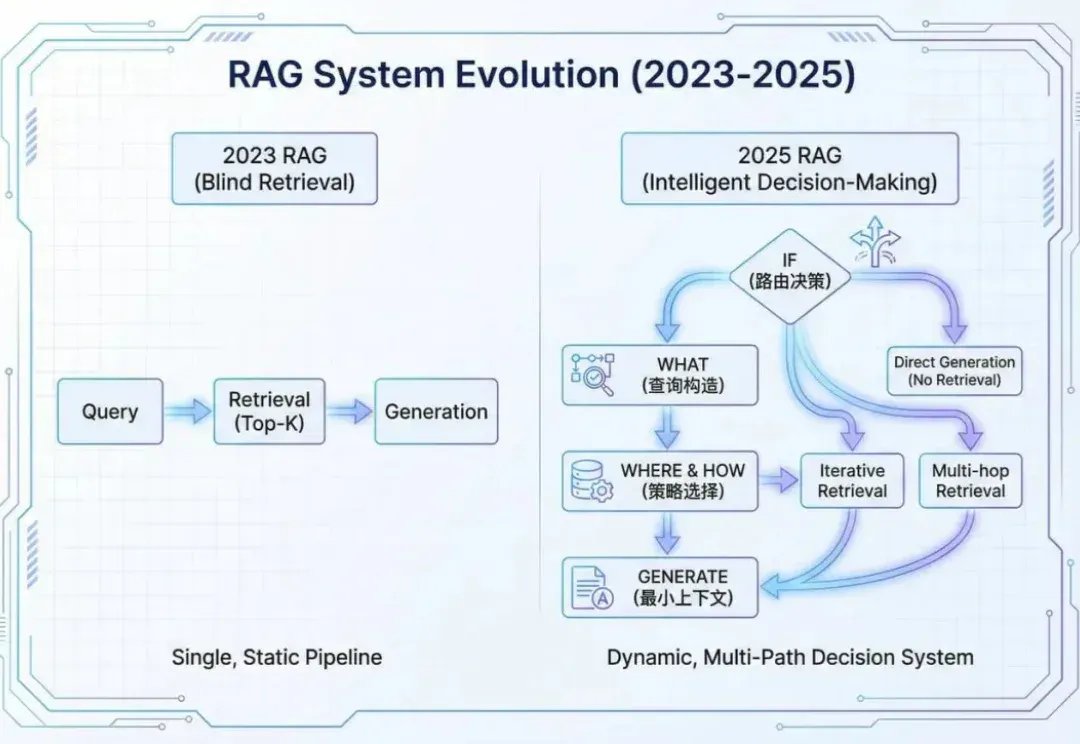
最近一年,互联网上各种为RAG赛博哭坟的帖子不胜枚举。
在检索增强生成中,扩大生成模型规模往往能提升准确率,但也会显著抬高推理成本与部署门槛。CMU 团队在固定提示模板、上下文组织方式与证据预算,并保持检索与解码设置不变的前提下,系统比较了生成模型规模与检索语料规模的联合效应,发现扩充检索语料能够稳定增强 RAG,并在多项开放域问答基准上让小中型模型在更大语料下达到甚至超过更大模型在较小语料下的表现,同时在更高语料规模处呈现清晰的边际收益递减。
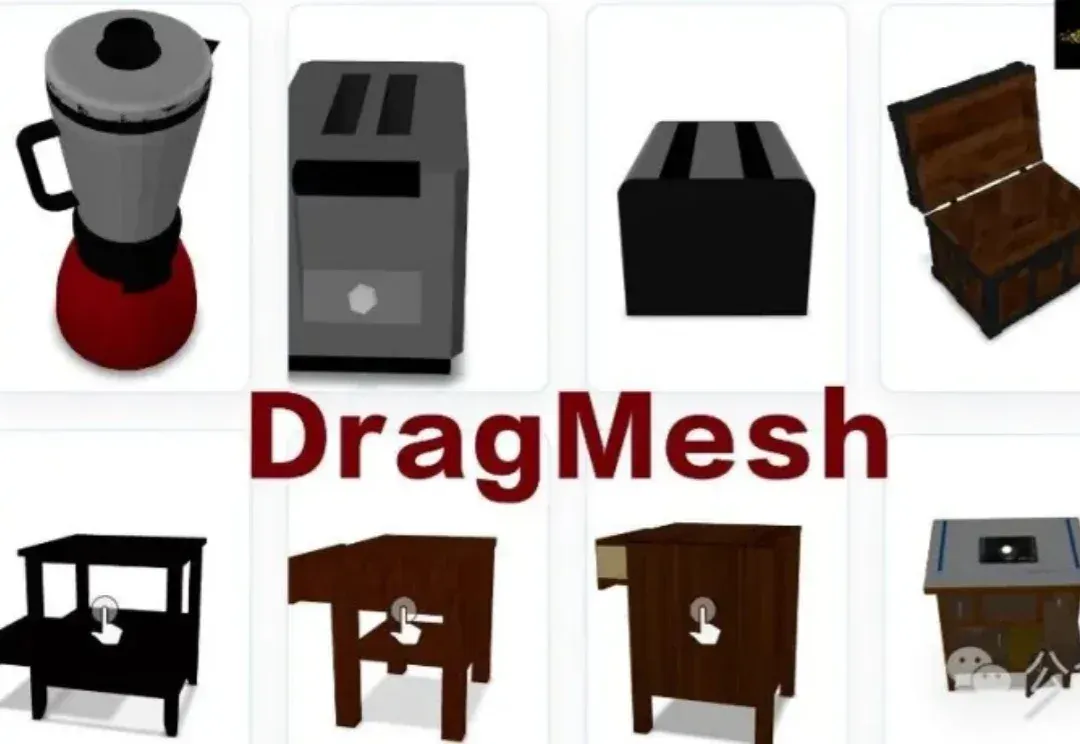
让静态3D模型「动起来」一直是图形学界的难题:物理模拟太慢,生成模型又不讲「物理基本法」。近日,北京大学团队提出DragMesh,通过「语义-几何解耦」范式与双四元数VAE,成功将核心生成模块的算力消耗降低至SOTA模型的1/10,同时将运动轴预测误差降低了10倍。
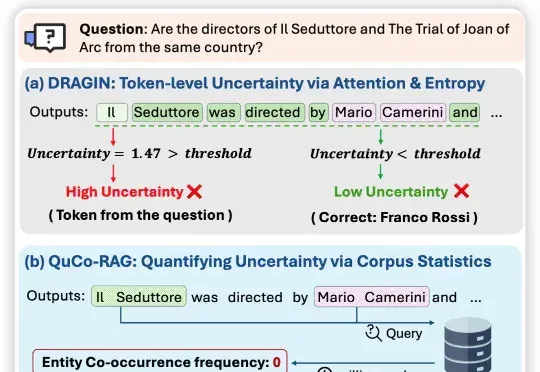
近日,来自伊利诺伊大学芝加哥分校、纽约大学、与蒙纳士大学的联合团队提出QuCo-RAG,首次跳出「从模型自己内部信号来评估不确定性」的思维定式,转而用预训练语料的客观统计来量化不确定性,
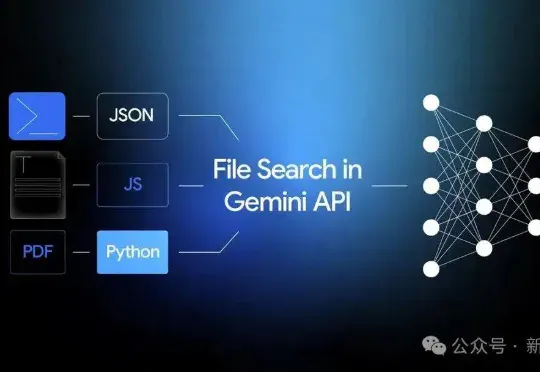
Google宣判RAG死刑!那条曾让无数工程师自豪的技术链,如今只剩下一行API调用。Gemini的File Search,把检索、分块、索引、引用,全都封进了模型内部。开发者不再需要理解流程,只需要上传文件。当智能被自动化吞并,工程师第一次发现,自己也成了被自动化的一部分。
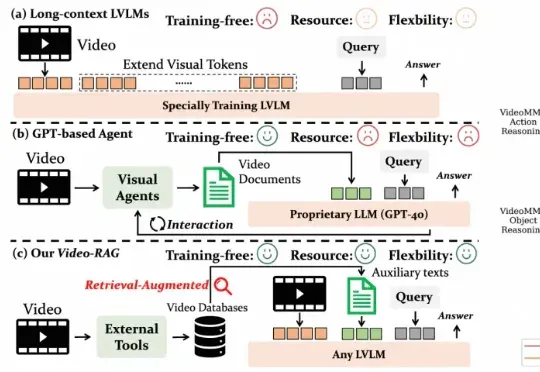
尽管视觉语言模型(LVLMs)在图像与短视频理解中已取得显著进展,但在处理长时序、复杂语义的视频内容时仍面临巨大挑战 —— 上下文长度限制、跨模态对齐困难、计算成本高昂等问题制约着其实际应用。针对这一难题,厦门大学、罗切斯特大学与南京大学联合提出了一种轻量高效、无需微调的创新框架 ——Video-RAG。
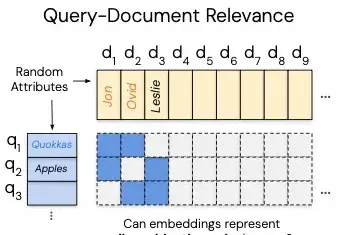
最近,工业界“RAG已死”甚嚣尘上。过去几年,AI领域的主旋律是“规模定律”(Scaling Law),即更大的模型、更多的数据会带来更好的性能。即便偶然有瑕疵,也认为只是工程上的不足,并非数学上的不可能。
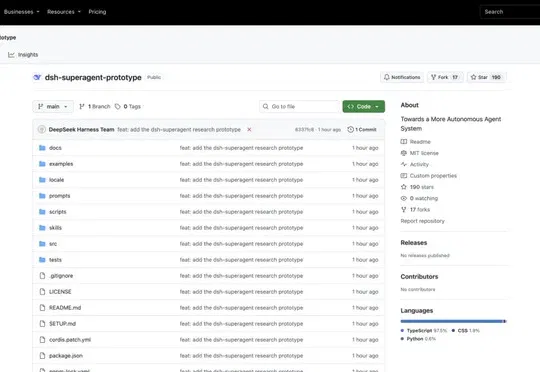
DeepSeek Harness 团队发表技术文章,介绍由 Router 统筹、Worker 执行的 Super-agent 架构,支持跨会话并行、主动响应外部事件和长期在线,并已用于内部研发协作,相关原型 dsh-superagent-prototype 已开源但尚非正式产品。