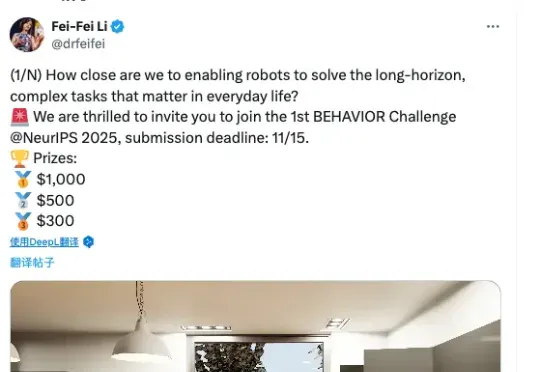
机器人界的「Imagenet 时刻」,李飞飞团队官宣全球顶级具身智能挑战赛 (opens in a new tab)
答案或许渐渐清晰。李飞飞团队与斯坦福 AI 实验室正式官宣:首届 BEHAVIOR 挑战赛将登陆 NeurIPS 2025。这是一个为具身智能量身定制的 “超级 benchmark”,涵盖真实家庭场景下最关键的 1000 个日常任务(烹饪、清洁、整理……),并首次以 50 个完整长时段任务作为核心赛题,考验机器人能否在逼真的虚拟环境中完成真正贴近人类生活的操作。
Total 86 articles
答案或许渐渐清晰。李飞飞团队与斯坦福 AI 实验室正式官宣:首届 BEHAVIOR 挑战赛将登陆 NeurIPS 2025。这是一个为具身智能量身定制的 “超级 benchmark”,涵盖真实家庭场景下最关键的 1000 个日常任务(烹饪、清洁、整理……),并首次以 50 个完整长时段任务作为核心赛题,考验机器人能否在逼真的虚拟环境中完成真正贴近人类生活的操作。
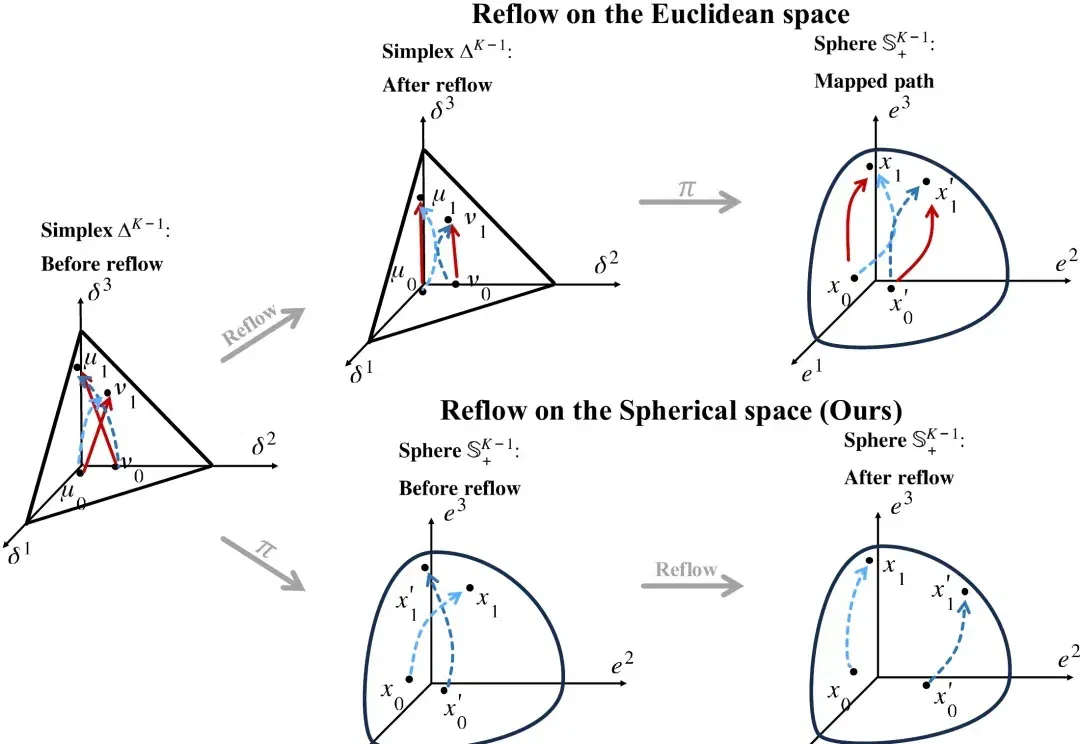
ReSFlow 将单纯形上的概率流映射到球面,以模型自身生成的配对数据进行再训练,再用指数映射完成单步采样。实验覆盖图像、文本似然与DNA序列;单步速度收益需额外训练,且不代表所有质量指标优于完整ODE采样。
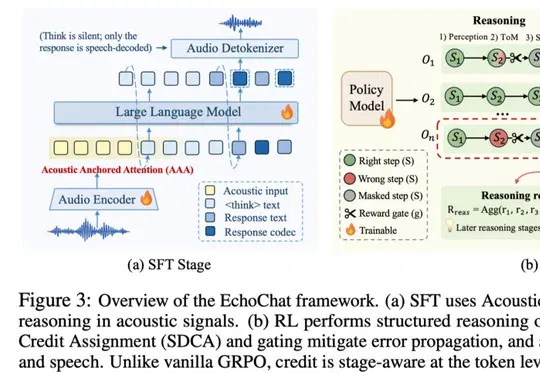
EchoChat将共情语音对话拆分为感知、心智理论推理和回复生成,并通过Acoustic-Anchored Attention与Step-Decomposed Credit Assignment统一优化,在三项评测中取得领先表现。
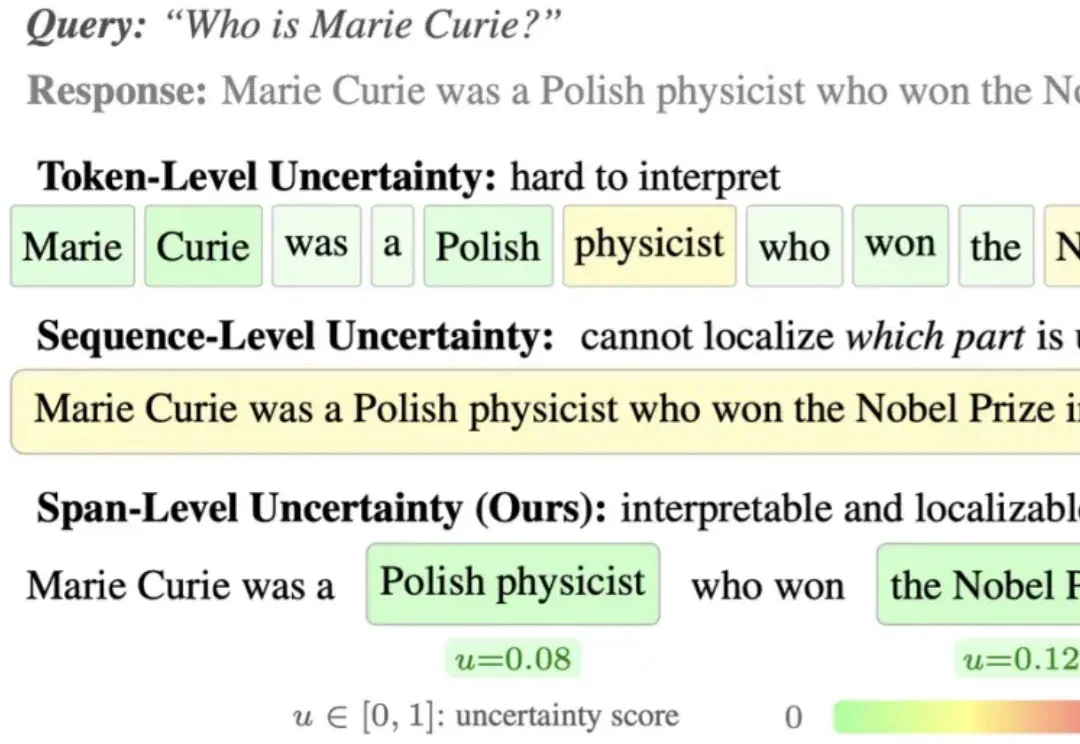
在将 LLM 真正应用到产品的过程中,我们经常会遇到一个看似简单、却非常关键的问题:模型生成的内容,究竟有多可信?
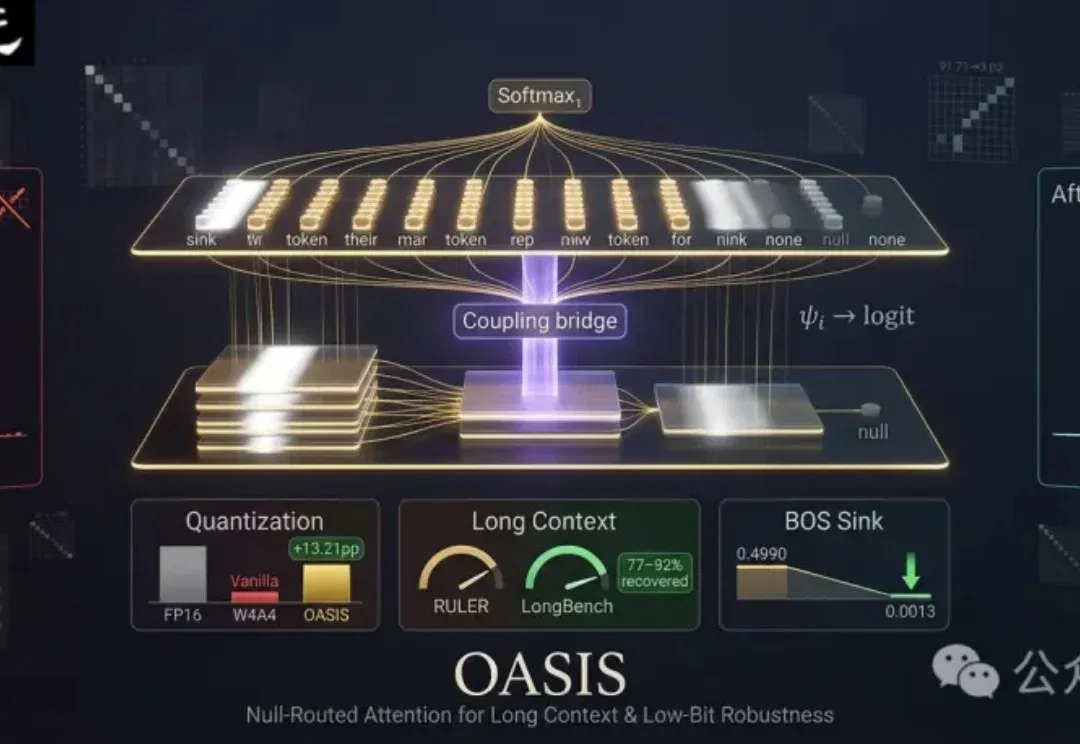
增强模型的表达能力,可以让Transformer更灵活地读取和整合信息。Attention Residuals(AttnResidual)沿着这个方向,将注意力从token之间的信息交互扩展到网络深度,让每个子层学习选择哪些历史层输出。
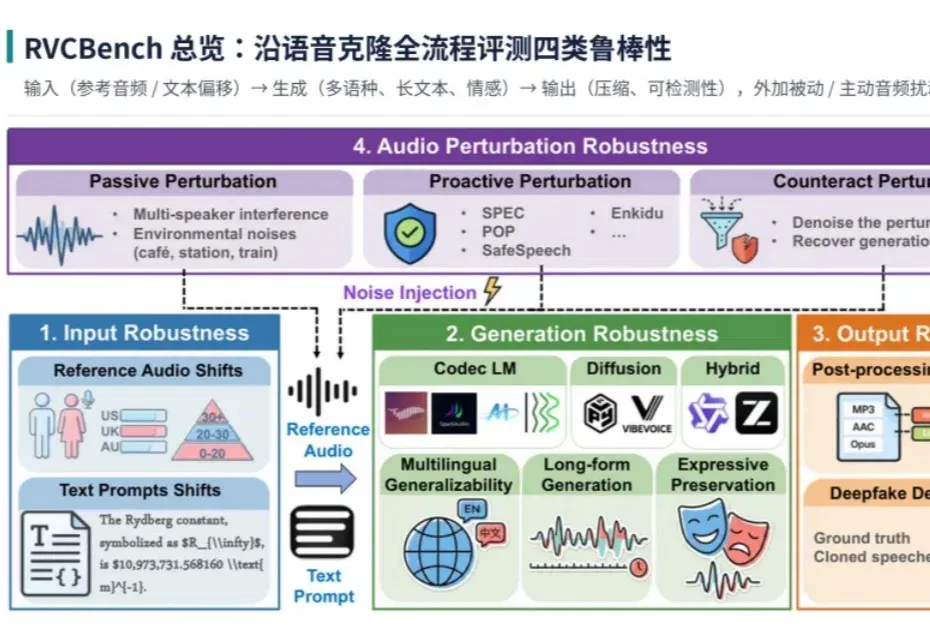
导读:只需几秒参考音频,现代语音克隆模型就能合成与目标说话人高度相似的语音。但真实部署中的参考录音往往带有噪声,文本可能异常、超长或跨语言,生成的语音还要经过压缩和电话传输,有人甚至会给自己的声音加上「防克隆」保护。
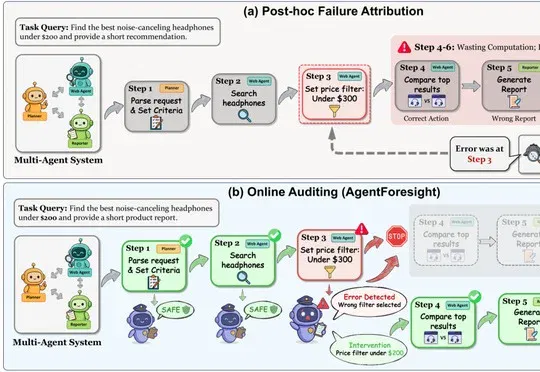
研究团队提出7B审计员AgentForesight,可在多智能体任务运行中在线识别并归因关键错误,其AFTraj-2K Exact-F1达66.44,成功轨迹误报率仅2.37%。
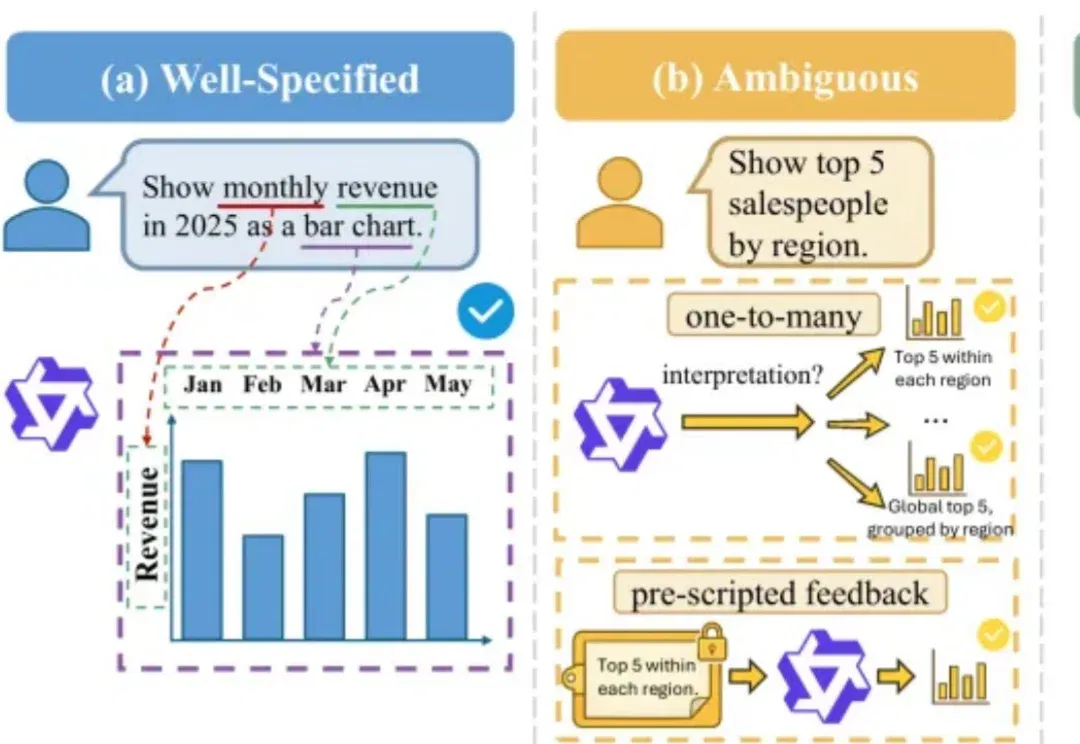
数据要让人看懂,通常得先从数据库里查出来,再画成图。文本到可视化(Text-to-Vis)做的就是这件事:用户说出想看什么,系统去库里查询,再用图表把需要的数据展示出来。
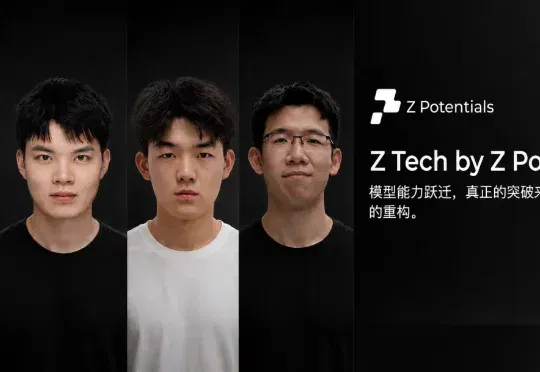
今年,由倪赞林担任第一作者,王慎执、乐洋共同参与的《The Flexibility Trap》获得 ICML 2026 Outstanding Paper Award。ICML 2026 投稿量达到创纪录的 24,000+ 篇,仅评出 2 篇 Outstanding Paper,该论文成为ICML历史上首篇完全由国内单位学者完成的获奖成果,为更好地理解和设计扩散语言模型做出了重要贡献。
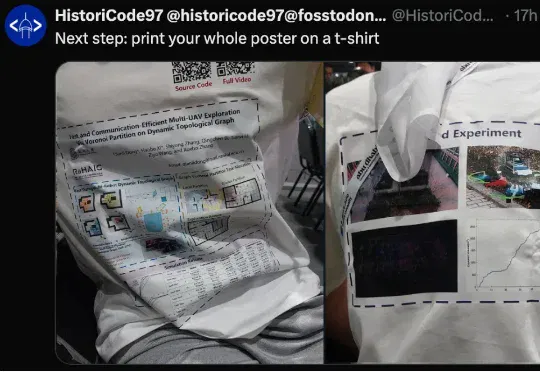
AI 顶会越来越卷了,卷的方向你还猜不到。本周,国际机器学习大会 ICML 在韩国首尔举行。今年 ICML 的 Poster 环节,除了那些极具创新性的论文,也堪称大型学术行为艺术现场。