Fable 5手搓首个CUDA「超级内核」!2.5小时狂飙18.7倍 (opens in a new tab)
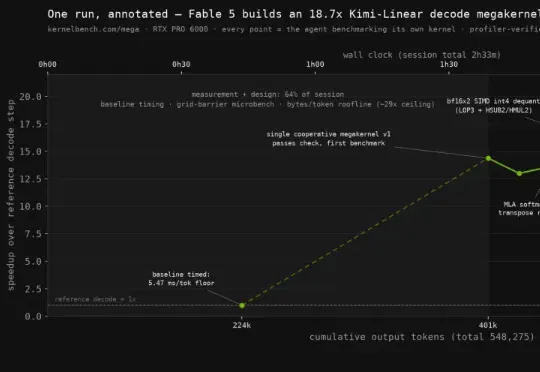
AI竟写出了,史上最快内核!在全新一轮GPU算子基准测试KernelBench-Mega中,Fable 5表现一骑绝尘。它在RTX PRO 6000,全程「纯手搓」CUDA,速度狂飙18.7倍。相比之下,强如Claude Opus 4.8也只跑出14.4倍,而GPT-5.5只有4.34倍。
Total 229 articles
AI竟写出了,史上最快内核!在全新一轮GPU算子基准测试KernelBench-Mega中,Fable 5表现一骑绝尘。它在RTX PRO 6000,全程「纯手搓」CUDA,速度狂飙18.7倍。相比之下,强如Claude Opus 4.8也只跑出14.4倍,而GPT-5.5只有4.34倍。
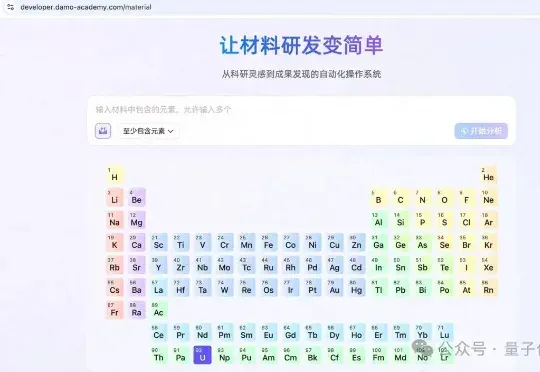
刚刚,阿里达摩院联合中国人民大学高瓴人工智能学院、中国科学院大学等机构,发布了首个专攻超导材料发现的AI智能体“ElementsClaw”(元素虾)。只用了28个GPU小时,ElementsClaw就给已知的240万种稳定晶体统统海选了一遍,预测其中的6.8万种可能是超导体。
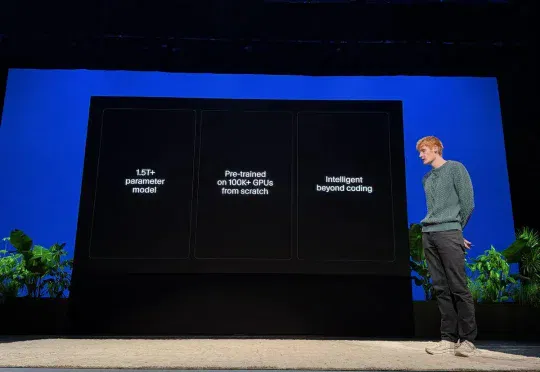
刚刚被 SpaceX 宣布以 600 亿美元收购的 Cursor,发布大模型了。本周二,Cursor 宣布了一个新的 1.5 万亿 + 参数模型,该模型在超过 10 万块 GPU 上进行了预训练。消息是在旧金山举行的 Cursor Compile 上宣布的,这是 Cursor 举办的首届旗舰大会。
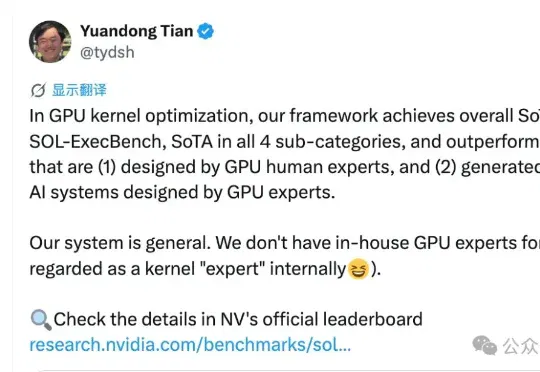
刚刚,田渊栋创业公司,交出了首个研究成果。田渊栋在X上宣布,其创立的Recursive,在NVIDIA官方的GPU kernel优化榜SOL-ExecBench上拿下了整体和四个子类别的SOTA。
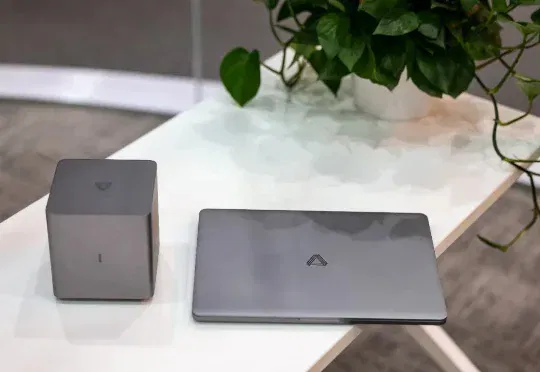
一个做国产 GPU 的公司,在前几天的发布会上,一口气更新了好几款端侧产品,有家庭智能中枢、AI PC、Agent,还有具身智能相关的工作。它叫 MTT AICUBE,按官方说法是「一台面向家庭的 AI 智算中枢」。
老黄在北京喝豆汁「翻车」,全网笑疯了。但真正值得警惕的,是他背后那个正在长出来的「中国版CUDA生态」。从万卡集群到机器狗,从SGLang主线到AI Agent自动迁移,这家公司这次不只是秀芯片,而是在重写国产GPU的游戏规则!
让机器人学会思考。 《AI科技评论》独家获悉,前地平线智能座舱产品线总经理牛建伟,正式创立专注空间大模型的通用具身智能公司「叮当动力」,并已完成数千万元种子轮融资。此轮融资由全球头部智驾科技公司地平线领投,正景基金跟投。 01 明星团队:国产AI芯片量产第一人领衔 叮当动力创始人兼CEO牛建伟是国内首位利用GPU训练深度学习模型的算法专家,也是「国产AI芯片量产第一人」。 牛建伟深耕AI领域十余年,具备深厚的“算法-芯片”的行业复合理解。在2012年百度IDL时期,他率先实现基于 GPU 的深度学习模型训练;同时也是国内首位将深度学习技术应用于语音识别的算法专家,应用于百度语音搜索、语音输入法
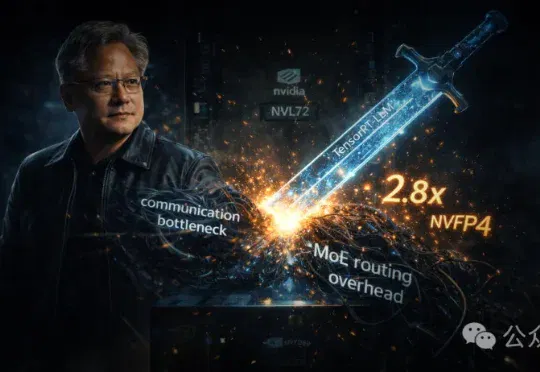
MoE模型的稀疏激活本是优势,却常陷通信瓶颈。NVIDIA以软件为利剑,通过程序化依赖启动和全对全通信革新,在三个月内将GB200的单GPU吞吐提升2.8倍,真正释放Blackwell硬件潜力。
AI算力的VMware时刻:趋动科技与“软件定义GPU”的十年长跑。
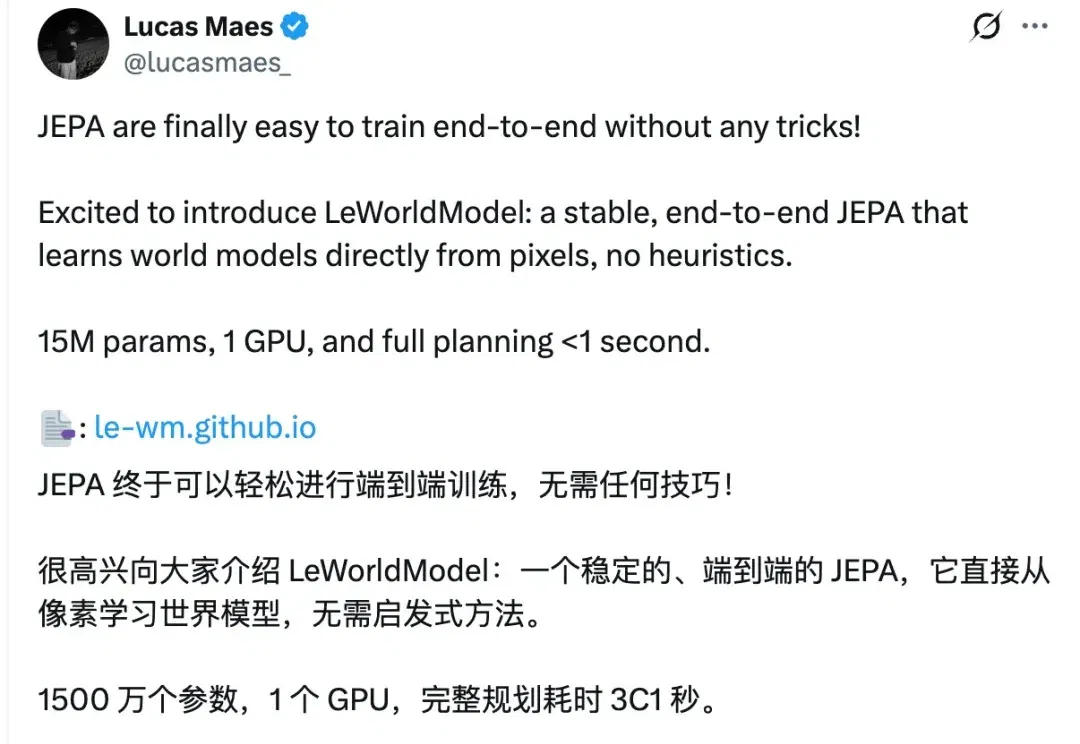
LeCun世界模型最新进展,开源了一套极简训练方案,单GPU就能跑。