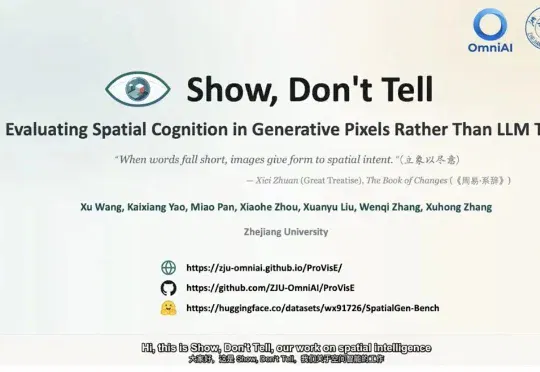
让生成式模型「画」出空间智能,而非强迫LLM输出「坐标」! 浙大提出Agentic空间认知评估框架 (opens in a new tab)
近日,浙江大学 OmniAI 团队在 《Show, Don’t Tell: Evaluating Spatial Cognition in Generative Pixels Rather Than LLM Text》 中提出 ProVisE,让图像生成模型直接在图中回答空间问题,并将视觉答案还原为原 benchmark 可以评分的结构化预测。
Total 63 articles
近日,浙江大学 OmniAI 团队在 《Show, Don’t Tell: Evaluating Spatial Cognition in Generative Pixels Rather Than LLM Text》 中提出 ProVisE,让图像生成模型直接在图中回答空间问题,并将视觉答案还原为原 benchmark 可以评分的结构化预测。
本期播客,No Priors 请来了一位在 AI 推理领域被业内称为「教父级」人物的研究者Noam Brown。他是 OpenAI 的研究科学家,也是推动「test-time compute scaling」成为行业主流方向的关键人物之一。从扑克 AI 到前沿大模型的评估方法论,Brown 的研究轨迹几乎与整个行业对「推理」认知的升级同步。
在大模型在拼命刷 Benchmark 卷编程的时候,「不能说话」的 Jev 却意外成了 AI 圈的新顶流,究其原因,大模型应用的价值正在从「生成什么」,进一步延伸到「能否理解复杂信息,并据此做出可靠判断」。
大模型过去几年的能力跃迁,几乎都围绕一个词:Scaling。
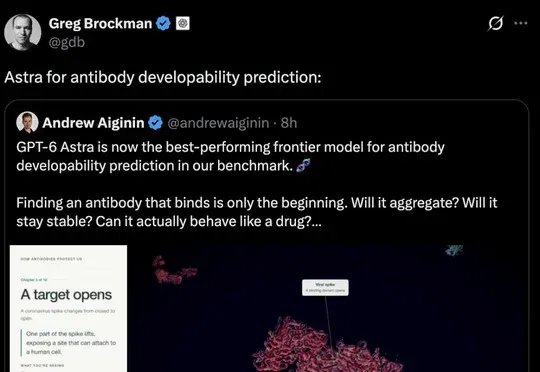
OpenAI发布的GPT-6 Astra在Insilico Medicine构建的DDD Benchmark抗体可开发性预测测试中以37.98分登顶第一,在不依赖外部专用工具的情况下击败所有前沿模型,标志着通用大模型正在突破抗体成药性预测这一生物医药研发的"死亡之谷",成为AlphaFold之后最具震撼性的科学范式转移。

《纽约时报》最新追访,补出了这场冲突中此前没有披露的细节。
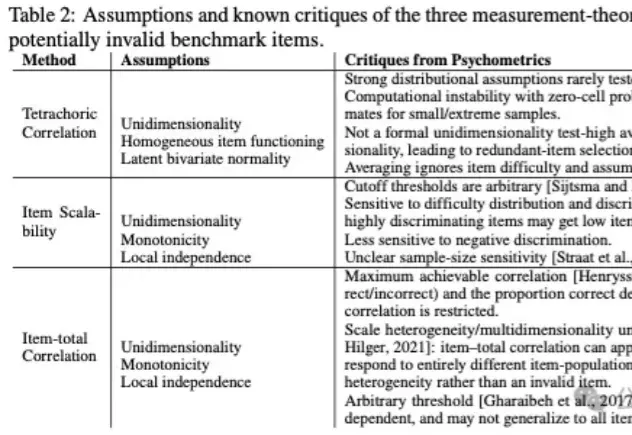
基准测试(Benchmarks)在人工智能的发展进程中扮演着至关重要的角色,构成了评价生成式模型(Generative Models)性能的事实标准。对于从事模型训练与评估的AI研究者而言,GSM8K、MMLU等数据集的数据质量直接决定了评估结论的可靠性。
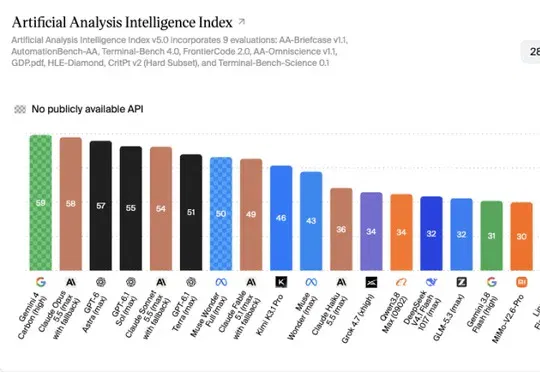
葬 AI 在这篇评论中质疑综合榜单与实际使用体验之间的落差,主张围绕真实任务、速度与成本构建细分评测,并计划发起开源 Benchmark 社区。文章对厂商和榜单的判断具有鲜明个人立场,社区成果仍待陆续发布,不应把评论性归因当作已证实的行业事实。
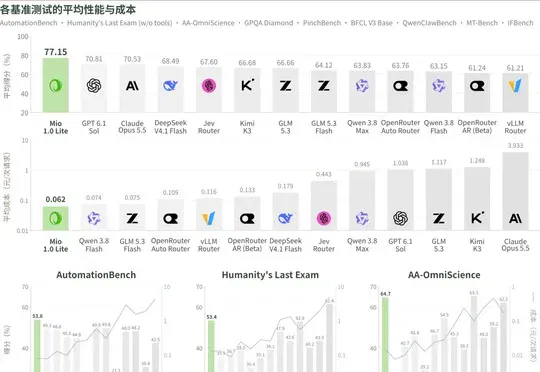
南芥智能发布模型群体智能技术报告,披露Mio 1.0 Lite在9个公开benchmark中平均得分77.15/100居首、平均每请求成本0.06元最低,其SinapisAI平台已公测并收录484个模型。
美国个人AI助理创企Tab公开亮相约六周后估值达3亿美元,但Assistant Benchmark测试显示其预订、旅行和购物任务仍易因网站限制及支付风控失败。