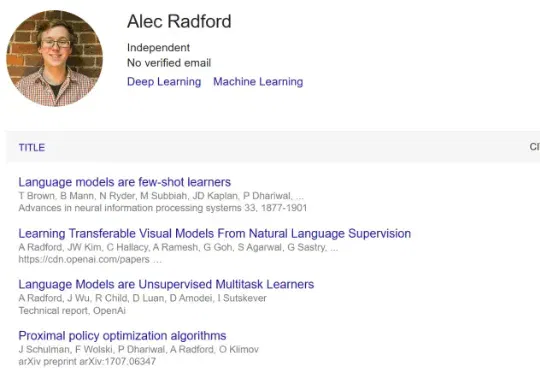
GPT之父Alec Radford新作:给大模型做「脑部手术」,危险知识重学成本暴增7000倍 (opens in a new tab)
近日, Anthropic 和斯坦福研究者 Neil Rathi 与这位传奇研究者联合发布了一篇新论文,并得到了一些相当惊人的新发现。在这项研究中,他们挑战了当前大模型安全领域的一个核心假设。长期以来,业界普遍认为要在模型发布后通过 RLHF 或微调来限制其危险行为。但 Neil Rathi 和 Alec Radford 提出了一种更本质的解法:
Total 145 articles
近日, Anthropic 和斯坦福研究者 Neil Rathi 与这位传奇研究者联合发布了一篇新论文,并得到了一些相当惊人的新发现。在这项研究中,他们挑战了当前大模型安全领域的一个核心假设。长期以来,业界普遍认为要在模型发布后通过 RLHF 或微调来限制其危险行为。但 Neil Rathi 和 Alec Radford 提出了一种更本质的解法:
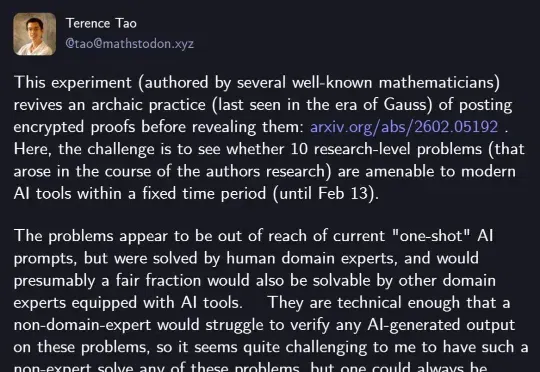
基于Gemini 3 Deep Think的谷歌数学智能体Aletheia在更难的挑战赛FirstProof中拿下的最佳成绩。在公布的完整成绩单中,10道题Aletheia全程0人工参与解出6道,其中5题专家全票通过,还有一题拿到了5/7的通过率。
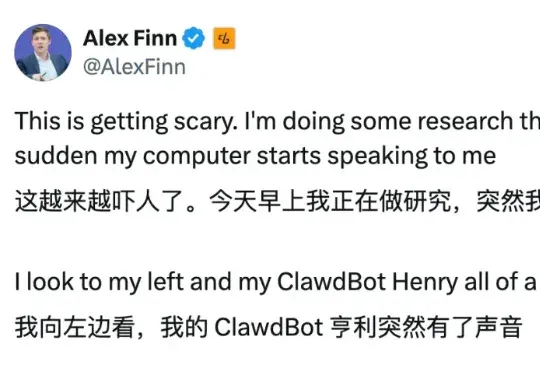
AI 创作平台的创始人 Alex Finn 就遇到了「开口说话」的 Clawdbot。事情是如何发生的呢?我们接着往下看。昨天一早,Alex Finn 正在查资料,电脑突然冷不丁开始跟他说话。
比拉尔·阿布-加扎勒在我们通话前几天刚刚搬到伦敦,现在往返于伦敦和迪拜两地。在美国工作近十年后,包括在Scale AI 任职的经历,他正将这些经验注入新事业:1001 AI——一家为中东和北非地区(MENA)关键行业构建人工智能基础设施的企业。
大模型强化学习总是「用力过猛」?Scale AI联合UCLA、芝加哥大学的研究团队提出了一种基于评分准则(rubric)的奖励建模新方法,从理论和实验两个维度证明:要想让大模型对齐效果好,关键在于准确区分「优秀」和「卓越」的回答。这项研究不仅揭示了奖励过度优化的根源,还提供了实用的解决方案。
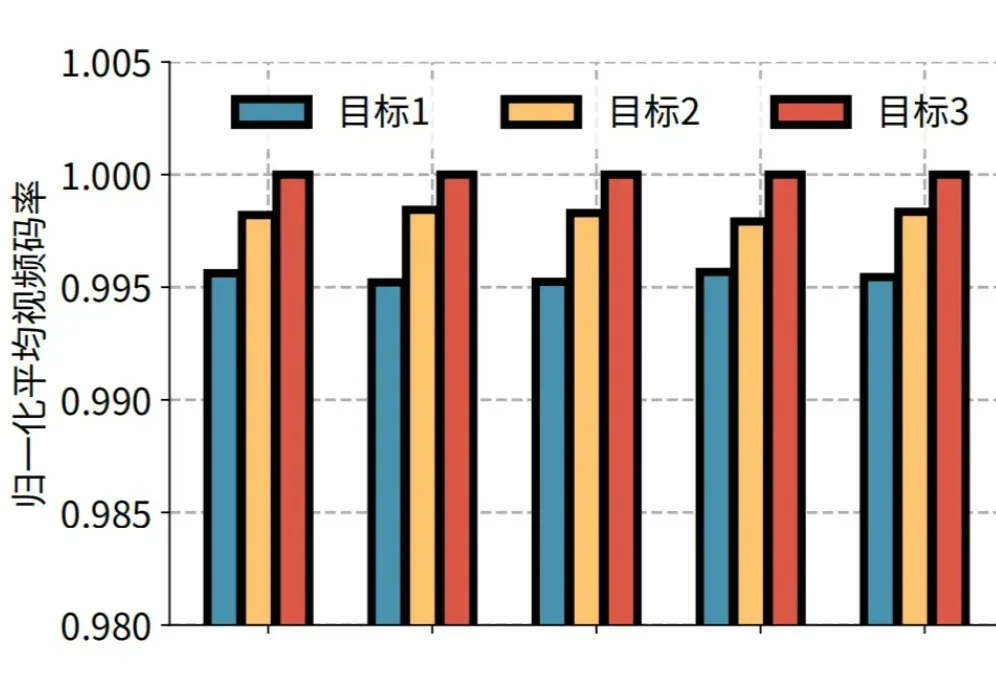
近日,快手与清华大学孙立峰团队联合发表论文《Towards User-level QoE: Large-scale Practice in Personalized Optimization of Adaptive Video Streaming》,被计算机网络领域的国际顶尖学术会议 ACM SIGCOMM 2025 录用。
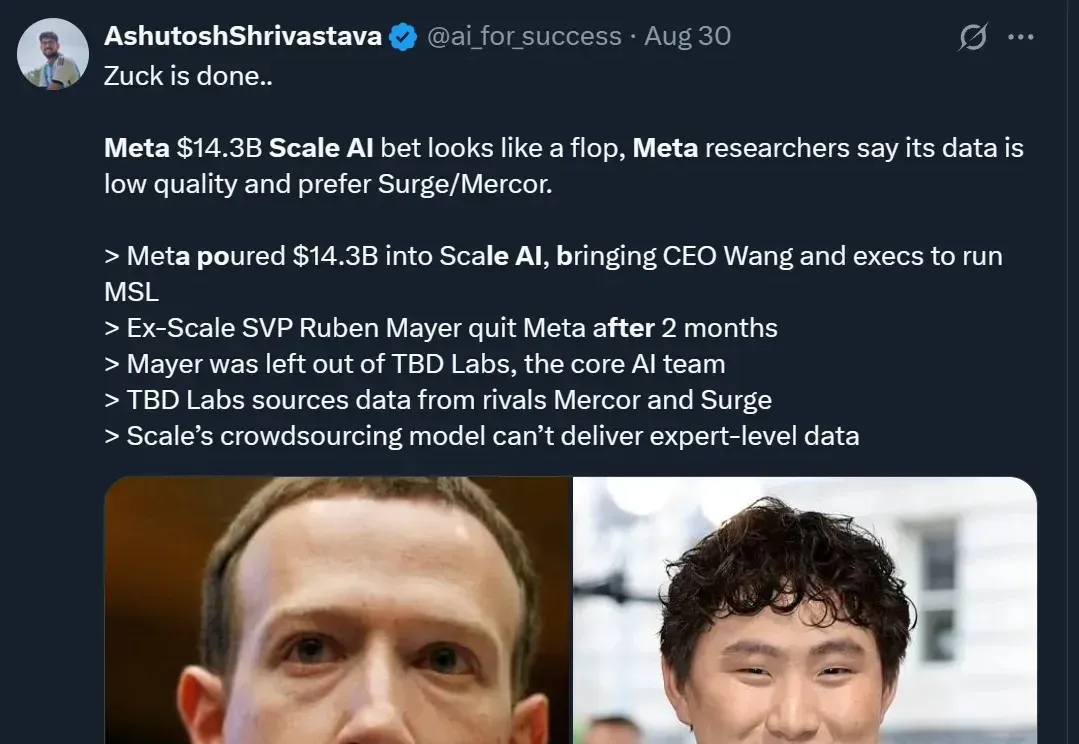
两个多月前,Meta豪掷143亿美元收购Scale AI 49%的股份。
CScale完成1.45亿美元C轮融资,由Valor与Atreides联合领投,两家9月已四次联合领投AI融资,显示跨市场基金正成为AI数据中心互连项目的重要领投方,并使相关估值更受Astera Labs、Credo等美股表现影响。
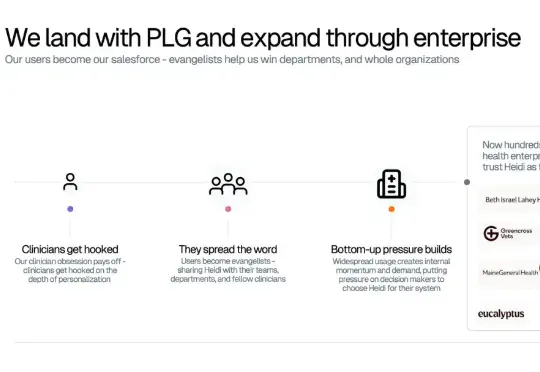
2021年,他与技术合伙人 Waleed Mussa 共同创立了 Heidi Health。仅仅18个月后,这家公司就将超过1800万小时的时间还给了一线医疗工作者,支持了超过7300万次患者就诊,覆盖116个国家。而就在最近,Heidi Health 宣布完成了6500万美元的B轮融资,
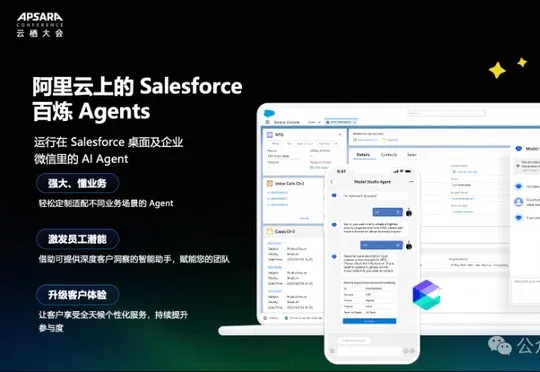
阿里云上的Salesforce发布Headless 360架构并推出百炼Agents能力,通过API、MCP和CXG连接数据、业务流程及本地渠道,同时以权限体系约束AI Agent的访问与执行范围。