从预测万物到自我进化:PhAI Labs提出RSI-Anything,探索通用RSI新路径 (opens in a new tab)
修 Bug、操作计算机、规划实验室操作、优化化学反应,甚至研究复杂的免疫系统。
Total 56 articles
修 Bug、操作计算机、规划实验室操作、优化化学反应,甚至研究复杂的免疫系统。
自现代大模型诞生以来,“下一个Token预测(Next-Token Prediction, NTP)”就被奉为不可撼动的黄金律条。然而,逼着模型逐字死记硬背,真能学会宏观语义规划吗?
数据市场的故事,正在进入新一轮周期。来自企业真实工作流的 Real-world Data,成为越来越多 AI Labs 争夺的新资源。比如 GitHub 就是典型的 Real-world Data,它几乎完整保留了一个问题从出现到解决的全过程。相比之下,今天绝大多数 Human Data 公司提供的,仍是人为构造的数据。
前阿里 Qwen 技术负责人林俊旸的创业公司,有了新消息。据外媒 The Information 援引知情人士的消息,在林俊旸完成的首轮融资中,腾讯投资了 2000 万美元。本轮融资总额达数亿美元,投后估值约 20 亿美元。
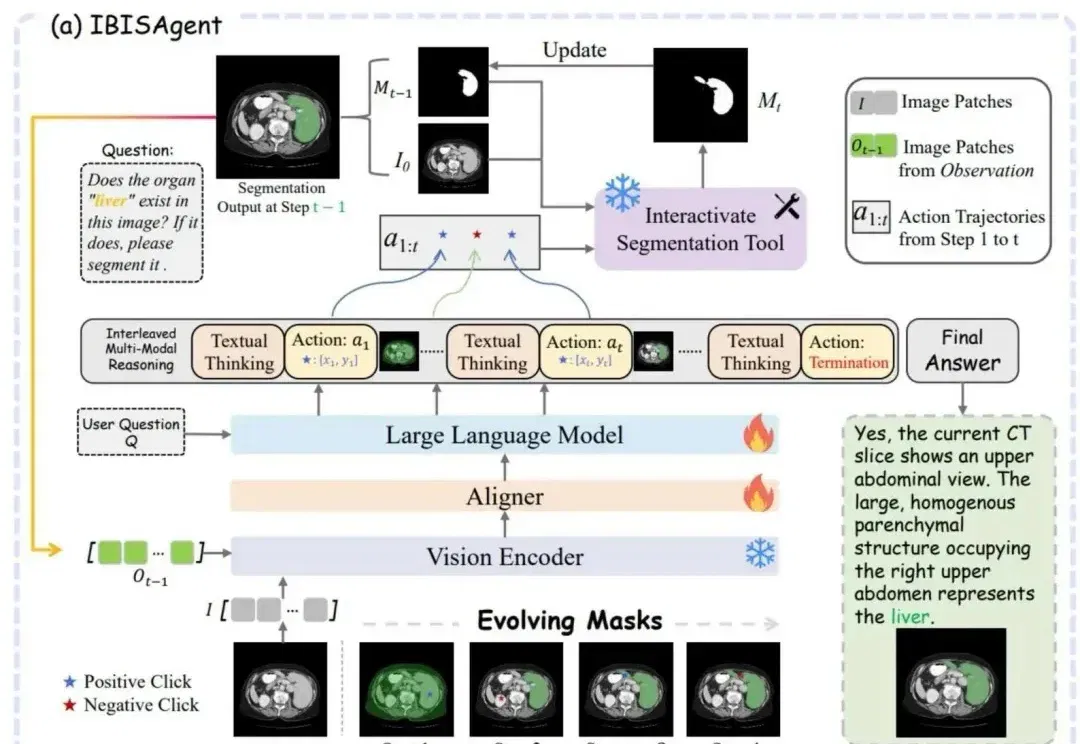
这个生物医学视觉推理框架,被CVPR 2026接收了!
来自上海交通大学、清华大学、微软研究院、麻省理工学院(MIT)、上海 AI Lab、小红书、阿里巴巴、港科大(广州)等机构的研究团队,系统梳理了近年来大语言模型在数据准备流程中的角色变化,试图回答一个业界关心的问题:LLM 能否成为下一代数据管道的「智能语义中枢」,彻底重构数据准备的范式?
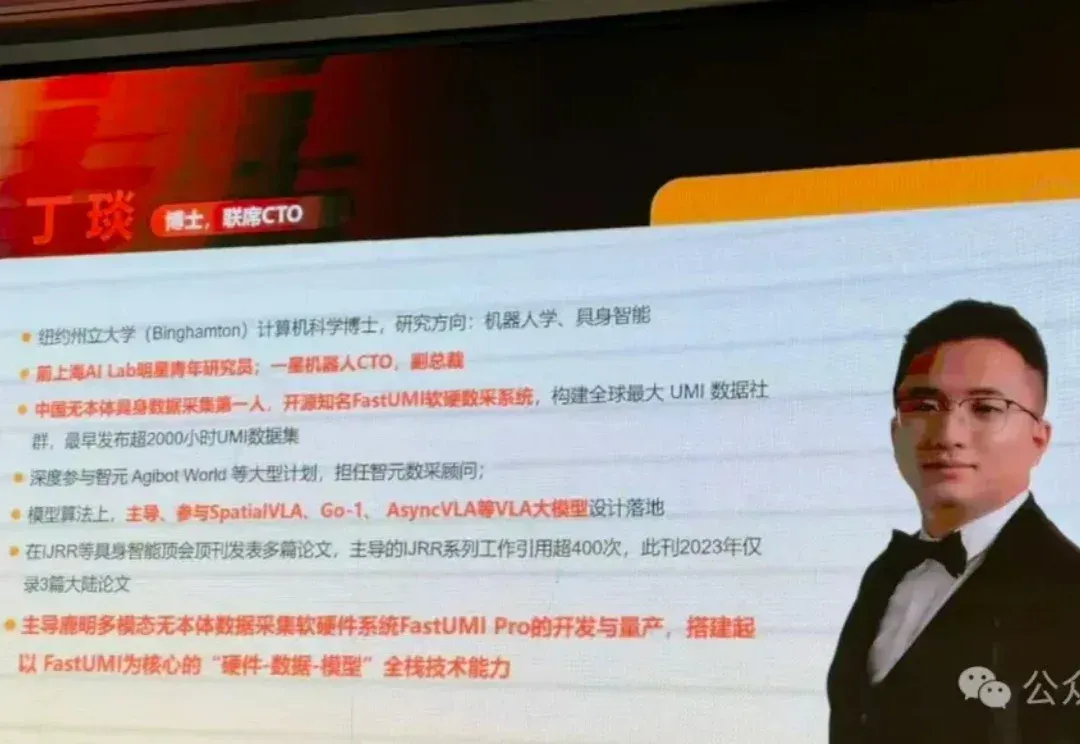
“我们只交付100%可以复现的轨迹。” 具身智能创企鹿明机器人媒体沟通会上,联席CTO丁琰对具身智能数据采集现状、困境,以及最新兴的采集方式UMI作了前沿的深度分享。 他在分享中反复强调,很多团队以为具身模型训不出来是卡在训练阶段,实际多数问题在数据生成的起点就已经埋下了。后面再堆模型、堆算力,只是在给错误输入继续加速。 丁琰的履历能解释他为什么会把“数据的可训练性”看得这么重。 他的研究方向是机器人学与具身智能,2024年3月从美国纽约州立大学计算机学院博士毕业。去年年底加入鹿明之前,他做过一星机器人的CTO,更早则在上海AI Lab担任研究员。 按他的说法,从2024年3月起,他就持续投入
近日,上海人工智能实验室的研究团队提出了一种全新的后训练范式——RePro(Rectifying Process-level Reward)。这篇论文将推理的过程视为模型内部状态的优化过程,从而对如何重塑大模型的CoT提供了一个全新视角:
近日,上海人工智能实验室针对该难题提出全新范式 SDAR (Synergistic Diffusion-AutoRegression)。该方法通过「训练-推理解耦」的巧妙设计,无缝融合了 AR 模型的高性能与扩散模型的并行推理优势,能以极低成本将任意 AR 模型「改造」为并行解码模型。
多模态大模型表现越来越惊艳,但人们也时常困于它的“耿直”。